

利用Scrapy框架21行代码构建Python爬虫实战指南
本文详细介绍如何使用Scrapy框架在PyCharm环境中编写一个仅需21行代码的Python爬虫。通过解析HTML结构定义Item,创建Spider类处理页面数据,并配置Settings以UTF-8编码输出JSON文件。文章还涵盖了运行命令、已知追加数据Bug及定时任务等扩展功能建议,适合初学者快速上手Scrapy基础应用。
2026-10-13
6

本文详细介绍如何使用Scrapy框架在PyCharm环境中编写一个仅需21行代码的Python爬虫。通过解析HTML结构定义Item,创建Spider类处理页面数据,并配置Settings以UTF-8编码输出JSON文件。文章还涵盖了运行命令、已知追加数据Bug及定时任务等扩展功能建议,适合初学者快速上手Scrapy基础应用。
本文详解Python环境下Scrapy框架的安装配置及常见错误解决,并通过两个实例演示如何使用urllib和re模块爬取静态网页图片及处理百度图片滚动加载的反爬虫机制,提供完整代码与注意事项。
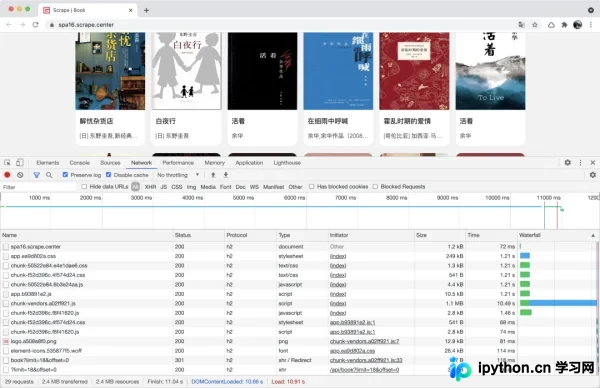
本文介绍一种基于强制HTTP/2.0协议的反爬虫策略。由于主流Python爬虫库如requests仅支持HTTP/1.1,且Scrapy的HTTP/2支持尚为实验性,通过Nginx配置拒绝HTTP/1.x请求可有效拦截大部分自动化脚本。文章详细演示了Nginx及Kubernetes Ingress的配置方法,并通过对比requests、Scrapy与httpx的测试结果,验证了该方案对常规爬虫的阻断效果及合法用户的兼容性。
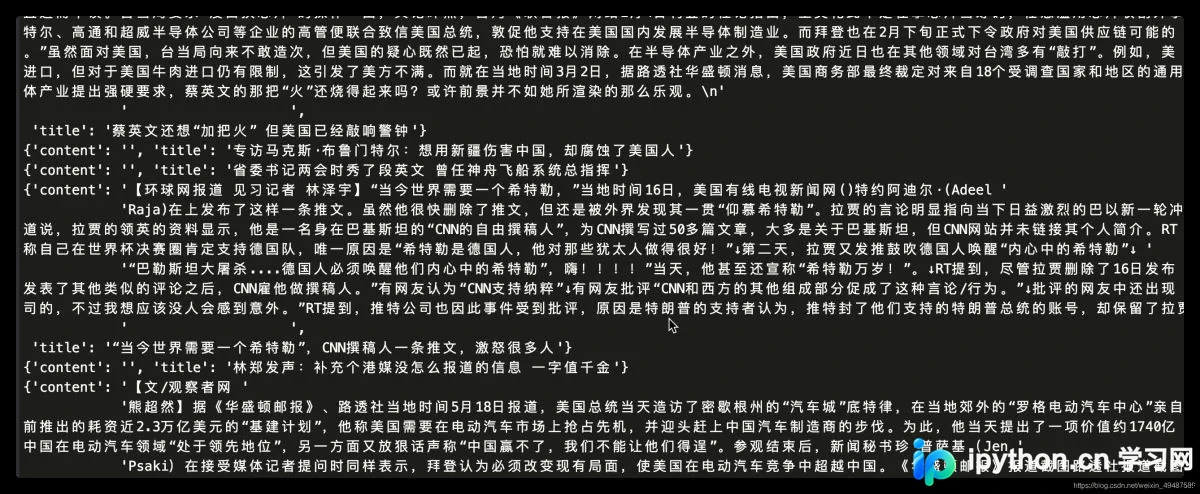
本文详解如何在Scrapy框架中集成Selenium以解决动态加载数据的爬取难题。通过配置Spider与下载中间件,利用浏览器对象执行页面滚动并获取渲染后的HTML源码,成功抓取网易新闻多个版块的动态内容。文章提供了完整的代码实现、配置步骤及注意事项,帮助开发者高效处理复杂动态网页。
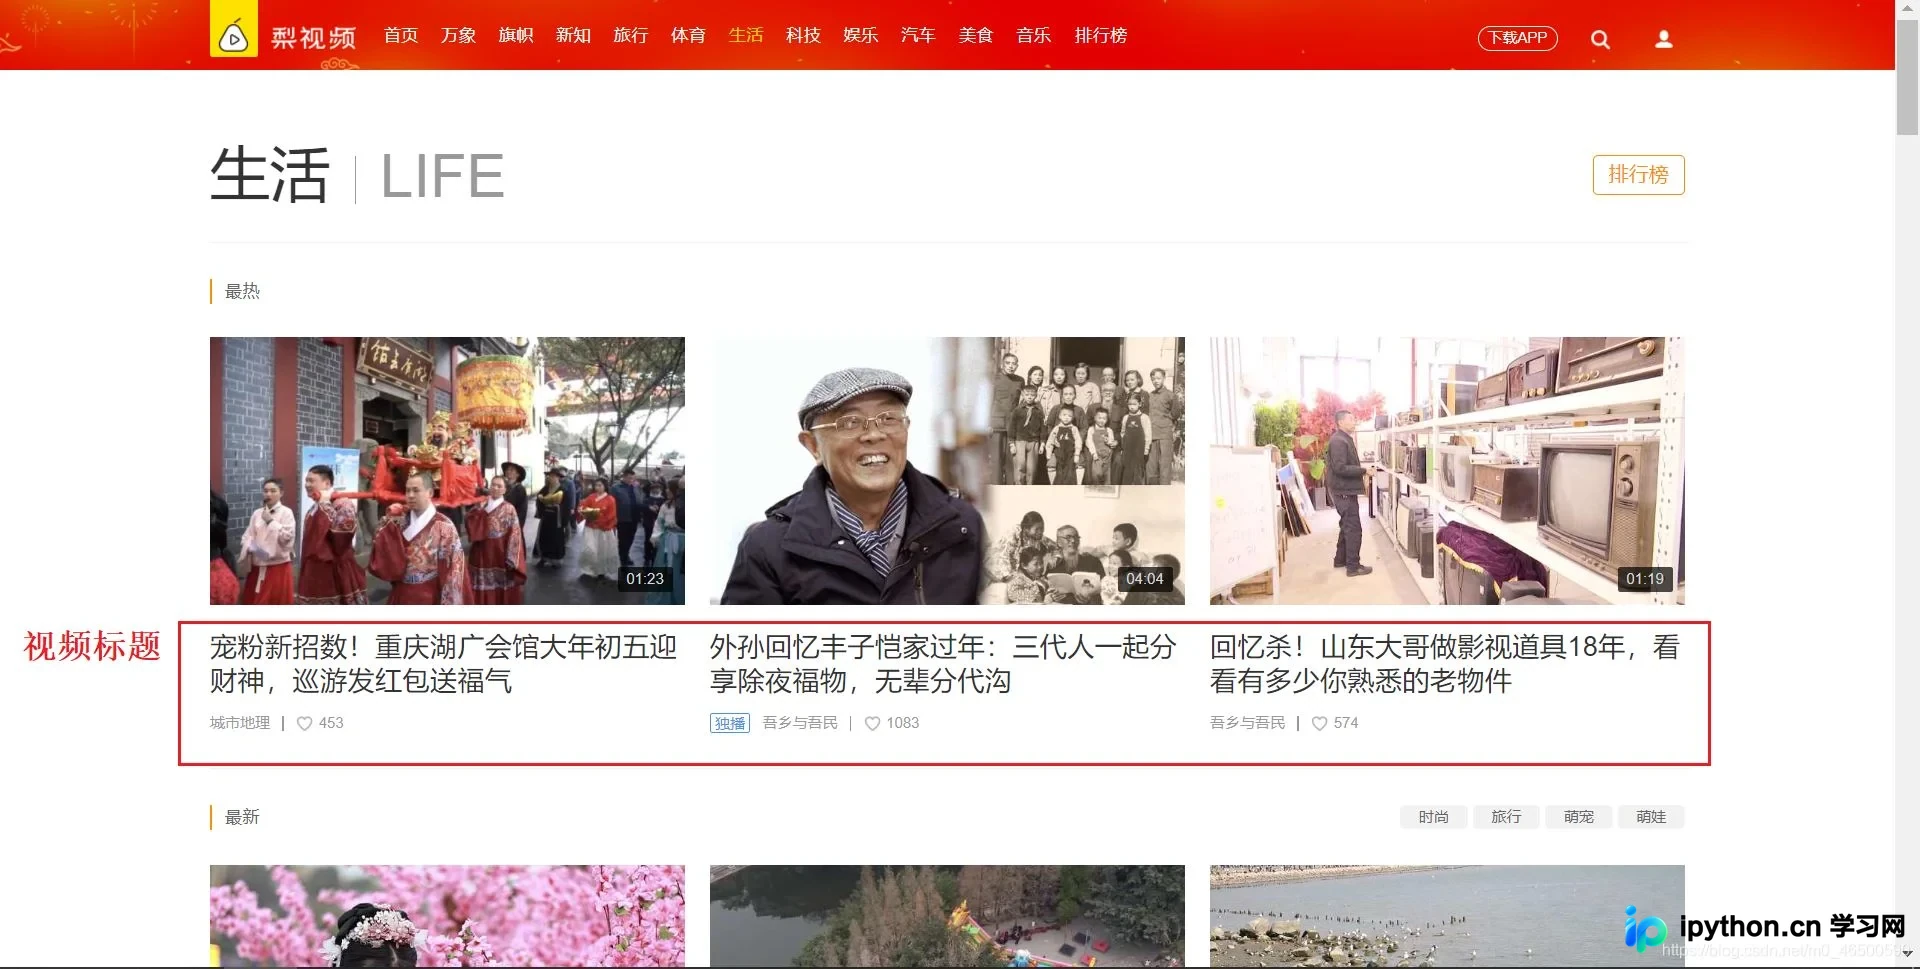
本文基于Scrapy框架解析梨视频网站的数据抓取流程。针对视频标题与描述分属不同页面的特点,通过自定义parse方法与meta参数传递Item对象,实现跨页面数据解析。结合items定义字段与pipeline管道类,完成数据的清洗、持久化存储及多管道优先级处理,提供完整的代码示例与配置说明。
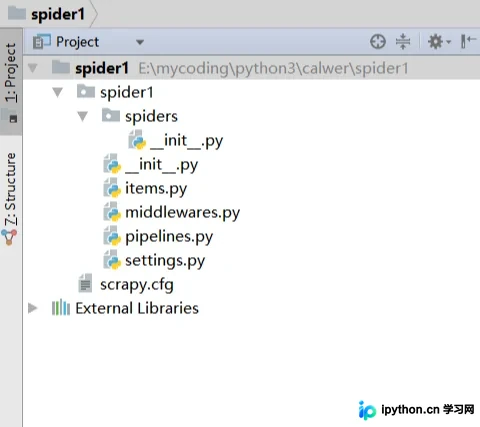
本文详细讲解如何利用Python Scrapy框架搭建电影数据爬虫。内容涵盖项目初始化命令、核心文件功能解析、Spider类的定义规范(包括name、allowed_domains等属性),以及通过XPath提取电影名称与评分的具体代码实现,帮助开发者快速掌握Scrapy基础用法。
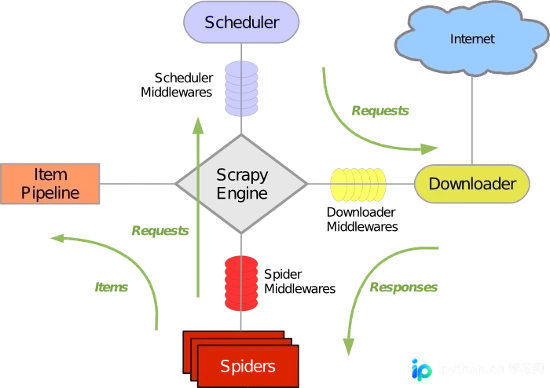
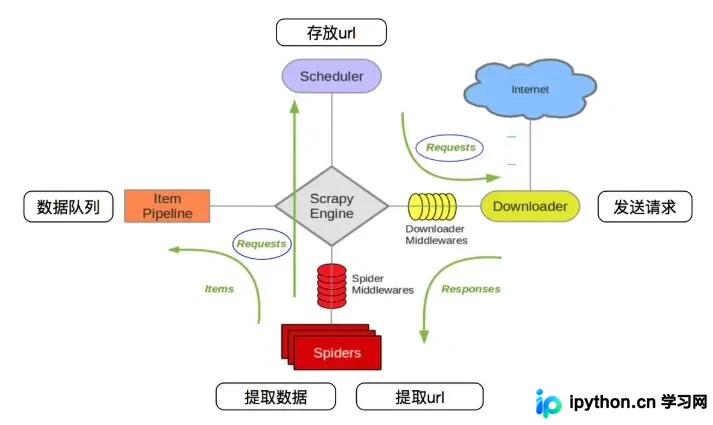
本文详细解析Python爬虫框架Scrapy的核心架构与运行机制。文章系统介绍了Scrapy Engine、Scheduler、Downloader、Spiders及Item Pipeline等关键组件的功能,并梳理了从URL请求到数据存储的完整数据处理流程。同时探讨了基于Twisted的事件驱动模型及各类中间件的作用,帮助开发者深入理解Scrapy的高效抓取原理。
本文详解如何使用Scrapy框架通过携带Cookie的方式访问淘宝购物车。文章介绍了Scrapy架构,对比了三种登录方式,重点演示了手动提取Cookie并重写start_requests方法的过程。通过具体代码示例,展示了如何绕过登录验证获取购物车页面源码,为后续数据提取奠定基础。
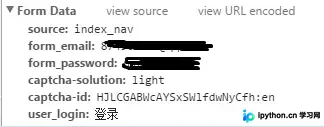
本文详解如何利用Python和Scrapy框架实现豆瓣网站的模拟登录。重点解析如何获取Post地址与Formdata,并结合若快打码平台自动处理验证码图片。通过完整代码示例,展示从发起请求、解析验证码到验证登录成功状态的完整流程,为后续数据抓取奠定基础。
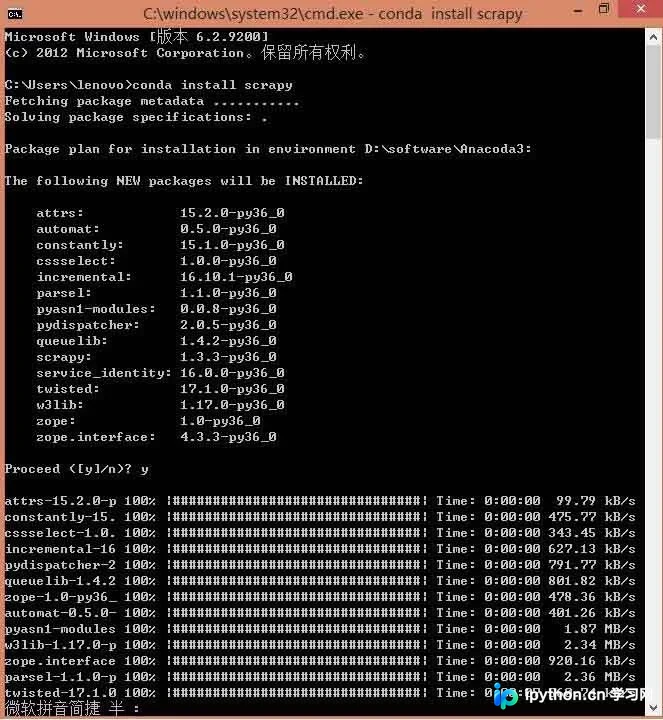
本文介绍利用Anaconda简化Scrapy框架安装的方法。通过conda install scrapy一条命令解决复杂依赖,并详细讲解在PyCharm中配置项目解释器为Anaconda Python路径的操作步骤。同时提醒用户注意点击OK而非Apply以避免不必要的库更新,并提供了验证安装成功的测试方法。
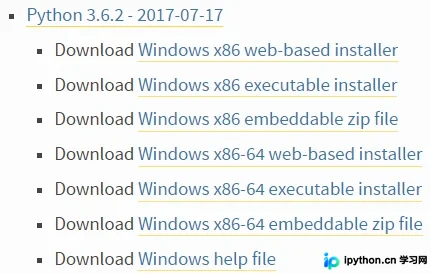
本文详细讲解在Windows 10环境下安装Python 3.6的关键步骤,包括环境变量配置和路径长度限制处理。针对Scrapy和PyQt等常用库的安装报错问题,提供了基于本地whl文件的解决方案。此外,汇总了pip批量安装、版本管理及一键升级的高效命令,帮助开发者快速搭建Python开发环境。
在使用 Scrapy 抓取数据时,若未在本地安装 MySQL 而是希望直接调用云服务器的数据库,可通过 pymysql 结合 sshtunnel 建立加密通道,将远程服务映射至本地回环地址读写。本文详解依赖安装、Pipeline 正确初始化流程、核心代码实现及服务端端口与防火墙排查步骤。