

Python Scrapy实战:构建电影数据爬虫项目

本文详细讲解如何利用Python Scrapy框架搭建电影数据爬虫。内容涵盖项目初始化命令、核心文件功能解析、Spider类的定义规范(包括name、allowed_domains等属性),以及通过XPath提取电影名称与评分的具体代码实现,帮助开发者快速掌握Scrapy基础用法。
电影观赏是大众娱乐的重要组成部分,日常交流中关于新片上映及口碑讨论的话题层出不穷。相较于电影院观影,其他渠道观看往往面临版权或地域限制。本文将介绍如何使用Python中的Scrapy框架来突破这些限制,获取影片相关信息。
1. 创建项目
执行以下命令来初始化项目:
scrapy startproject myfrist(your_project_name)
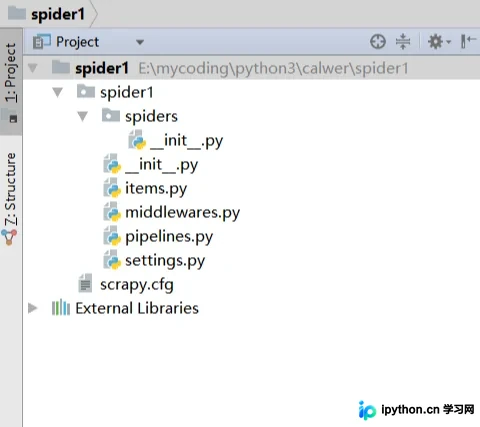
文件结构说明: 名称 | 作用 --|-- scrapy.cfg | 项目配置信息,主要为Sc命令行工具提供基础配置(具体爬虫配置在settings.py中) items.py | 定义数据存储模板,用于结构化数据(类似Django的Model) pipelines | 定义数据处理行为,如结构化数据的持久化 settings.py | 全局配置文件,包含递归层数、并发数、下载延迟等参数 spiders | 爬虫目录,用于存放创建的文件及编写的爬虫规则
注意:通常建议以目标网站域名来命名创建的爬虫文件。
2 编写 Spider
在 spiders 目录中创建 daidu_spider.py 文件。
2.1 注意事项
爬虫文件必须定义一个类,且该类需继承自 scrapy.spiders.Spider。
必须定义 name 属性,即爬虫名称。若未定义,程序运行时会报错,这是源码中的强制要求。
2.2 编写内容
在此处需告知 Scrapy 如何定位并获取具体数据,因此必须定义以下关键属性:
name:定义爬虫的唯一标识名称。
allowed_domains:包含爬虫允许抓取的基本域名列表。
start_urls:定义爬虫启动时访问的初始 URL 列表。
parse():定义用于提取和解析抓取数据的方法。
以下代码展示了 Spider 的基本结构:
import scrapy
class DoubanSpider(scrapy.Spider):
  name = 'douban'
  allwed_url = 'douban.com'
  start_urls = [
    'https://movie.douban.com/top250/'
  ]
  def parse(self, response):
    movie_name = response.xpath("//div[@class='item']//a/span[1]/text()").extract()
    movie_core = response.xpath("//div[@class='star']/span[2]/text()").extract()
    yield {
      'movie_name':movie_name,
      'movie_core':movie_core
    }
至此,关于使用 Python Scrapy 获取影片数据的实例分析已完成。如需了解更多 Python 爬虫与 Scrapy 的相关内容,可查阅本站往期文章或继续阅读后续教程,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









