Python Scrapy shell 快速调试与规则验证指南
在 Python 爬虫开发中,直接使用 Scrapy 框架验证复杂的 XPath 或 CSS 选择器往往需要运行完整流程,耗时且容易打断工作流。本文详细介绍如何使用 Scrapy shell 交互终端在不启动爬虫的情况下实时抓取页面数据,快速调试提取规则,并提供标准的虚拟环境配置步骤与关键操作命令,大幅提升数据采集逻辑的验证效率。
2026-10-12
6

在 Python 爬虫开发中,直接使用 Scrapy 框架验证复杂的 XPath 或 CSS 选择器往往需要运行完整流程,耗时且容易打断工作流。本文详细介绍如何使用 Scrapy shell 交互终端在不启动爬虫的情况下实时抓取页面数据,快速调试提取规则,并提供标准的虚拟环境配置步骤与关键操作命令,大幅提升数据采集逻辑的验证效率。
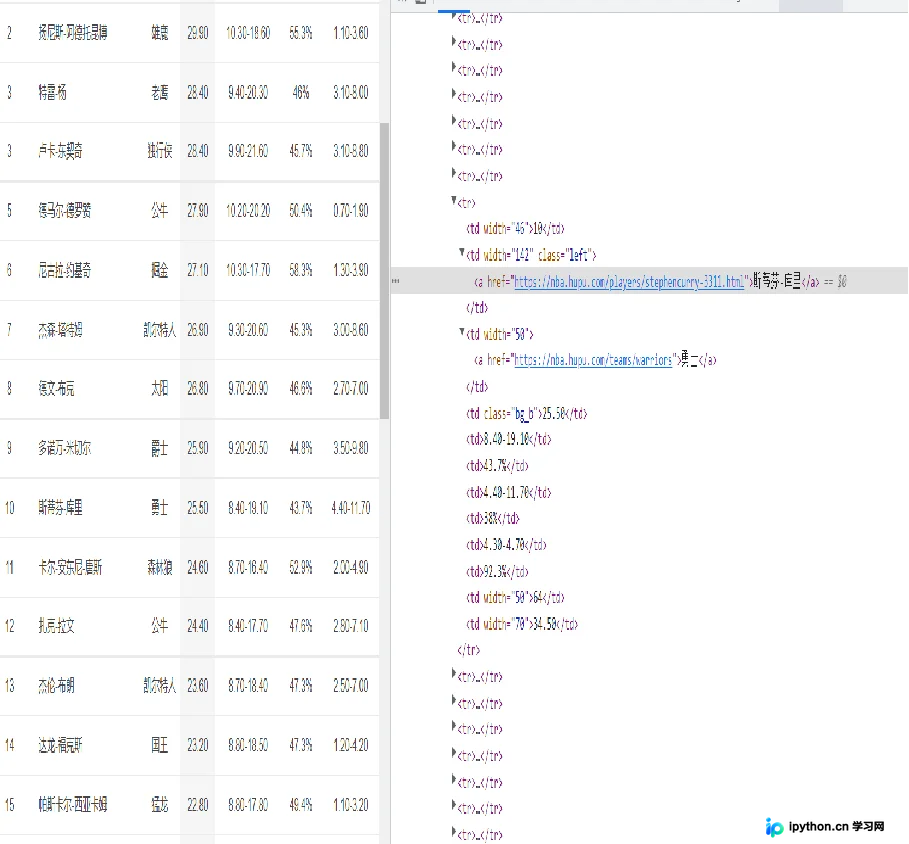
本文详解使用Scrapy框架抓取虎扑体育NBA球员统计数据的完整流程。从工程创建、XPath元素定位、Item数据模型定义,到配置MySQL连接管道与建表操作,逐步给出可运行代码与参数说明,帮助开发者快速实现网页数据的高效采集与本地持久化存储。
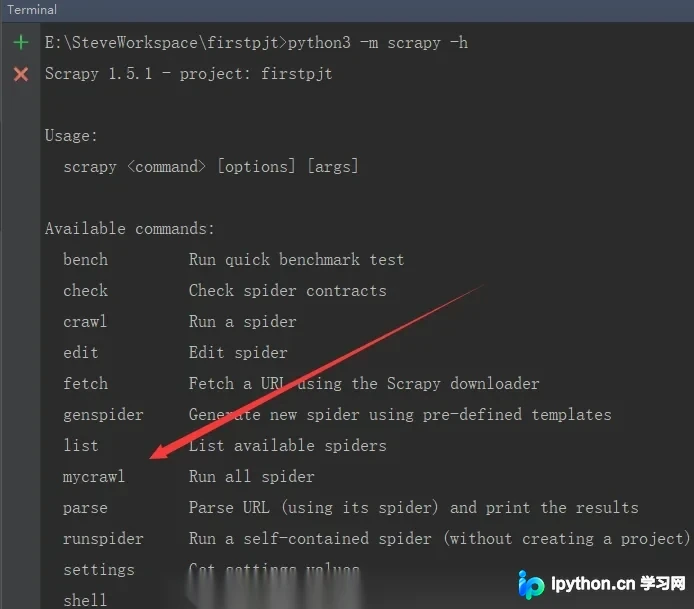
本文介绍Scrapy批量运行爬虫文件的两种实现方式:一是直接修改CrawProcess源码中的run()方法,遍历加载所有爬虫;二是通过创建自定义命令目录(mycmd)并继承修改源码,实现一键启动多个爬虫。详细步骤包括代码修改、目录结构配置及setting.py参数设置,帮助开发者高效管理多个爬虫任务。
本文详细解析Scrapy框架中items文件夹的标准工作流程。通过创建继承自scrapy.Item的结构化数据类,在Spider解析函数中提取并填充字段,最后经settings.py配置的Pipeline管道进行清洗或入库,可彻底告别松散字典传递,实现高效稳健的爬虫数据管理。
本文详细解析Python Web框架Django与爬虫框架Scrapy的安装流程。内容涵盖Python版本检查、pip工具配置、virtualenv虚拟环境创建,以及解决Scrapy安装中常见的Twisted依赖和Visual C++编译环境报错问题,帮助开发者顺利完成开发环境搭建。
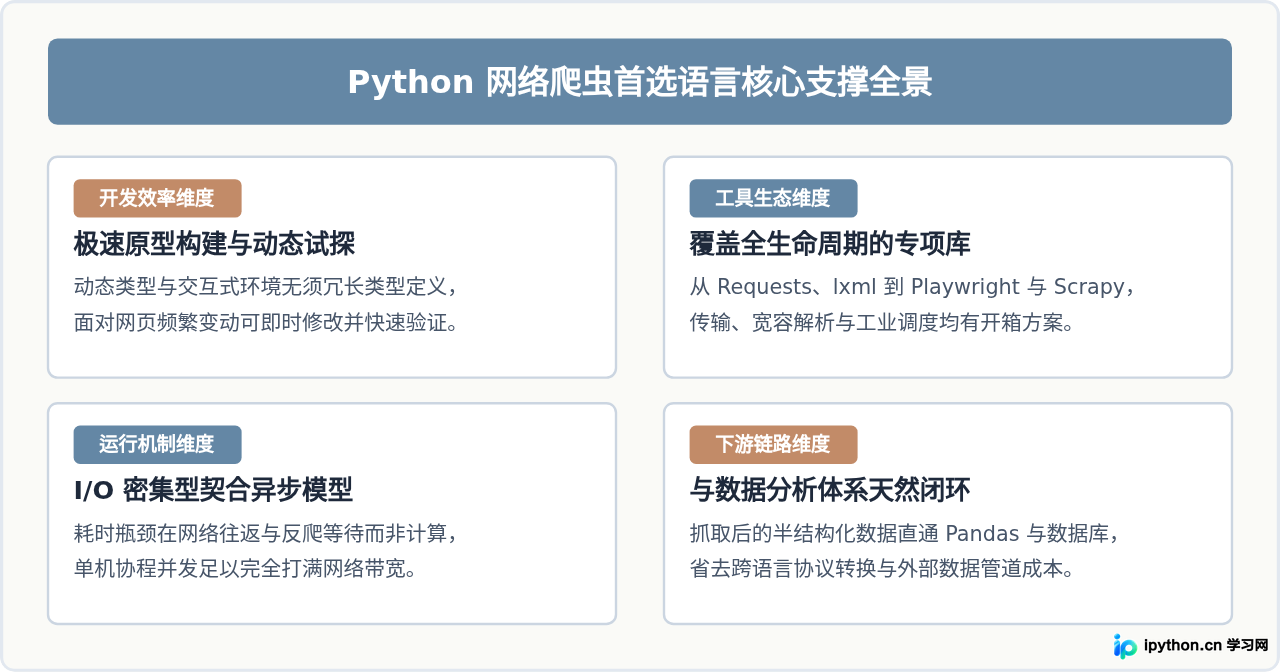
深入解析为什么Python成为网络爬虫开发的首选语言,从原型开发敏捷度、全流程专项工具生态、I/O密集型任务特性及下游数据协同等维度展开系统剖析,并提供技术选型指南。
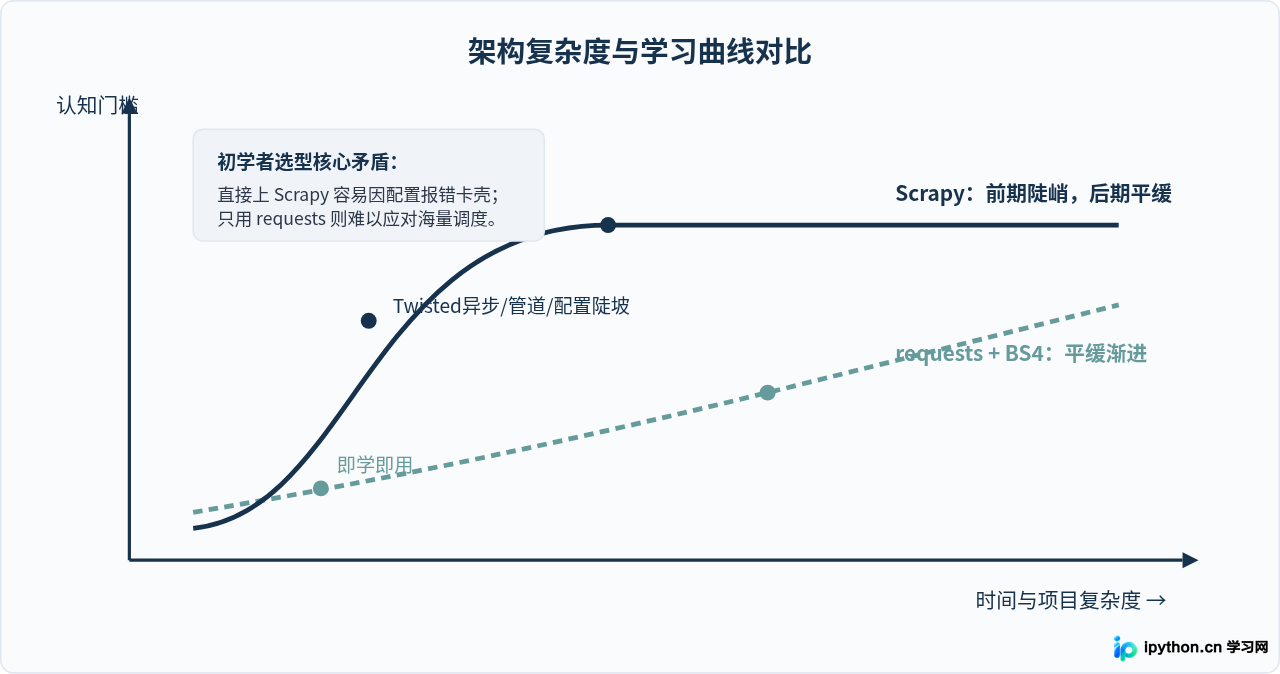
针对Python爬虫初学者在Scrapy与requests+BS4之间的选型困惑,深入对比两者的学习成本、架构复杂度、适用场景与演进路径,提供清晰可执行的决策建议。
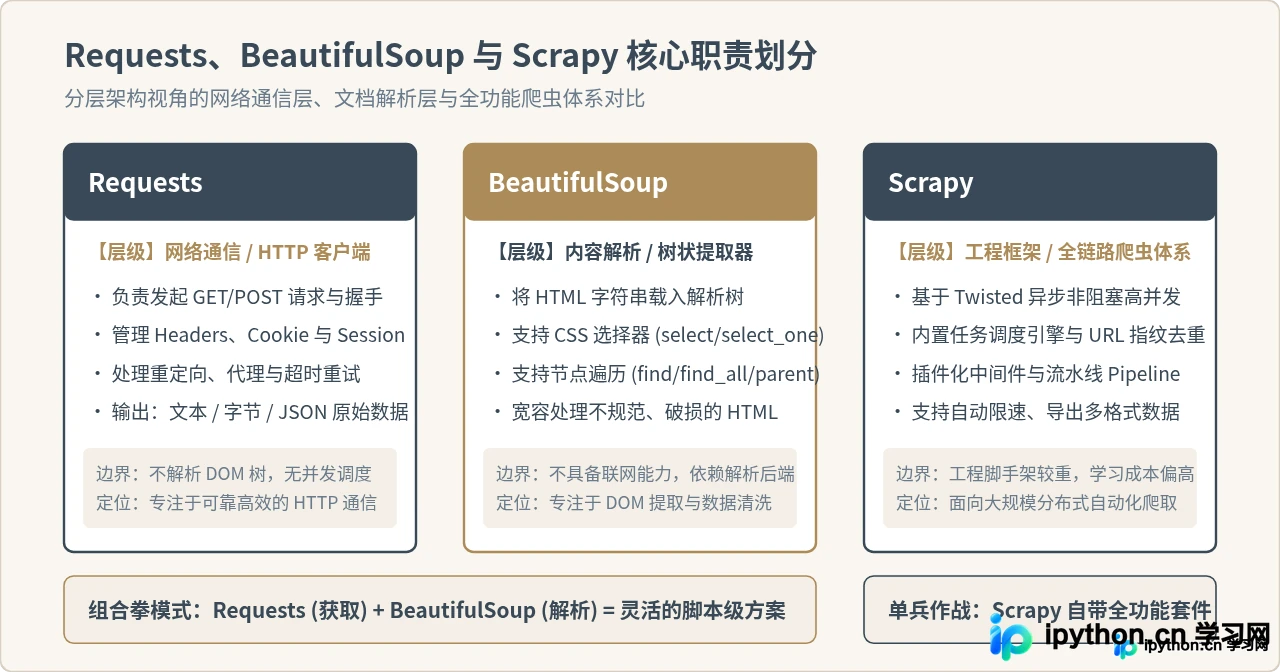
深入对比 Python 爬虫三大主流工具 Requests、BeautifulSoup 与 Scrapy 的定位差异、工作原理与适用场景,提供选型决策树与实践代码。
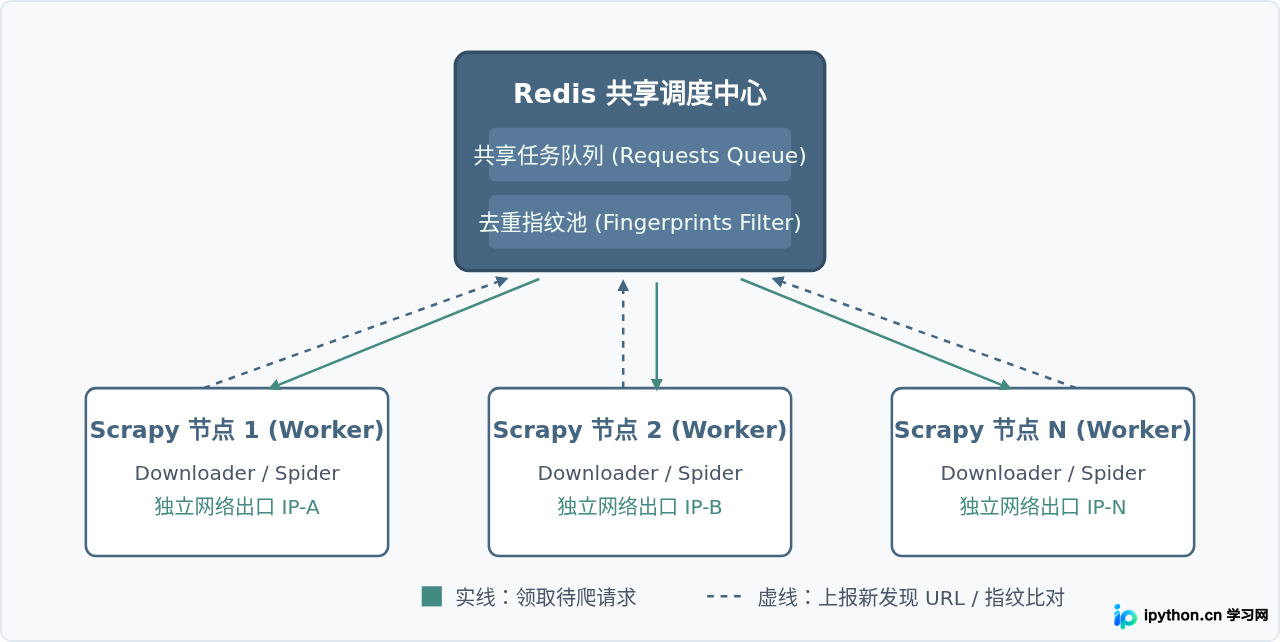
本教程详细讲解如何使用Python Scrapy与Redis构建高可用、大规模的分布式网络爬虫项目,涵盖架构原理、环境搭建、代码编写、节点部署及监控运维。
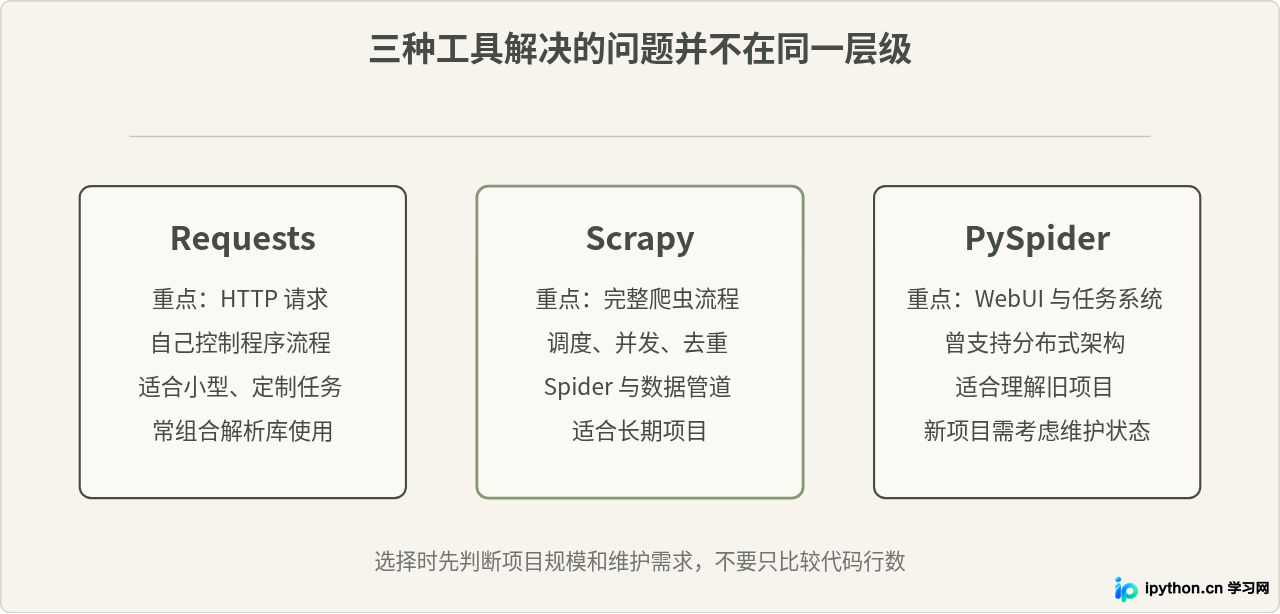
对比Python爬虫常见的Requests、Scrapy与PySpider,从学习成本、并发抓取、任务调度、数据处理、项目维护和适用场景等方面说明区别,并给出不同爬虫项目的选择方法。
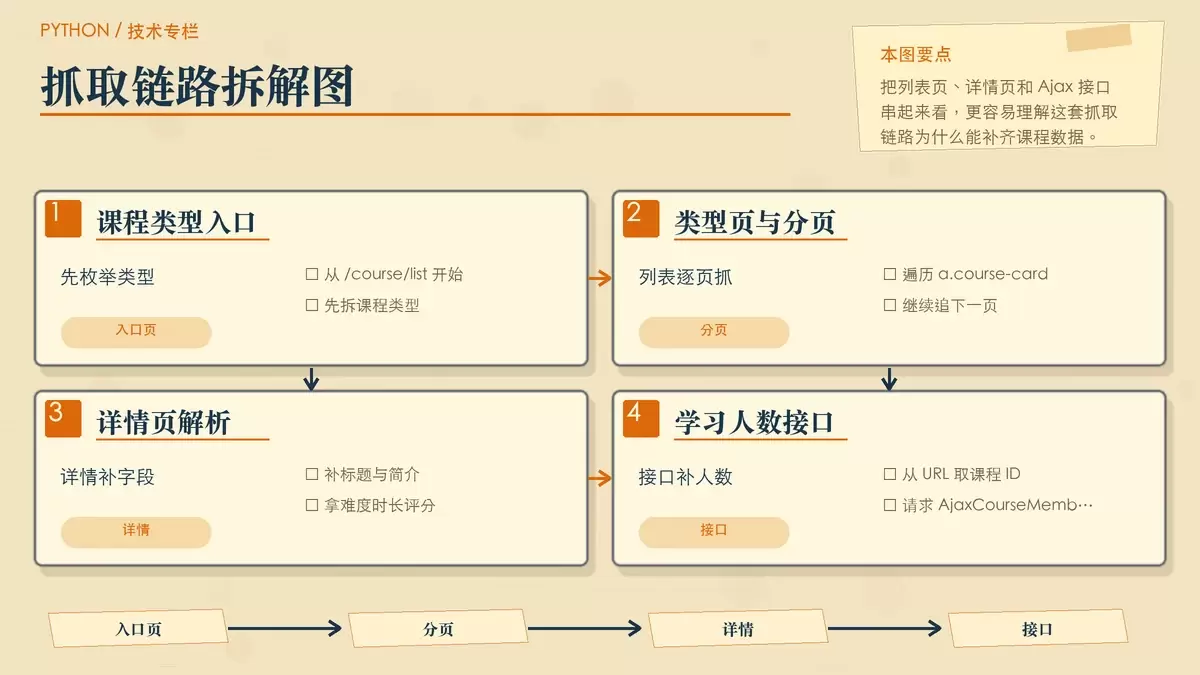
这篇文章把一个抓取慕课网免费课程的 Scrapy 示例,整理成可直接复用的完整流程:从按课程类型翻页抓取,到进入详情页补齐难度、时长、评分,再通过接口拿到学习人数,最后异步写入 MySQL。代码事实、命令和表结构均保留,方便对照落地。