用 Scrapy 抓取慕课网全部免费课程:从分页采集到 MySQL 入库
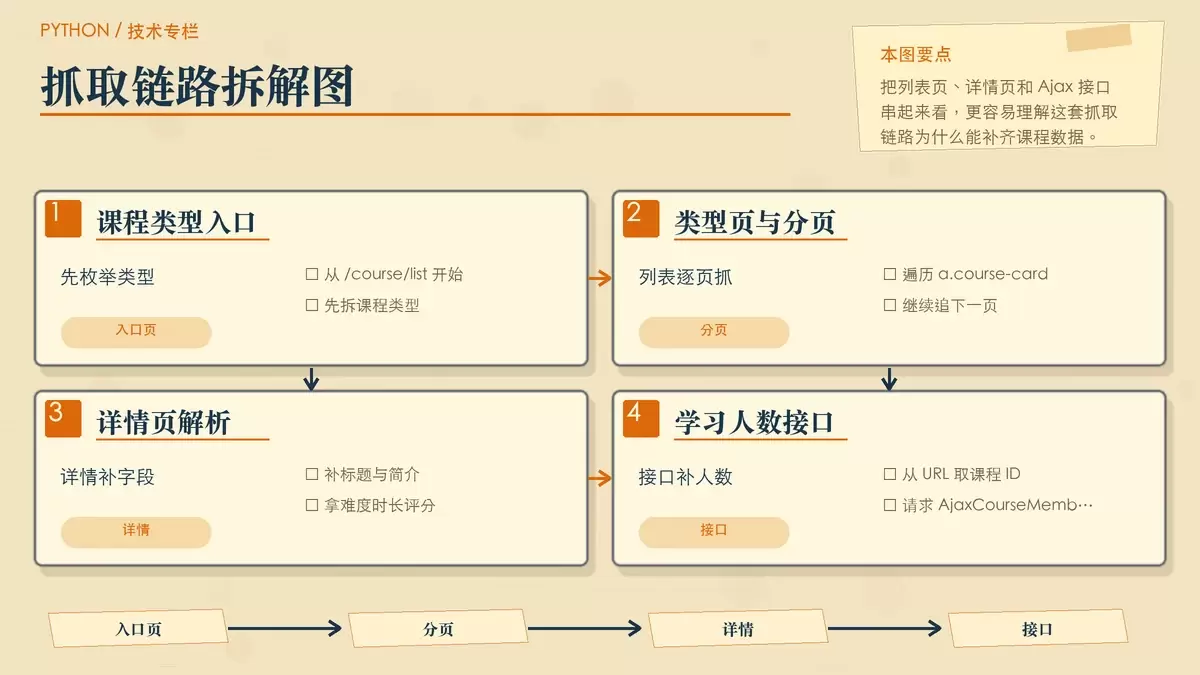
这篇文章把一个抓取慕课网免费课程的 Scrapy 示例,整理成可直接复用的完整流程:从按课程类型翻页抓取,到进入详情页补齐难度、时长、评分,再通过接口拿到学习人数,最后异步写入 MySQL。代码事实、命令和表结构均保留,方便对照落地。
2026-08-25
194

这篇文章把一个抓取慕课网免费课程的 Scrapy 示例,整理成可直接复用的完整流程:从按课程类型翻页抓取,到进入详情页补齐难度、时长、评分,再通过接口拿到学习人数,最后异步写入 MySQL。代码事实、命令和表结构均保留,方便对照落地。
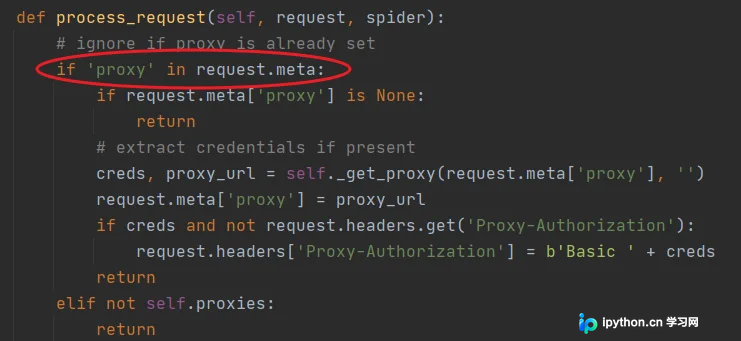
本文详细介绍Scrapy框架中代理中间件的使用与自定义方法。涵盖HttpProxyMiddleware的默认配置、通过Request meta参数设置代理、抓取快代理IP并验证可用性,以及继承HttpProxyMiddleware和直接编写中间件类两种自定义实现方案,帮助开发者解决IP被封或访问受限问题。
本文详解Scrapy实现模拟登录的两种核心方式:一是直接携带Cookie发起请求,适用于Cookie有效期较长的场景;二是通过发送Post请求获取Cookie,分别介绍scrapy.FormRequest手动构造表单与scrapy.FormRequest.from_response()自动填充表单的方法。结合GitHub登录示例代码,解析如何验证登录状态及处理动态表单字段,帮助开发者高效解决需要登录才能访问的页面爬取问题。
本文深入解析Scrapy框架的数据流向及核心组件。详细阐述引擎、调度器、下载器与Spider间的数据交互过程,并重点剖析DownloaderMiddleware与SpiderMiddleware的作用位置及核心方法,包括process_request、process_response和process_exception的具体行为与返回值处理,帮助开发者掌握Scrapy内部机制。
本文解决在Mac系统(如OSX 10.11及更高版本)中安装Python爬虫框架Scrapy时遇到的“Operation not permitted”错误。该问题通常由旧版Python(如2.7)与新系统权限机制冲突导致,通过升级Python版本即可有效解决。
本文深入解析Python中五种常见的爬虫框架,包括成熟的Scrapy、高效的Crawley、可视化的Portia、轻量级的Newspaper以及文章提取工具Python-goose。详细对比各框架的功能特点、适用场景及技术优势,帮助开发者根据需求选择合适的爬虫解决方案。
本文详细介绍Scrapy爬虫在生产环境中的服务器部署方案,涵盖Scrapyd服务端、ScrapydClient客户端及ScrapydWeb可视化管理工具的安装与配置。通过具体命令演示项目上传、爬虫启动及参数传递,并结合实际爬取数据展示部署效果与常见问题分析,帮助开发者实现高效、可视化的爬虫集群管理。
本文详解如何在Python Scrapy框架中集成browsercookie库,通过读取本地Firefox浏览器的Cookie实现免登录爬取。重点讲解如何替换默认的CookiesMiddleware,处理Chrome 80版本后的加密差异,并演示如何构造POST请求完成自动化点赞操作,为需要登录态的爬虫提供实用方案。
本文详解在Python中使用Scrapy框架实现定时爬虫的多种方案。通过Timer类、os.system调用及sched模块,可灵活设定抓取周期。文章提供了具体代码示例,涵盖单次执行与周期性任务,帮助开发者根据需求配置定时策略,适用于数据挖掘、监测及自动化测试场景。
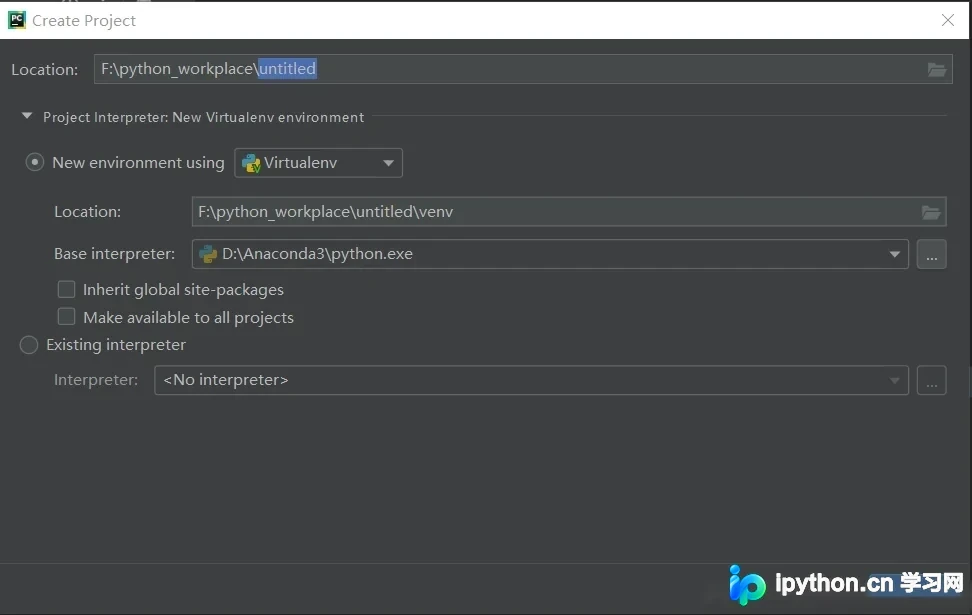
本文详细介绍如何在PyCharm中快速创建Scrapy爬虫项目。主要步骤包括:新建Python项目、通过Settings配置并安装Scrapy库(建议更换下载源以防超时),最后利用Terminal终端执行scrapy startproject命令完成项目初始化。文章涵盖环境配置与命令行操作,帮助开发者高效搭建爬虫开发环境。
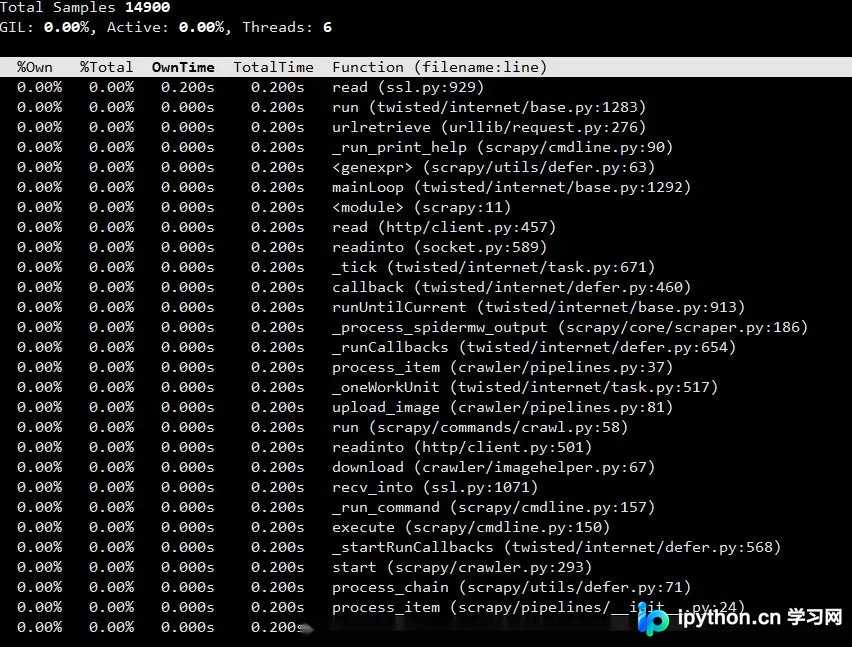
本文介绍如何使用py-spy工具排查Scrapy爬虫因网络IO导致的进程卡死问题。通过定位耗时函数发现urllib.urlretrieve缺乏超时参数,进而封装支持timeout的urlopen方法,有效解决爬虫进程堆积和数据延迟问题。
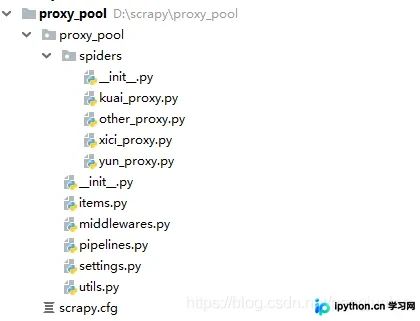
本文详细介绍如何使用Scrapy-Redis框架搭建高效的IP代理池。内容涵盖从快代理等网站批量爬取IP、通过请求验证IP可用性,以及利用Redis存储和管理代理池的完整流程。相比传统requests方案,该方法能显著提升爬取速度并解决高频访问限制问题,适合需要大规模数据采集的场景。