Python爬虫中生产者消费者模式进程意外退出的排查与修复
本文分析Python爬虫中使用多进程生产者-消费者模式时,因未正确调用join()导致消费者进程过早终止的问题。通过对比错误与正确的代码结构,指出必须等待生产者完成并调用消费者join(),同时需向队列发送结束标志,确保所有任务被处理完毕。
2026-10-16
4

本文分析Python爬虫中使用多进程生产者-消费者模式时,因未正确调用join()导致消费者进程过早终止的问题。通过对比错误与正确的代码结构,指出必须等待生产者完成并调用消费者join(),同时需向队列发送结束标志,确保所有任务被处理完毕。
本文详细介绍如何使用Scrapy框架将爬取数据导出为Excel格式。通过定义Item实体类、配置CsvItemExporter以及注册Pipeline,实现数据的结构化存储。文章涵盖环境要求、核心代码实现及爬虫运行步骤,帮助开发者快速掌握Scrapy数据导出功能。
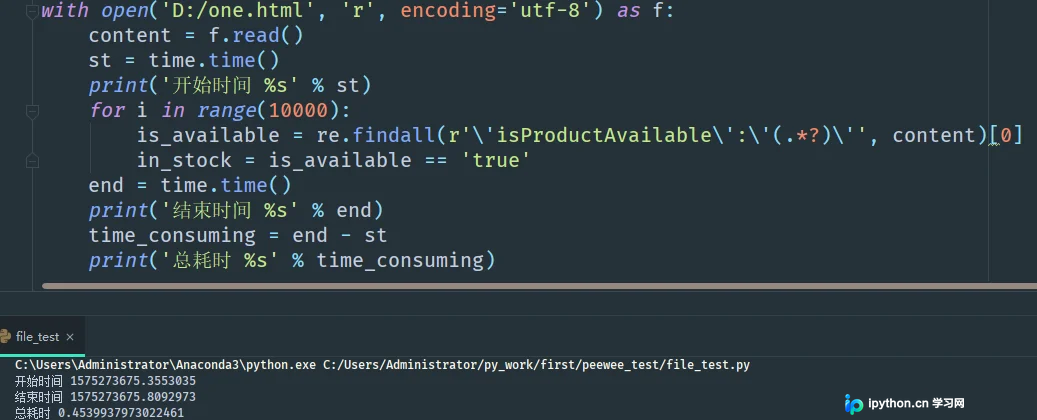
本文探讨 Python 中 re.compile 的必要性。作者通过实际案例指出,在数据量较小(如上万条)的场景下,直接使用 re.findall 或 re.search 的性能损耗可忽略不计,过度优化反而增加代码复杂度。只有面对百万级以上数据时,预编译正则对象才具有显著性能优势。文章强调应根据业务量级合理选择策略,而非盲目追求代码规范。
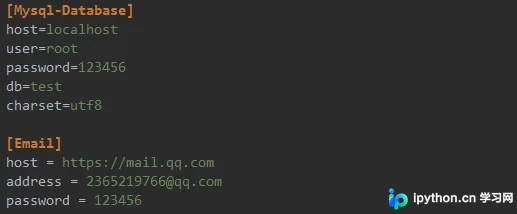
本文介绍如何利用Python内置的ConfigParser模块读取ini格式配置文件,并通过二次封装实现灵活配置管理。通过对比绝对路径与相对路径读取方式,演示了如何将数据库连接信息、爬虫参数等配置抽离至独立文件。文章提供了完整的类封装代码,涵盖读取配置、连接MySQL及执行SQL操作,帮助开发者提升项目配置的灵活性与可维护性。
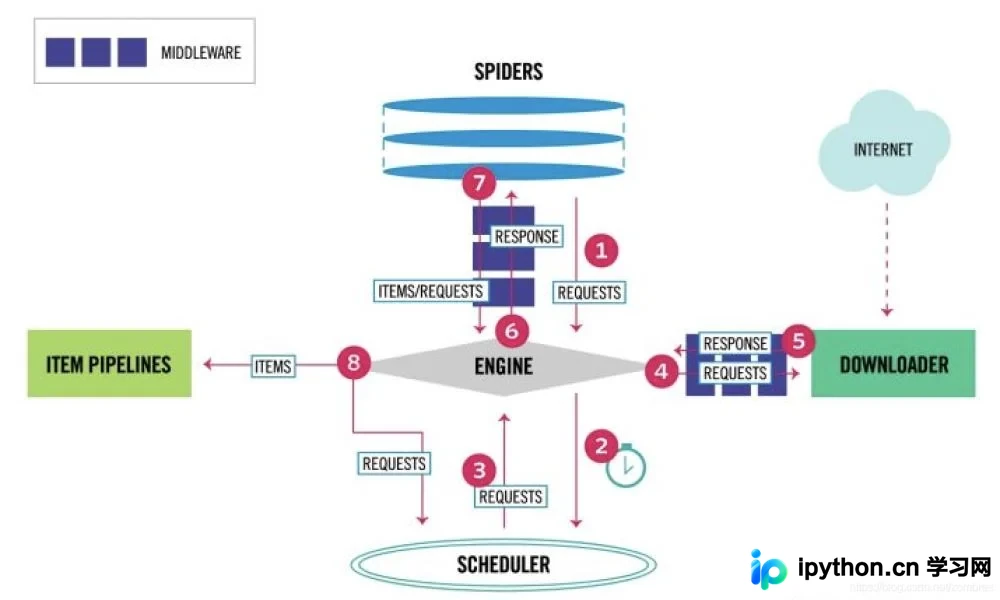
本文深入解析 Scrapy 框架中的两类核心中间件:下载器中间件(Downloader Middleware)与 Spider 中间件。详细说明了中间件的注册顺序、执行流程及关键方法(process_request、process_response、process_exception)的行为差异。提供了自定义 User-Agent 轮换、代理 IP 切换及基于状态码的重试中间件代码示例,并介绍了 Spider 中间件对 Item 和 Request 的处理逻辑,帮助开发者构建更稳健的爬虫系统。
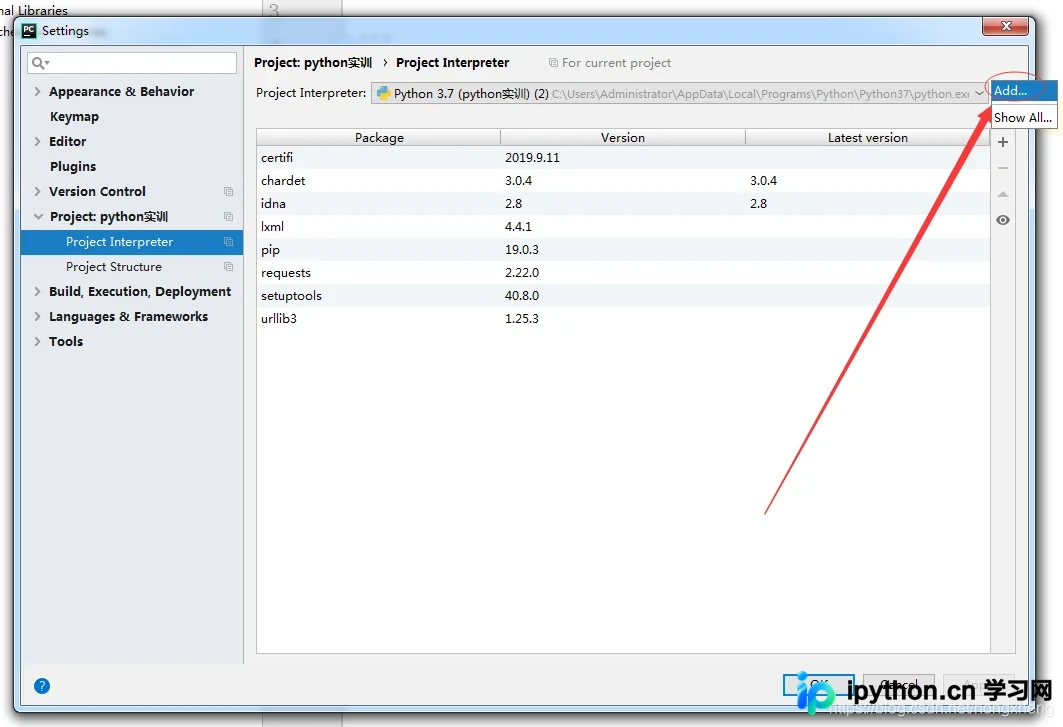
本文详解PyCharm中etree与lxml模块标红问题的两种常见原因及解决方法。首先解决解释器路径不匹配导致的红线,其次通过指定版本下载whl文件并pip安装修复库引用错误,帮助开发者快速恢复代码正常提示。
本文介绍如何使用Python多线程技术构建一个支持百度、必应和谷歌的图片下载器。通过requests获取接口数据,利用threading库实现并发搜索与下载,配合alive-progress显示进度条。文章提供了完整的开发环境配置、核心代码逻辑及命令行使用示例,适用于构建小型图像分类数据集。
本文详解Scrapy框架中下载中间件的编写方法。涵盖process_request、process_response及process_exception三大核心函数的实现逻辑,演示如何通过中间件进行UA伪装、响应数据篡改(结合Selenium处理动态加载)以及代理IP设置,并说明在settings.py中启用中间件的具体配置步骤。
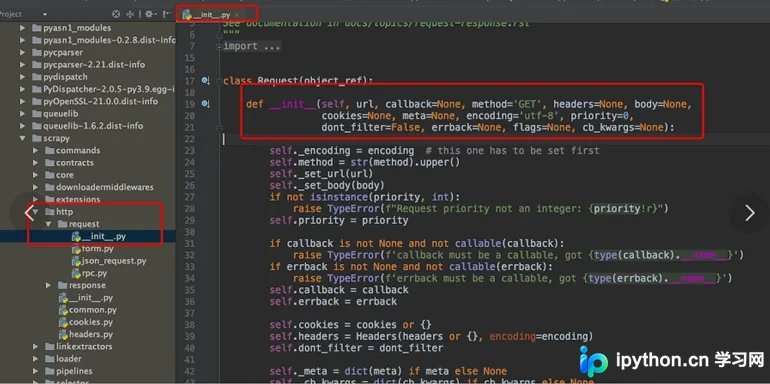
本文详细介绍Python Scrapy框架中Request和Response对象的核心用法。解析Request对象的url、callback、method等关键参数,演示如何通过FormRequest发送POST请求,并列举Response对象的text、body、xpath等常用属性,帮助开发者掌握Scrapy基础数据交互机制。
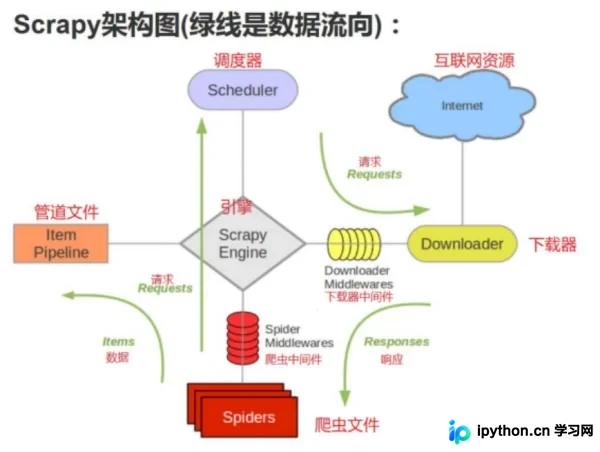
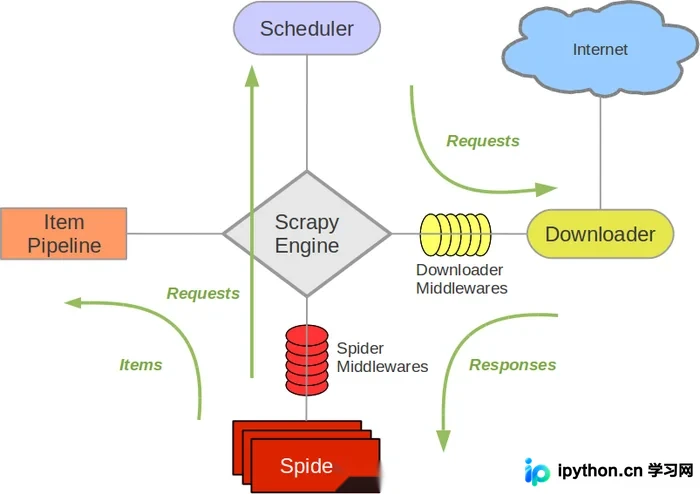
本文深入解析Scrapy框架的核心组件,包括引擎、调度器、下载器、Spider及管道等,并详细阐述数据在系统中的流动机制与处理流程,帮助开发者理解Scrapy的工作逻辑。
本文详细解析Python中urllib标准库与第三方库urllib3的区别。urllib包含request、parse、error和robotparser四个模块,适用于基础网络请求。urllib3功能更强大,支持连接池、线程安全、代理及SSL验证。文章通过代码示例对比两者在GET/POST请求、Cookie处理、代理设置、文件上传及超时处理上的具体用法,帮助开发者根据需求选择合适的库。
本文深入解析Scrapy爬虫框架的核心结构,详细阐述引擎、调度器、下载器、蜘蛛及管道等关键组件的功能与交互机制。通过梳理项目目录结构与数据流动路径,帮助开发者理解Scrapy为何被视为完整框架而非简单库,并掌握其高效处理网络请求与数据提取的工作原理。