

Python爬虫实战:使用Scrapy与urllib爬取百度图片

本文详解Python环境下Scrapy框架的安装配置及常见错误解决,并通过两个实例演示如何使用urllib和re模块爬取静态网页图片及处理百度图片滚动加载的反爬虫机制,提供完整代码与注意事项。
本文使用的开发工具包括Python 2.7,可通过指定链接下载。
核心依赖框架为Scrapy。
代码编辑推荐使用Sublime Text 3。
一、Python环境搭建(Windows系统)
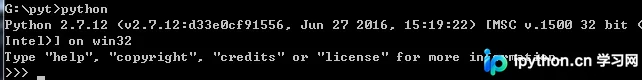
1. 安装Python 2.7。安装完成后,在命令行(cmd)中输入python命令,若显示版本信息则代表安装成功。
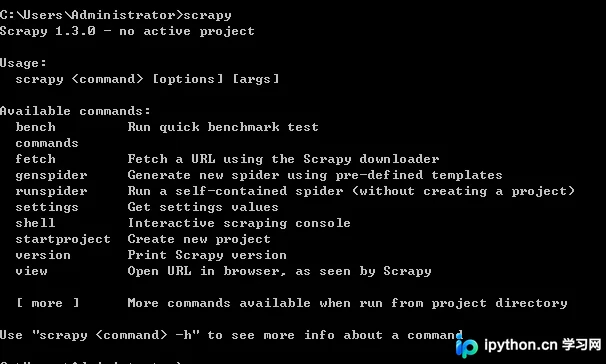
2. 集成Scrapy框架。在命令行执行安装命令:pip install Scrapy。

安装成功的界面显示如下:
若出现失败情况,常见的一种报错示例如下:
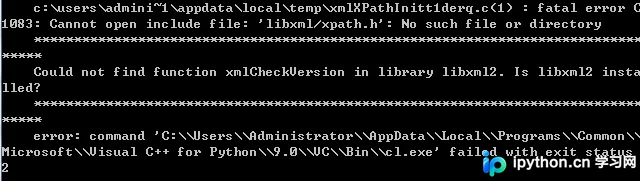
针对上述错误的解决方案为:
其他可能的报错信息,建议通过搜索引擎查找对应解决方案。
二、开始编写爬虫代码。
1. 针对无反爬虫措施的静态网站进行爬取,例如百度贴吧、豆瓣读书等站点。
以《桌面吧》的一个具体帖子为例,链接为:https://tieba.baidu.com/p/2460150866?red_tag=3569129009
对应的Python代码如下:
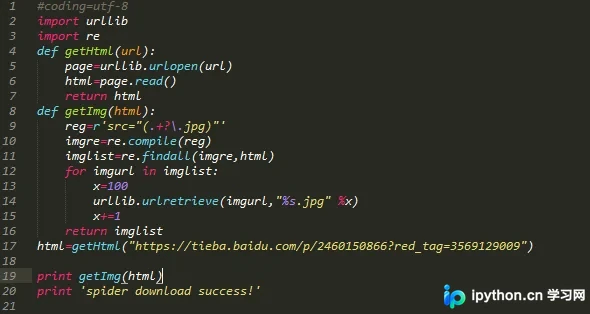
代码注释说明:引入了urllib和re两个模块。定义了两个函数,第一个函数用于获取目标网页的完整数据,第二个函数用于从目标网页中提取图片链接。程序遍历网页内容,并将获取的图片按照从0开始的序号进行排序保存。
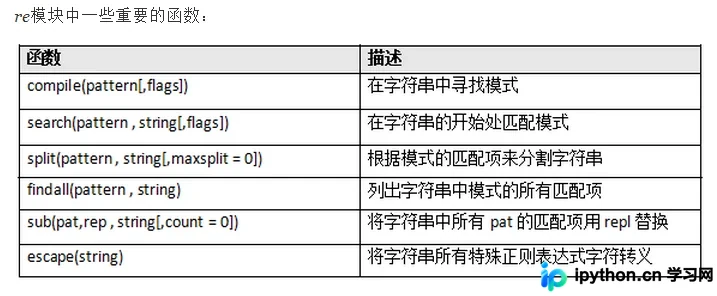
补充说明:re模块的相关知识点如下:
爬取图片的效果展示如下:
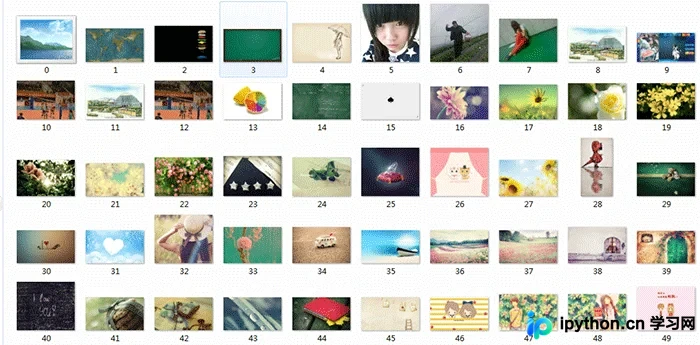
图片默认保存路径位于与.py脚本文件相同的目录下。
2. 针对具有反爬虫措施的百度图片进行爬取。
以关键字搜索“表情包”为例,URL链接为:https://image.baidu.com/search/index?tn=baiduimage&ct=201326592&lm=-1&cl=2&ie=gbk&word=%B1%ED%C7%E9%B0%FC&fr=ala&ori_query=%E8%A1%A8%E6%83%85%E5%8C%85&ala=0&alatpl=sp&pos=0&hs=2&xthttps=111111
由于图片采用滚动式加载机制,本示例仅爬取优先加载的前30张图片。
实现该功能的代码如下:
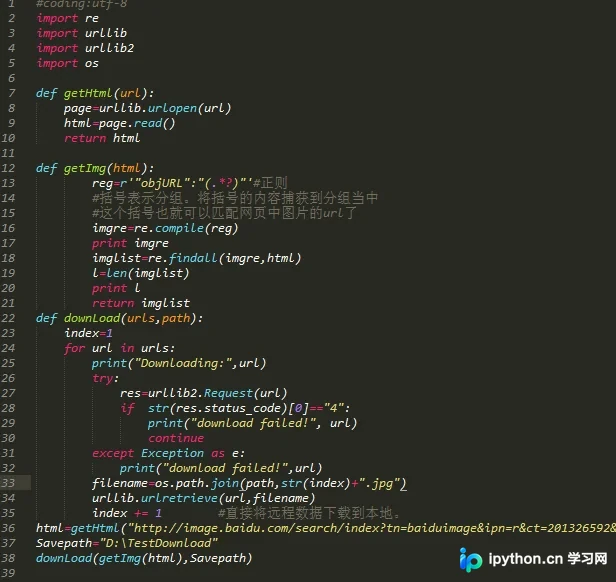
代码注释说明:导入了4个模块,其中os模块用于指定图片的保存路径。前两个函数的功能与前述示例相同。第三个函数中使用了if判断语句,并包含try...Exception异常处理机制。
具体的爬取过程截图如下:
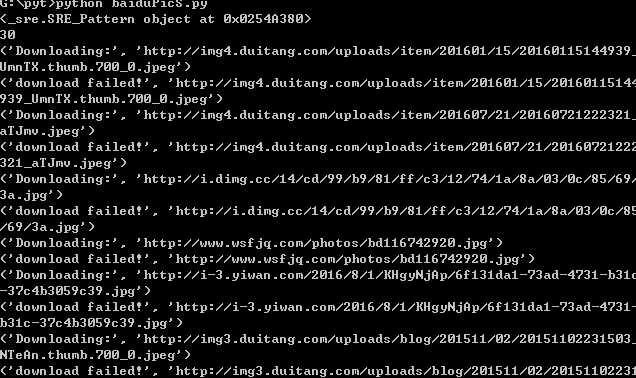
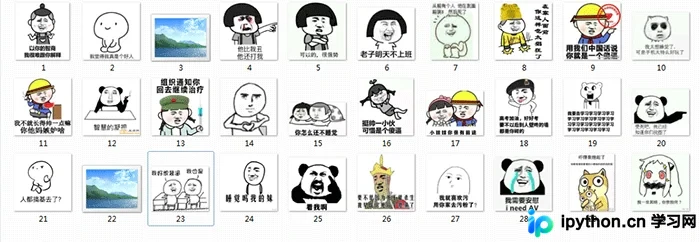
最终的爬取结果展示如下:
注意事项:编写Python代码时需严格注意缩进对齐,and关键字前后不能混用Tab键和空格,否则容易引发报错。
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作能带来一定的帮助,同时也希望多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









