基于Python与Scrapy的微信租房机器人实战解析
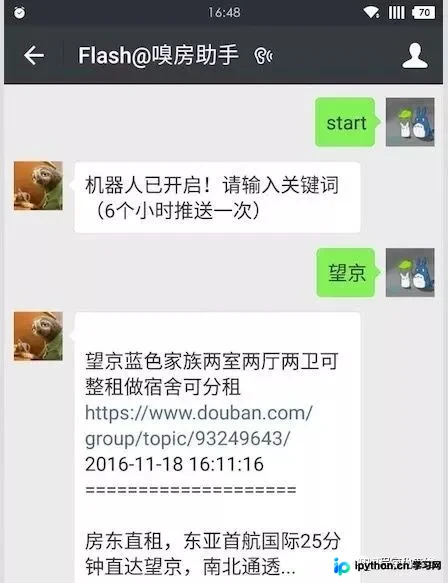
本文详细介绍如何利用Python、Scrapy爬虫框架及Whoosh搜索引擎构建一个自动抓取豆瓣租房信息并推送到微信的机器人。通过jieba分词与索引生成API,结合wxBot接口实现定时推送与持久化存储,帮助租房者高效获取实时房源。
2026-10-13
6

本文详细介绍如何利用Python、Scrapy爬虫框架及Whoosh搜索引擎构建一个自动抓取豆瓣租房信息并推送到微信的机器人。通过jieba分词与索引生成API,结合wxBot接口实现定时推送与持久化存储,帮助租房者高效获取实时房源。
本文详细讲解如何在CentOS系统上部署Redis服务并允许远程连接,配合Windows环境下的Scrapy-Redis爬虫实现分布式抓取。内容涵盖Redis安装、配置文件修改(关闭保护模式)、防火墙设置、Spider类继承RedisSpider及settings.py配置,最后通过redis-cli推送URL验证爬虫运行状态。
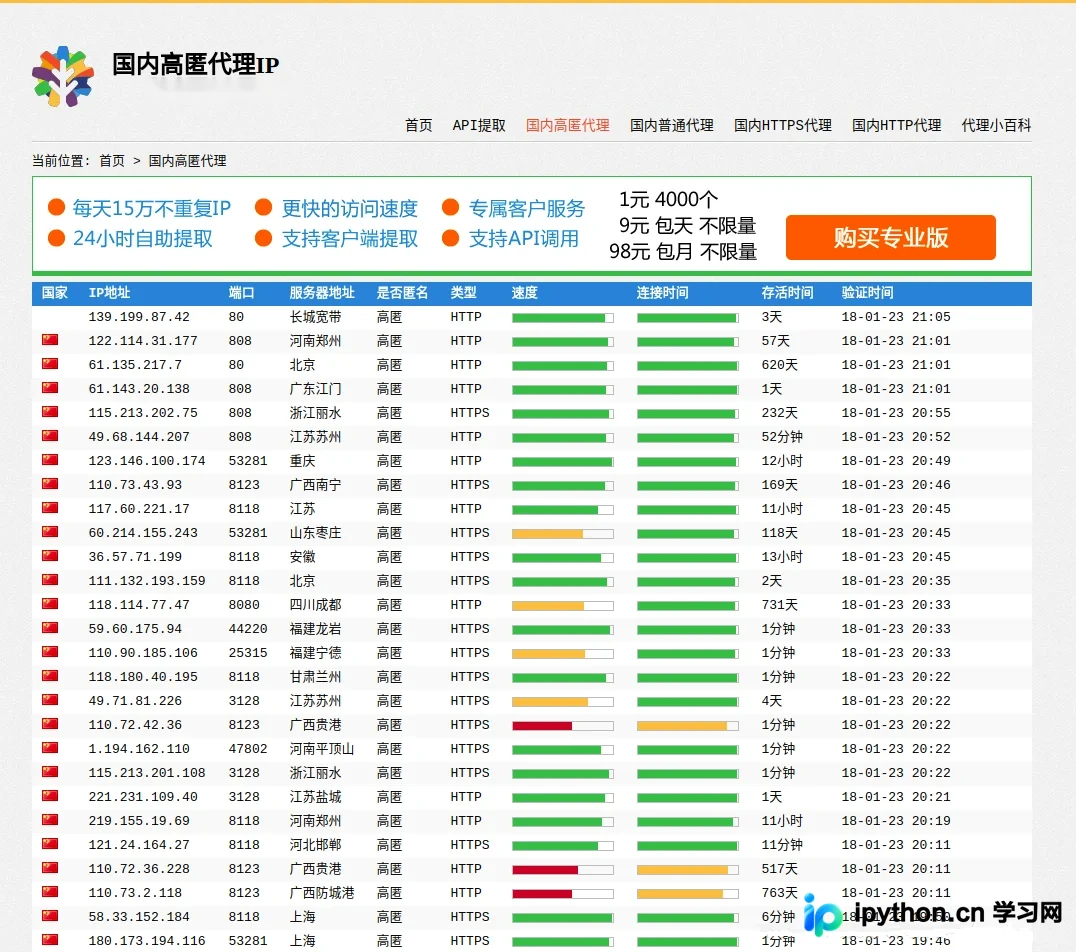
本文详细介绍如何使用Scrapy框架爬取西刺代理网的免费高匿IP数据,并将结果保存至MySQL数据库。教程涵盖项目创建、Item定义、Spider编写、Pipeline配置及Settings设置等完整步骤,代码示例仅展示前10页数据抓取逻辑,适合Python初学者参考学习。
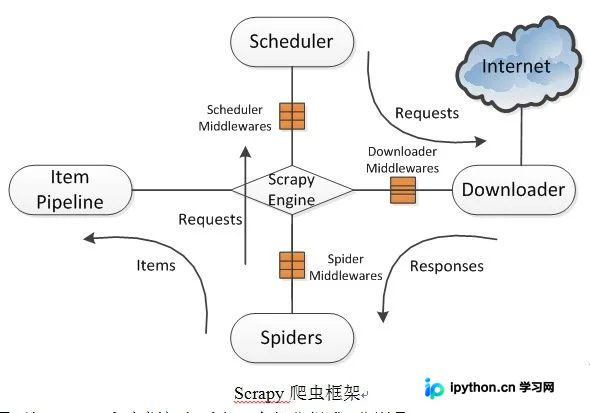
本文深入解析Scrapy网络爬虫框架的工作原理,详细阐述引擎、调度器、下载器、蜘蛛及管道五大核心组件的交互流程。同时提供基于Scrapy创建爬虫项目的完整命令行操作指南,涵盖项目结构解析、关键配置文件说明及程序执行方法,帮助开发者快速掌握Scrapy的数据采集与处理流程。
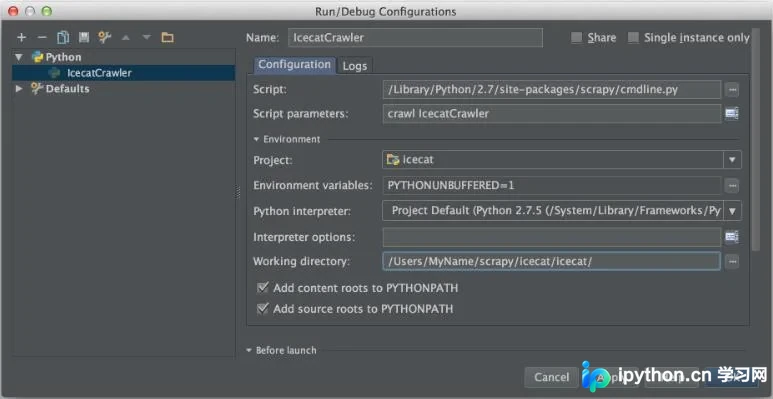
本文详细介绍如何在PyCharm集成开发环境中执行Scrapy爬虫命令。通过解析Scrapy二进制文件背后的Python脚本机制,指导用户定位并配置PyCharm的命令行运行支持文件。重点讲解如何在Script parameters中正确填写爬虫名称等执行参数,从而实现在IDE内直接运行如scrapy crawl等命令,提升开发调试效率。
本文详细讲解如何在Python环境中安装Scrapy爬虫框架,并介绍如何利用PyCharm完成项目的初始化与Spider创建。内容涵盖使用国内豆瓣源解决安装慢的问题、验证安装版本、通过命令行创建项目结构以及在IDE中生成Spider模板的完整操作流程,帮助开发者快速上手Scrapy开发。
本文介绍如何在Scrapy中集成PhantomJS以实现异步AJ数据爬取。通过重写Downloader并引入Semaphore控制并发,解决传统同步集成的性能瓶颈。代码展示了如何配置PhantomJSDownloadHandler,利用线程池和队列管理浏览器实例,从而在保持Scrapy高效并发能力的同时,处理需要JavaScript渲染的网页内容。
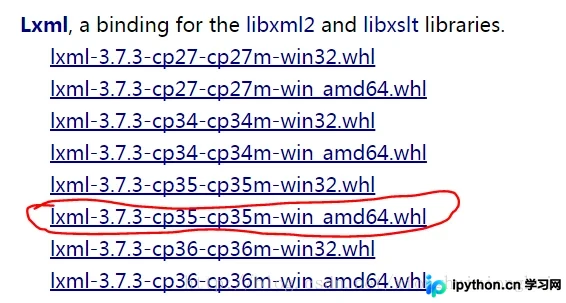
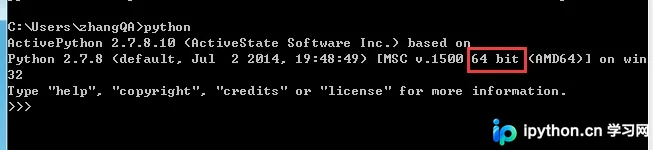
本文详细介绍在Windows 7系统下搭建Python Scrapy爬虫环境的具体步骤。重点讲解64位环境下需预先安装pywin32、pyOpenSSL、lxml及VCForPython27等依赖组件,以避免pip安装scrapy时出错。同时涵盖32位系统的配置差异及安装验证方法,确保环境正确运行。
本文深入解析Scrapy框架的数据流向及核心组件。详细阐述引擎、调度器、下载器与Spider间的数据交互过程,并重点剖析DownloaderMiddleware与SpiderMiddleware的作用位置及核心方法,包括process_request、process_response和process_exception的具体行为与返回值处理,帮助开发者掌握Scrapy内部机制。
本文介绍如何使用Scrapy框架结合PhantomJS处理动态加载网页数据。通过配置Selenium中间件拦截请求,利用JavaScript渲染页面源码,并在Spider中解析HTML提取商品信息。随后通过Item定义数据结构,利用Pipeline将数据写入SQLite数据库,完整演示从配置到入库的技术流程。
本文详细介绍在Windows系统中手动安装Python爬虫框架Scrapy的全过程。重点解析lxml、parsel、twisted等核心依赖库的安装方法,针对Windows下常见的Twisted编译报错问题,提供通过Gohlke官网下载离线whl文件并手动安装的解决方案,确保读者能顺利搭建开发环境。
本文介绍在Windows 7系统中使用Python 3.5安装Scrapy时,如何解决“Unable to find vcvarsall.bat”编译错误。通过推荐下载lxml和Twisted的wheel文件并手动安装,避免安装Visual Studio 2015,从而简化部署流程。