怎么在Dify GitHub提交Issue反馈Bug或建议
详细讲解在 Dify GitHub 官方开源仓库提交 Issue 反馈 Bug 或提出功能建议的完整步骤、准备工作、模版填写规范与常见注意事项。
2026-11-04
22
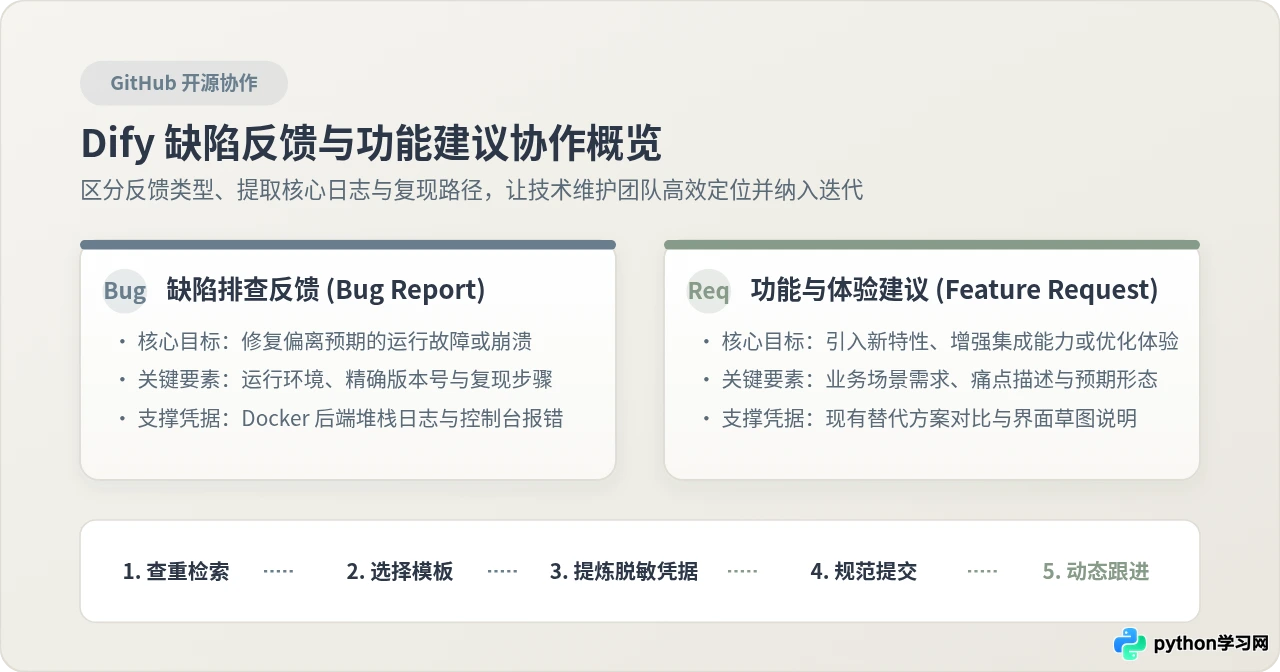
详细讲解在 Dify GitHub 官方开源仓库提交 Issue 反馈 Bug 或提出功能建议的完整步骤、准备工作、模版填写规范与常见注意事项。
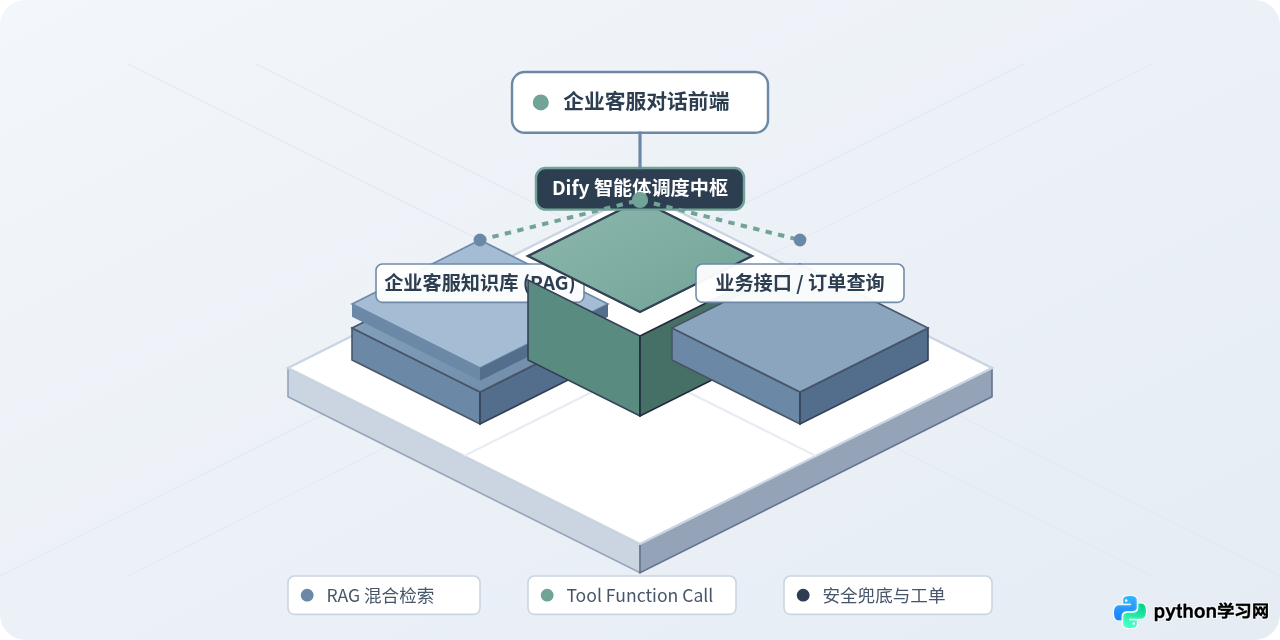
本文结合B2B企业真实落地案例,系统讲解如何基于开源大模型应用开发平台Dify,从知识库数据清洗切分、混合检索与Rerank重排调优、智能体工作流决策路由、外部业务API工具接入到企业多渠道嵌入,完整搭建高准确率、防幻觉的企业级客服机器人。
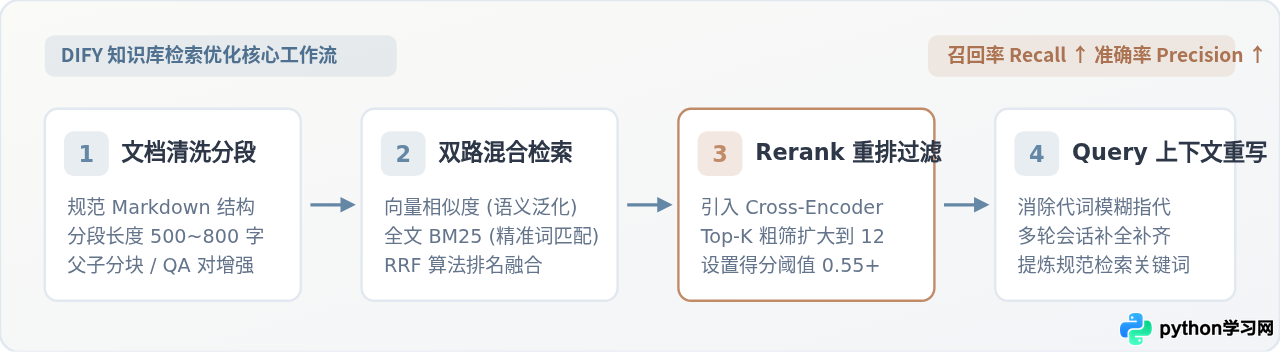
针对Dify智能体在知识库检索中常见的漏召回、跑偏及幻觉问题,系统讲解文档预处理分段、向量与全文混合检索、Rerank重排序打分及Query前置重写的端到端调优方法。
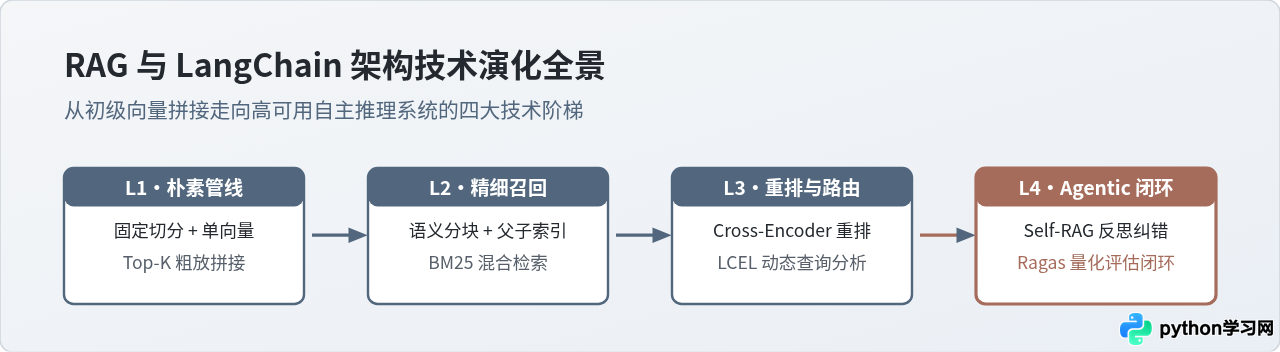
本文梳理 Python 大模型应用开发中从 Naive RAG 迈向生产级系统的进阶路线,系统讲解文档切块、混合检索、Cross-Encoder 重排序、LCEL 查询路由与 Agentic 纠错闭环等核心技术与实战代码。
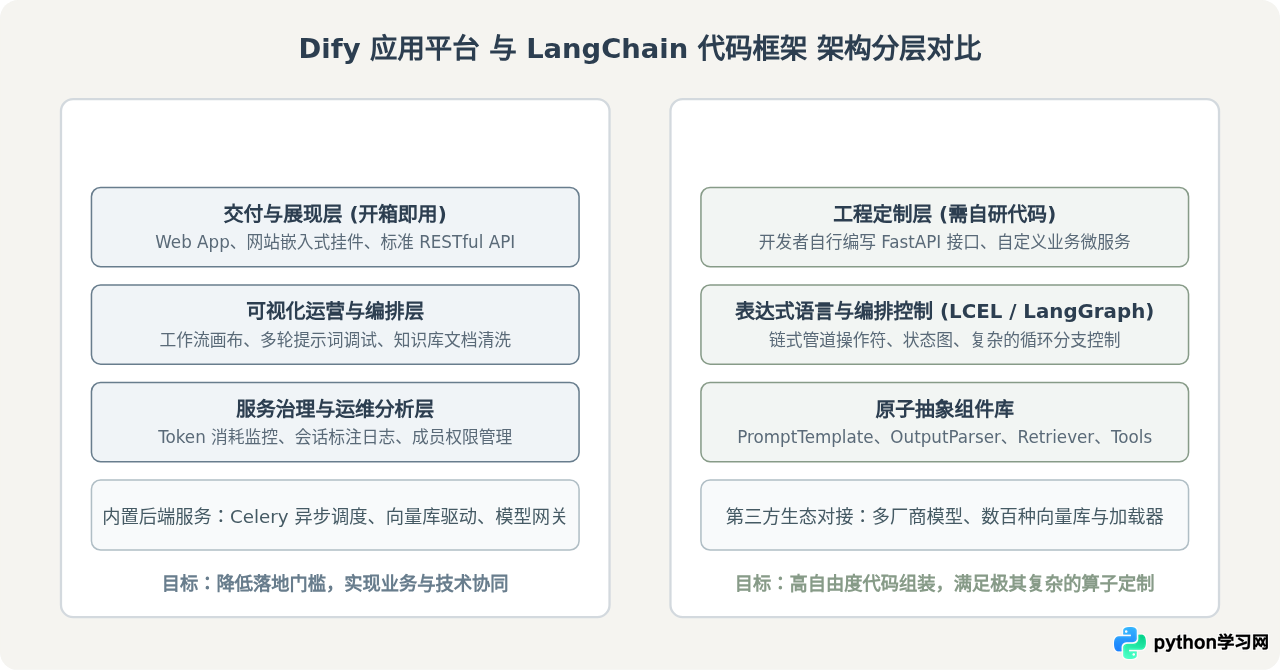
深入对比 Dify 与 LangChain 的核心差异:从应用平台与代码框架的定位分野、RAG 落地流程、开发调试体验到实际团队选型建议。
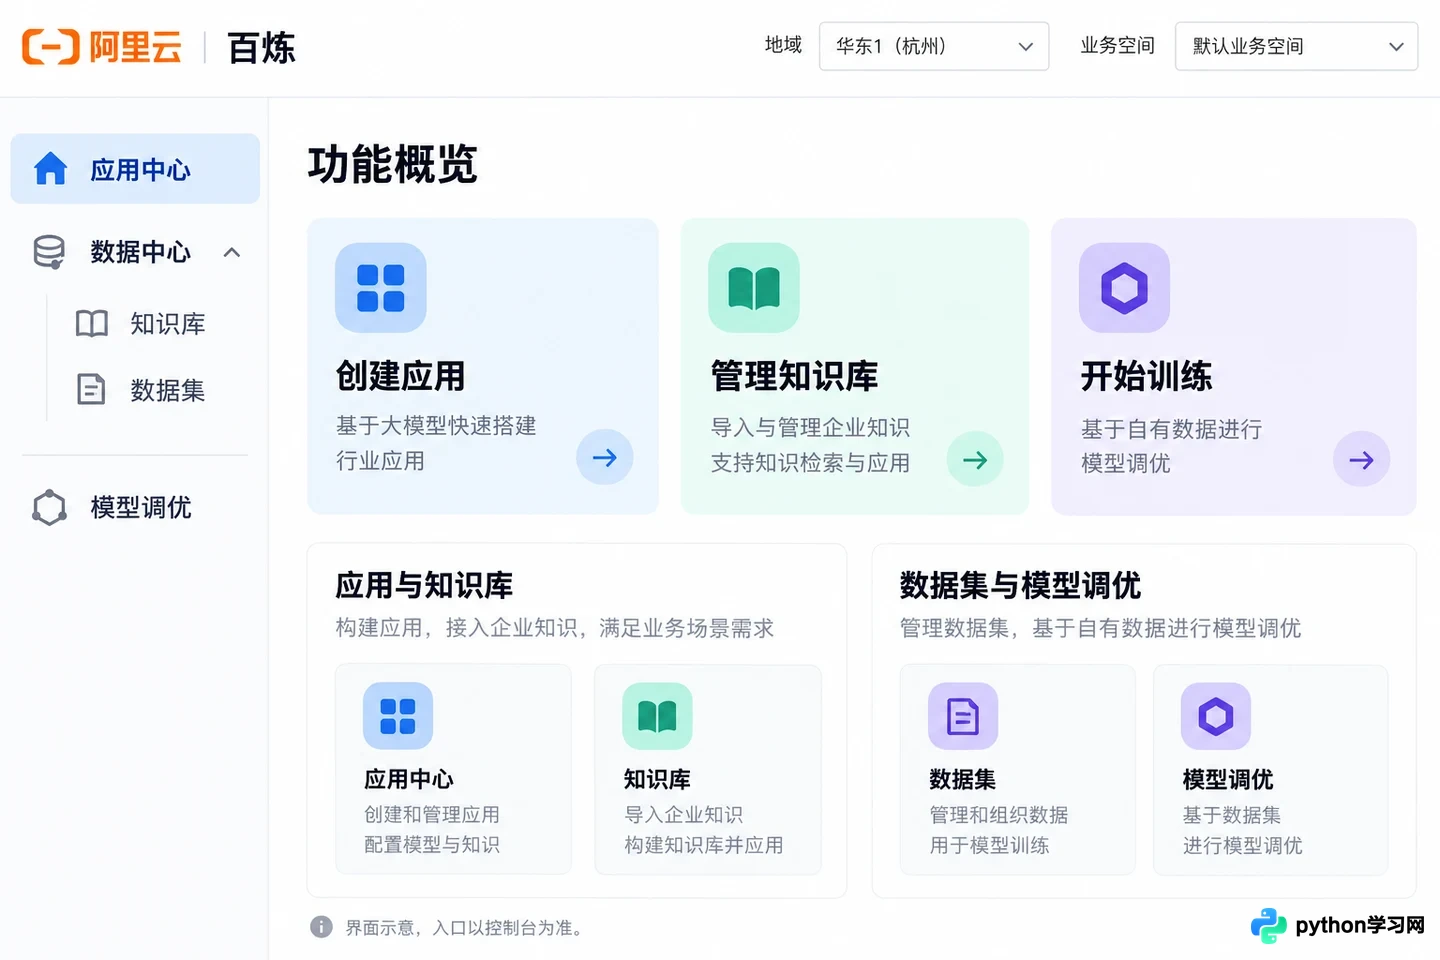
本文以阿里云百炼控制台为例,解析大模型开发中的关键界面模块。通过区分“应用与知识库”和“数据集与模型调优”两条主线,介绍如何配置RAG检索增强生成应用,以及如何准备数据并进行SFT微调,帮助开发者理清从知识接入到模型优化的完整链路。
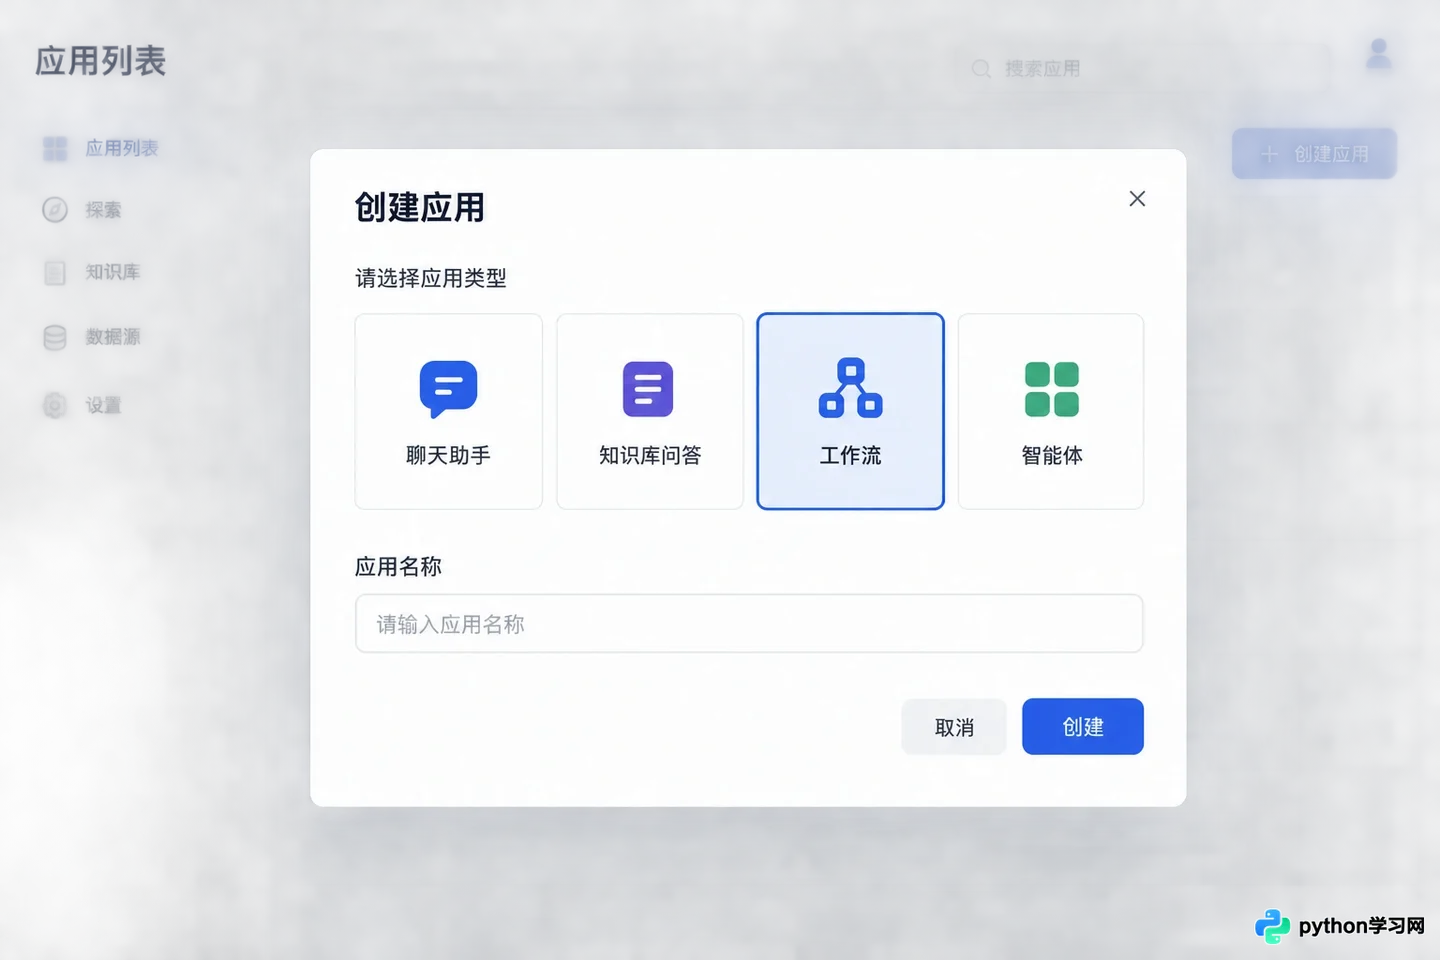
本文介绍如何使用Dify平台的可视化工作流功能,通过拖拽组件和配置参数,零代码构建具备业务逻辑的AI智能体。涵盖从创建应用、设计工作流节点到测试发布的完整流程,适合非技术人员快速上手。
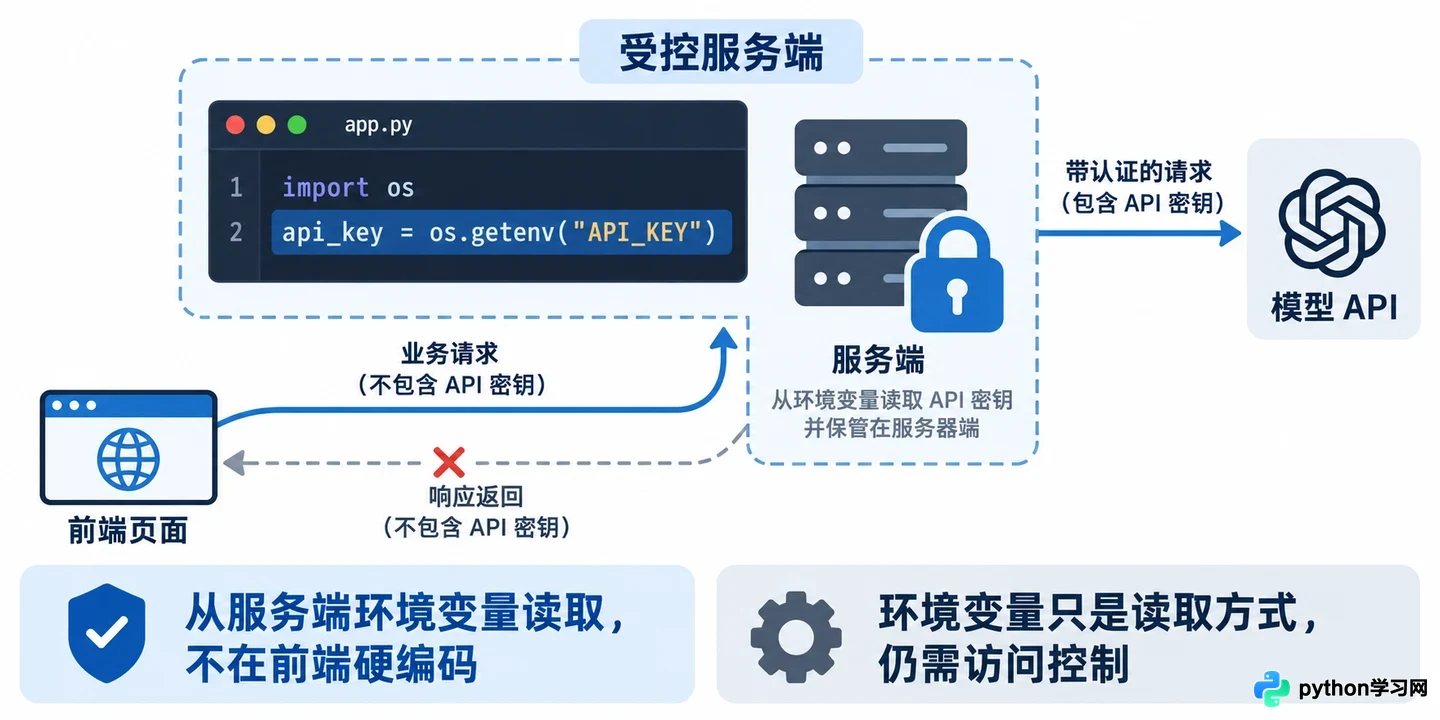
本文从实际业务接入场景出发,解析大模型平台的核心价值。区别于单纯的模型能力展示,文章重点阐述平台如何通过API管理、RAG知识库构建、差异化部署策略及评估监控体系,屏蔽底层算力复杂性,将演示级的聊天功能转化为可维护、可控的企业级服务。
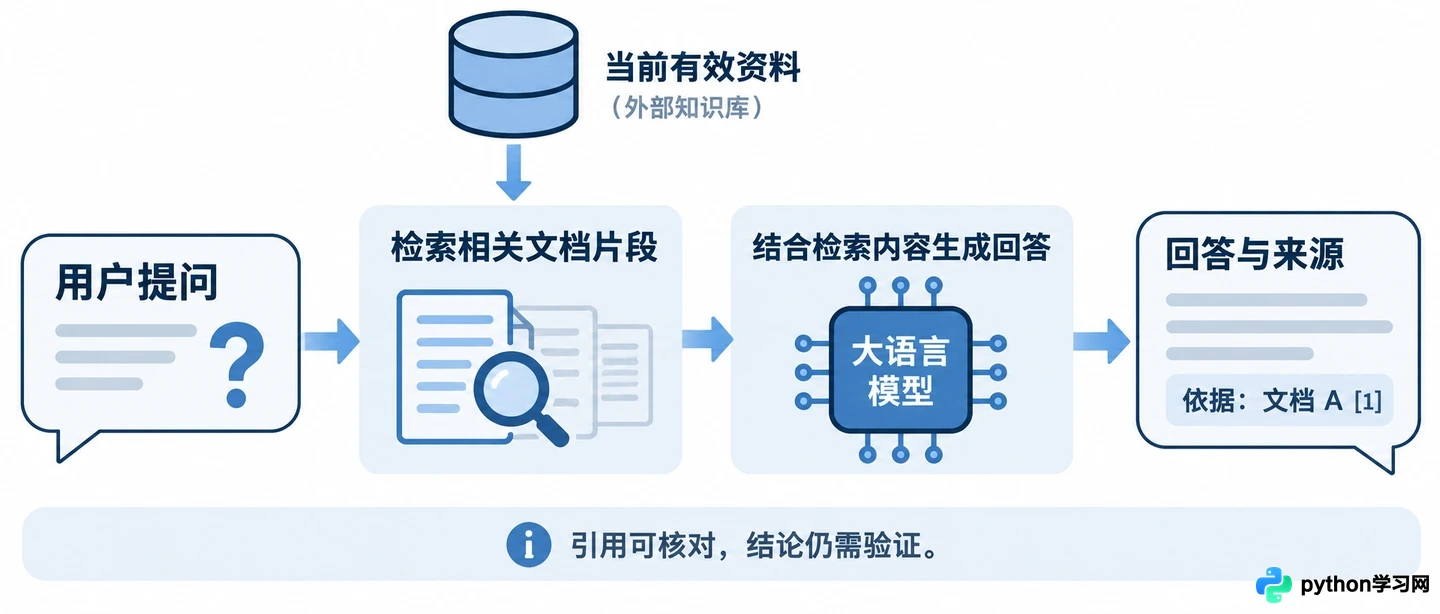
本文通过维修流程更新和工单格式化两个典型场景,深入对比RAG(检索增强生成)与模型微调(Fine-tuning)的核心差异。文章指出,RAG擅长处理动态变化的事实性知识,而微调更适合固化稳定的任务行为与输出规范。两者并非互斥,在复杂业务中可组合使用,但需明确各自的责任边界与维护成本。
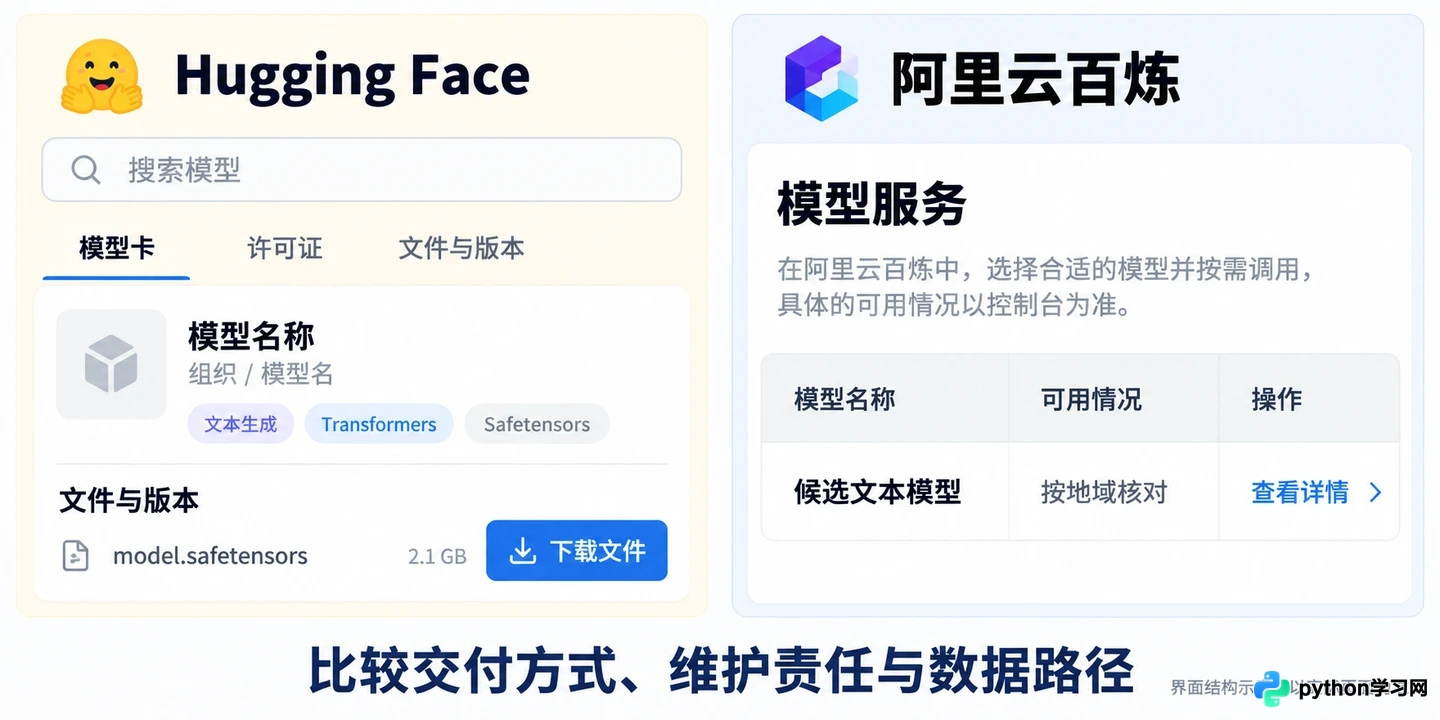
本文通过具体的中文信息抽取任务,对比 Hugging Face 与阿里云百炼在模型获取、在线调用、地域合规及成本结构上的差异。文章不虚构性能排名,而是提供一套可执行的选型核对流程,帮助开发者根据数据敏感性、维护能力和业务场景做出合理选择。
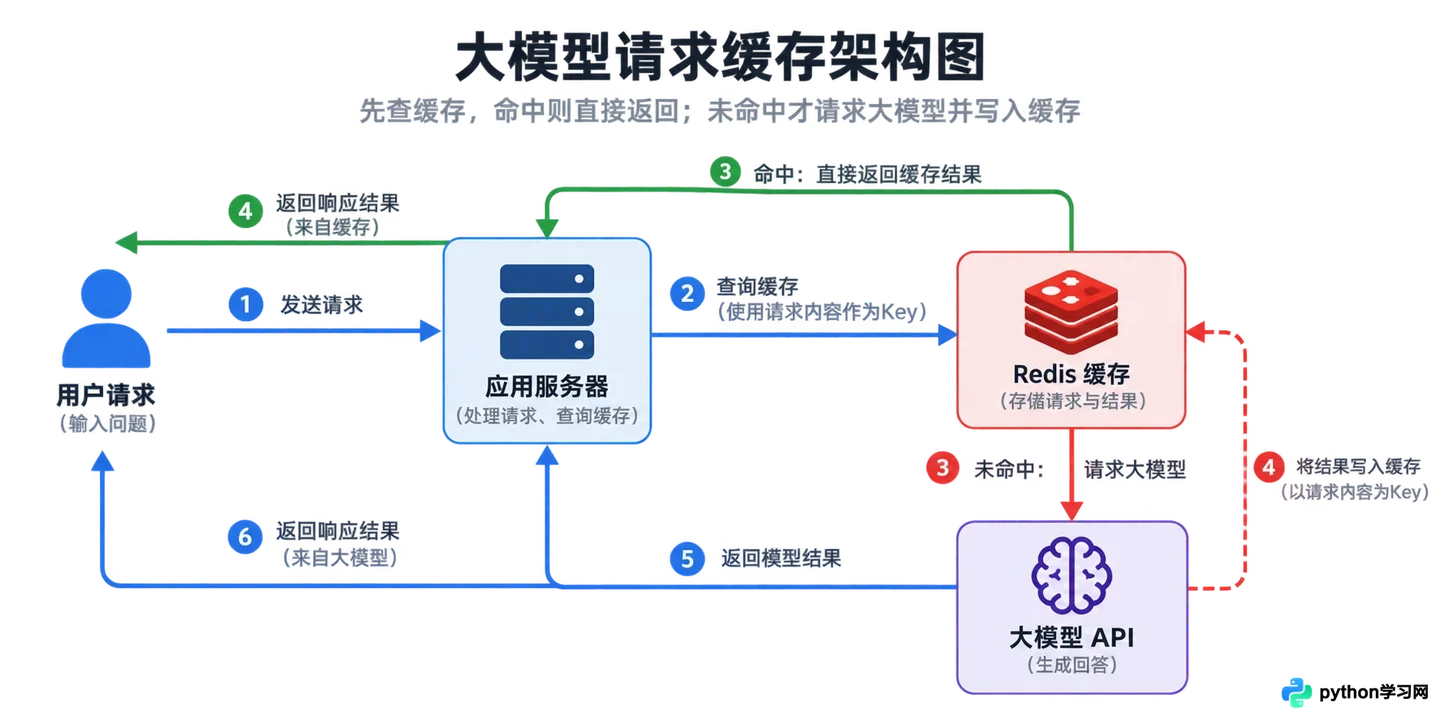
本文针对大模型应用开发中的成本与性能痛点,从缓存机制、流式输出及上下文管理三个维度提供具体优化策略。通过设置合理的TTL缓存、启用SSE流式传输以及实施滑动窗口和摘要压缩,帮助开发者在不牺牲智能度的前提下,显著降低Token消耗并提升用户感知的响应速度。
当团队因提示词版本混乱导致业务异常时,单纯的内容收藏已无法解决问题。本文分析 Langfuse、PromptLayer 和 LangSmith 如何通过版本控制与发布机制解决协作痛点,并探讨 Git 作为轻量级替代方案的适用边界,帮助团队建立可追溯的提示词管理流程。