Python Scrapy框架第一个入门程序示例
本文详细介绍如何使用Python Scrapy框架搭建第一个爬虫项目。内容涵盖从创建项目、定义抓取字段、编写Spider逻辑到配置管道保存数据至MongoDB的完整流程,帮助初学者快速掌握Scrapy的核心使用方法。
2026-10-13
6

本文详细介绍如何使用Python Scrapy框架搭建第一个爬虫项目。内容涵盖从创建项目、定义抓取字段、编写Spider逻辑到配置管道保存数据至MongoDB的完整流程,帮助初学者快速掌握Scrapy的核心使用方法。
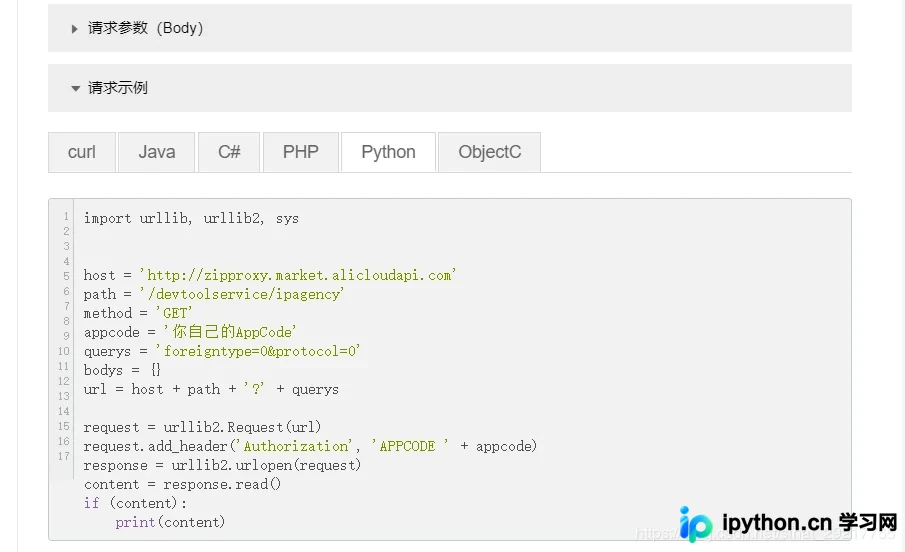
本文详细讲解在Python3 Scrapy框架中配置IP代理的方法。针对阿里云IP代理参数变更及公共IP池不可用的问题,提出结合阿里云API生成有效IP池并在middlewares.py中通过process_request动态设置request.meta['Proxy-Authorization']的解决方案,确保爬虫稳定运行。
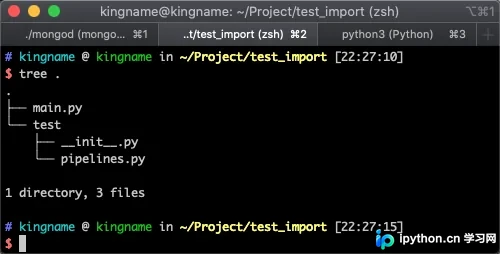
本文详解Python中通过字符串动态导入模块的方法。以Scrapy源码为例,解析如何利用importlib.import_module结合getattr函数,根据完整路径字符串加载指定类。文章提供从路径分割、模块导入到属性获取的完整步骤,并附带测试代码验证其有效性,适用于需要动态加载组件的场景。
本文详解如何在Scrapy框架中集成Selenium以解决动态加载数据的抓取难题。通过重写爬虫构造方法与关闭方法管理浏览器实例,并在下载中间件中拦截Response对象,利用Selenium渲染页面后篡改响应数据,从而在Spider中获取完整的动态内容。
本文详解如何使用Python Scrapy框架爬取豆瓣电影Top250数据,并通过自定义Pipeline将结果持久化至MongoDB数据库。内容涵盖items定义、Spider编写、Pipeline配置及Settings设置,提供完整代码示例与测试步骤,帮助开发者掌握Web爬虫与数据库存储的结合应用。
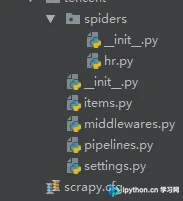
本文详细演示如何使用Scrapy框架创建爬虫项目,定义Items数据结构,编写Spider解析网页HTML并提取职位信息,最后通过Pipeline将数据持久化存储到MongoDB数据库中。涵盖从项目初始化、代码编写到数据落地的完整流程,适合初学者快速掌握Scrapy核心用法。
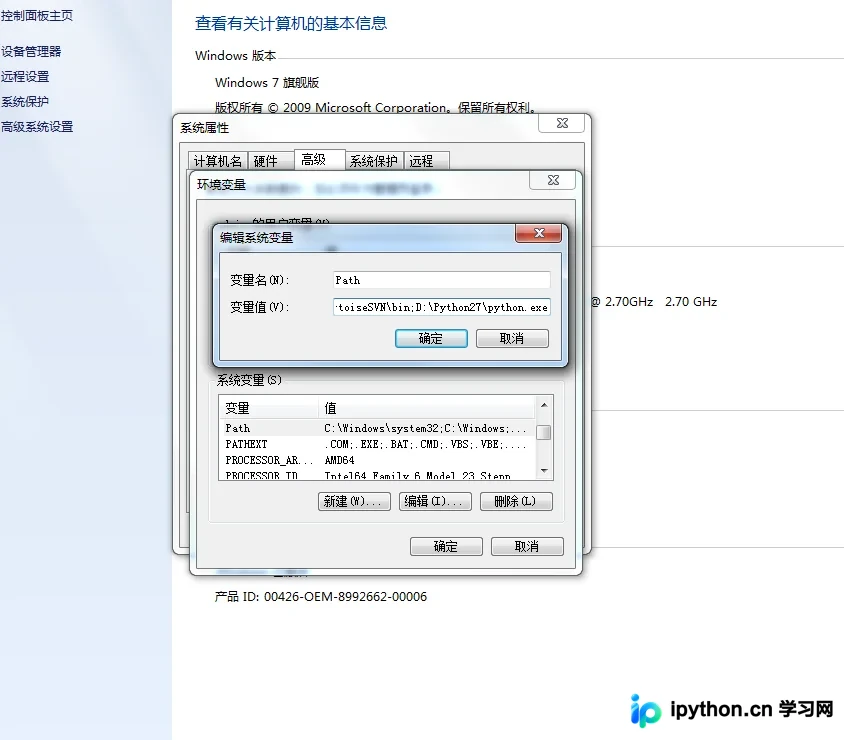
本文详细介绍在 Python 环境中安装 Scrapy 爬虫框架的完整步骤。内容涵盖 Python 环境变量配置、pywin32 组件安装、pip 工具部署以及通过命令行执行安装命令的全过程。最后提供验证 Scrapy 是否安装成功的方法,帮助开发者快速搭建爬虫开发基础环境。
本文深入分析scrapy-redis框架源码,指出其默认仅支持GET请求的限制。通过重写RedisSpider中的make_request_from_data方法,结合FormRequest构造包含url、form_data和meta的POST请求,并演示如何将数据存入Redis以实现分布式POST抓取。
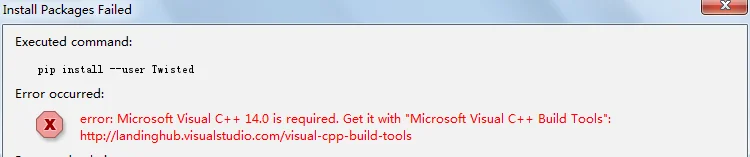
本文记录在Python3.6环境下安装Scrapy依赖模块Twisted时遇到的常见报错问题。通过对比PyCharm与命令行pip安装,发现直接pip install常因版本不匹配失败。最终通过从Gohlke网站下载对应Python位数(32位或64位)的whl文件解决,强调了匹配Python架构的重要性。
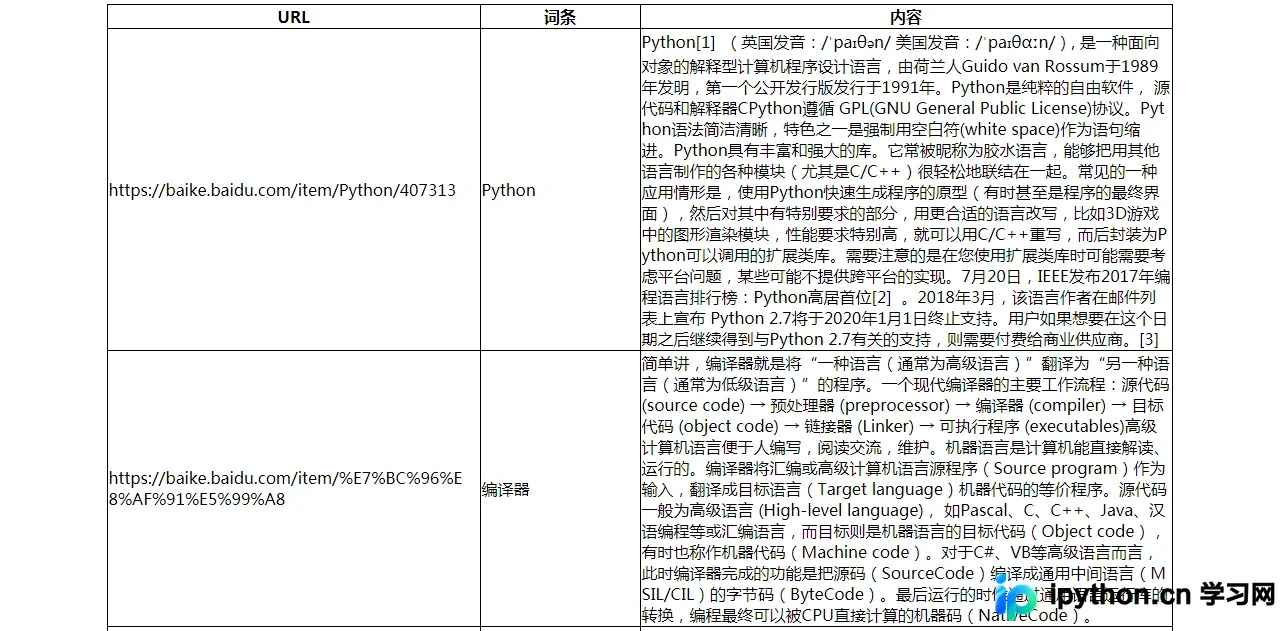
本文详细介绍如何使用Python编写一个完整的网页爬虫程序,重点解析URL管理器、网页下载器、网页解析器和输出处理器四大核心组件的实现逻辑。通过具体代码示例,演示如何从百度百科抓取词条数据,包括链接提取、HTML解析及结果存储,适合Python初学者理解爬虫工作原理。
本文详解如何在Python Scrapy框架中实现数据的异步MySQL存储。通过引入twisted.enterprise.adbapi创建数据库连接池,结合自定义Pipeline与from_settings方法,将爬虫抓取与数据库写入解耦。文章包含settings配置、Item定义、Pipeline实现及错误处理机制,确保高并发爬虫场景下的数据完整性与写入效率。
本文详解如何利用Scrapy框架结合Twisted的ADBAPI实现MySQL数据库的异步写入。通过对比同步操作的局限性,阐述了在高并发爬虫场景下使用异步机制避免数据库崩溃的必要性。文章提供了从Item解析、Pipeline配置到Settings设置的完整代码示例,展示如何高效处理大量数据入库。