

利用Scrapy框架21行代码构建Python爬虫实战指南

发布时间:2026-10-13| 2人浏览过
本文详细介绍如何使用Scrapy框架在PyCharm环境中编写一个仅需21行代码的Python爬虫。通过解析HTML结构定义Item,创建Spider类处理页面数据,并配置Settings以UTF-8编码输出JSON文件。文章还涵盖了运行命令、已知追加数据Bug及定时任务等扩展功能建议,适合初学者快速上手Scrapy基础应用。
开发说明
开发环境选用PyCharm 2017.1(当前最新版本)。
开发框架采用Scrapy 1.3.3(当前最新版本)。
目标
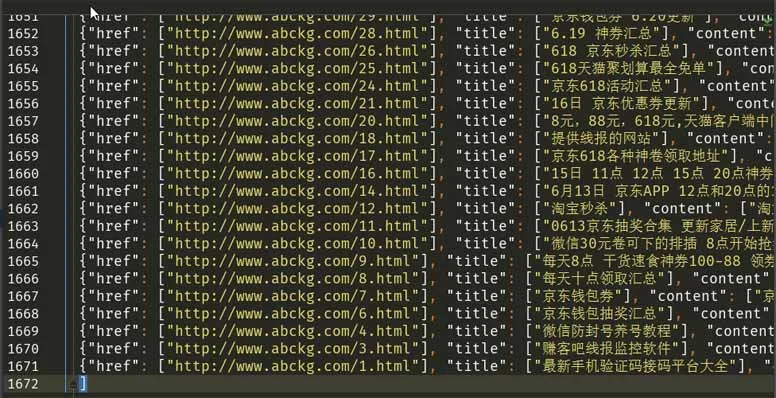
抓取线报网站数据,并将结果保存至items.json文件中。
页面分析
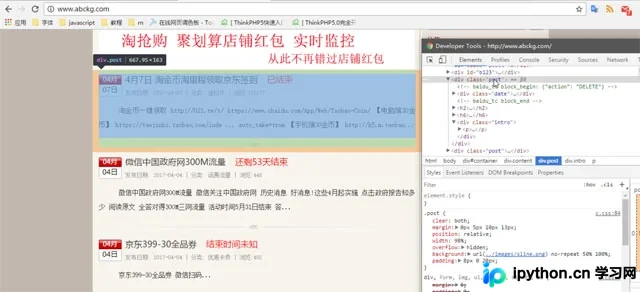
根据上图所示,所有目标内容均位于CSS类名为post的div元素内。
以下是post元素的代码结构展示:
<div class="post">
<!-- baidu_tc block_begin: {"action": "DELETE"} -->
<div class="date"><span>04月</span><span class="f">07日</span></div><!-- baidu_tc block_end -->
<h2><a href="http://www.abckg.com/193.html" rel="external nofollow" title="4月7日 淘金币淘里程领取京东签到" rel="bookmark" target="_blank">4月7日 淘金币淘里程领取京东签到</a><span>已结束</span></h2>
<h6>发布日期: 2017-04-07 | 分类: <a href="http://www.abckg.com/xunibi" rel="external nofollow" >虚拟币</a> | 浏览:125177
</h6><div class="intro"><p>淘金币一键领取 http://021.tw/t/ https://www.chaidu.com/App/Web/Taobao-Coin/ 【电脑端30金币】 https://taojinbi.taobao.com/inde ... auto_take=true 【手机端30金币】 http://h5.m.taobao...</p></div></div>
实现方法
第一步,定义Items数据结构。
class DemoItem(scrapy.Item):
 id = scrapy.Field()
 title = scrapy.Field()
 href = scrapy.Field()
 content = scrapy.Field()
第二步,新建一个名为test的爬虫程序。
# -*- coding: utf-8 -*-
import scrapy
from demo.items import DemoItem
from scrapy.http import Request
class TestSpider(scrapy.Spider):
 #定义爬虫的名字和需要爬取的网址
 name = "test"
 allowed_domains = ["www.abckg.com"]
 start_urls = ['http://www.abckg.com/']
 def parse(self, response):
 for resp in response.css('.post'):
  #实例化item
  item = DemoItem()
  #把获取到的内容保存到item内
  item['href'] = resp.css('h2 a::attr(href)').extract()
  item['title'] = resp.css('h2 a::text').extract()
  item['content'] = resp.css('.intro p::text').extract()
  yield item

 #下面是多页面的爬取方法
 urls = response.css('.pageinfo a::attr(href)').extract()
 for url in urls:
  yield Request(url, callback=self.parse)
 categorys = response.css('.menu li a::attr(href)').extract()
 for ct in categorys:
  yield Request(ct, callback=self.parse)
第三步,修改settings.py配置文件,添加以下代码以设置编码格式。
FEED_EXPORT_ENCODING = 'utf-8'
#运行
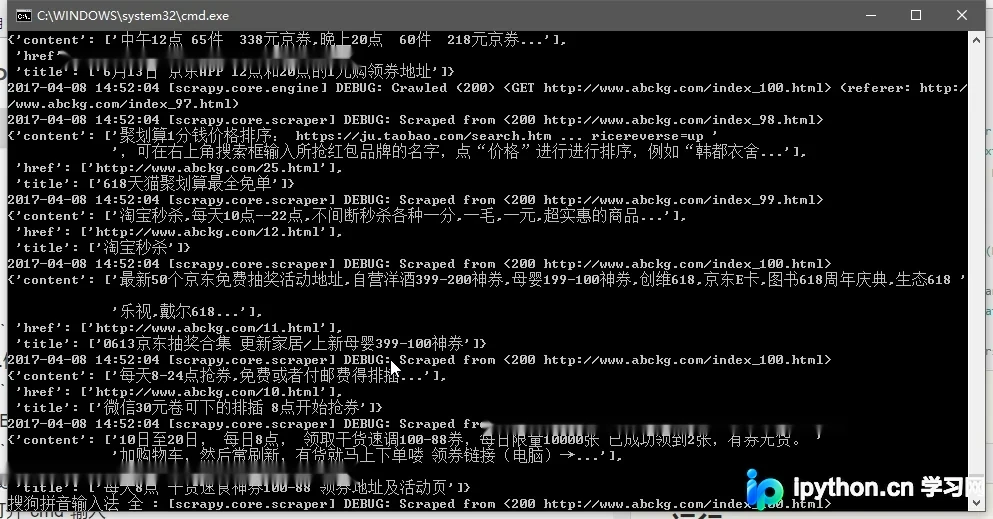
打开命令行工具(CMD)输入以下命令执行爬虫。
scrapy crawl test -o items.json
已知bug
若多次运行该爬虫,原有内容不会被覆盖,而是追加数据(这似乎是Scrapy的一个已知特性或Bug)。
可拓展内容
1、实现定时运行爬虫,当检测到网站更新时获取新数据并通过邮件发送通知。
2、增加数据重复检测机制。
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或者使用python能带来一定的帮助,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









