

Scrapy结合Selenium动态加载页面抓取实战
针对淘宝、京东等动态加载网站,直接请求无法获取完整数据。本文介绍如何在Scrapy框架中通过中间件集成Selenium,利用无头浏览器模拟滚动和交互,获取渲染后的完整HTML源码,并构造HtmlResponse对象直接返回,从而绕过传统下载器,实现高效的数据抓取。
2026-10-13
6

针对淘宝、京东等动态加载网站,直接请求无法获取完整数据。本文介绍如何在Scrapy框架中通过中间件集成Selenium,利用无头浏览器模拟滚动和交互,获取渲染后的完整HTML源码,并构造HtmlResponse对象直接返回,从而绕过传统下载器,实现高效的数据抓取。
本文介绍在Mac系统中通过Homebrew安装Python 3后,利用自动生成的pip3工具快速安装requests和Scrapy第三方库的方法。文章简要说明了从Python 2过渡到Python 3的需求,并提供了具体的命令行安装步骤,帮助用户解决Mac环境下Python库配置问题。
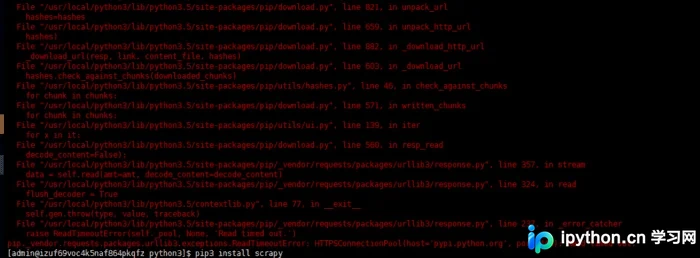
本文解决在Mac系统(如OSX 10.11及更高版本)中安装Python爬虫框架Scrapy时遇到的“Operation not permitted”错误。该问题通常由旧版Python(如2.7)与新系统权限机制冲突导致,通过升级Python版本即可有效解决。
本文系统梳理Python爬虫工程师面试中的核心问题,涵盖if __name__机制、Python内存管理(引用计数与垃圾回收)、对象拷贝差异、异常处理、常用爬虫库对比及反爬应对方案。深入解析Django与Flask选型、多线程异步优化、POST/GET区别及Lambda表达式,为求职者提供实用的技术参考。
本文详细介绍在 CentOS 7 系统中编译安装 Python 3.5.5 及 Scrapy 框架的完整步骤。内容涵盖开发工具依赖安装、Python 源码编译、软链接配置以及 Scrapy 的安装与验证,确保在不破坏系统原有 Python 2.7 的前提下完成环境搭建。
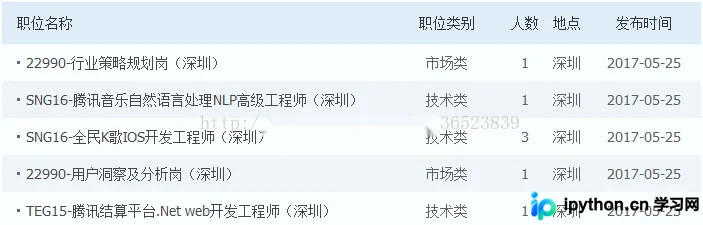
本文介绍如何使用Python3和Scrapy框架爬取腾讯招聘网信息并生成CSV文件。通过调用cmdline命令而非导入csv模块,实现高效数据导出。示例包含items定义、Spider编写及yield用法解析,适合新手参考学习。
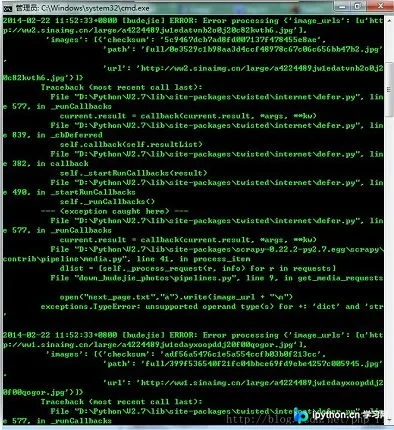
本文介绍如何在Windows环境下使用Scrapy框架时,将控制台打印的运行及调试信息保存至文本文件。通过指定LOG_FILE参数,解决CMD窗口信息滚动导致无法查看完整日志的问题,便于后续排查爬虫运行中的错误或调试细节。
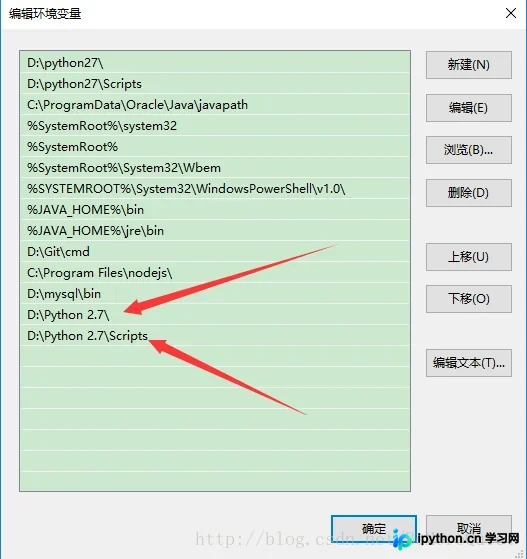
本文详细记录了在Python 2.7环境下安装Scrapy框架的全过程。针对Scrapy不支持Python 3.x的特性,介绍了从环境配置到依赖库安装的步骤。重点解决了pip安装时因中文用户目录导致的编码异常,以及lxml编译所需的VC环境依赖问题,提供了通过sitecustomize.py和VcForPython解决报错的具体方案,确保用户能顺利部署爬虫框架。
本文针对Windows 10环境下Python 3.6.64位安装Scrapy时遇到的“Microsoft Visual C++ 14.0 is required”错误,提供无需编译的解决方案。通过从UCI LFD网站下载对应版本的Twisted whl文件,并使用pip命令本地安装,可绕过编译工具缺失问题,成功完成Scrapy部署。
本文记录在 CentOS 系统中从源码编译安装 Python 3.5.3 并配置 Scrapy 爬虫框架依赖包的完整过程。重点解决系统缺失 sqlite3 导致的 Python 编译失败问题,通过手动编译 sqlite3 源码并修改 setup.py 指定路径,成功构建支持数据库操作的 Python 环境,最后列出 fake-useragent、pymysql 等关键依赖包的安装命令。
本文系统梳理Scrapy框架的五大核心命令行操作,涵盖从项目初始化、Spider文件生成到程序执行及交互式调试的完整流程。详细解析scrapy startproject、genspider、crawl及shell等关键指令的语法结构与使用场景,帮助开发者快速掌握Scrapy基础工作流,提升爬虫开发与调试效率。
本文深入讲解使用Python Scrapy框架爬取京东商城的进阶技巧。内容涵盖构造奇数页请求、解析首屏数据、处理Ajax异步加载的后半部分商品信息,以及通过Meta传递参数。同时提供断点续爬、下载延迟、随机延迟、忽略Robots协议及并发控制等settings.py配置技巧,帮助开发者高效获取商品详情并避免被封禁。