Python实现贴吧图片爬虫:从环境配置到代码解析
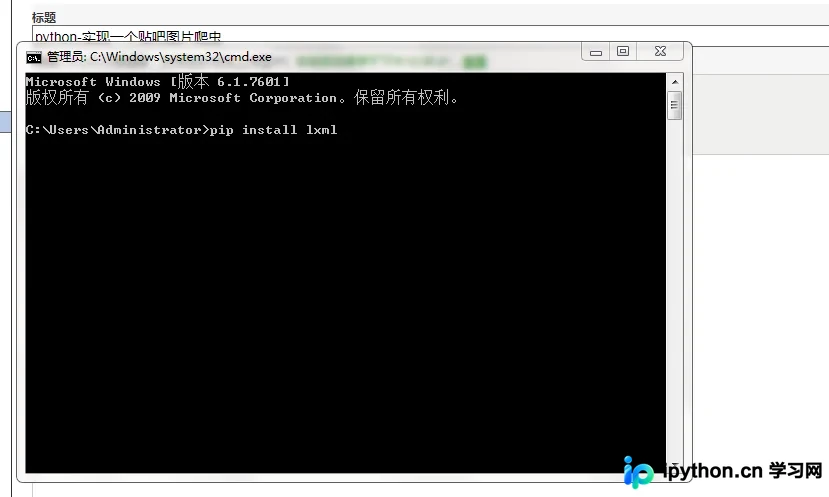
本文详细介绍如何使用Python2编写贴吧图片爬虫。通过安装Lxml库并利用Chrome插件辅助分析HTML结构,利用XPath精准定位图片链接。文章包含完整代码示例及注释,指导开发者从环境搭建到代码运行,实现批量下载指定贴吧的图片资源。
2026-10-13
7

本文详细介绍如何使用Python2编写贴吧图片爬虫。通过安装Lxml库并利用Chrome插件辅助分析HTML结构,利用XPath精准定位图片链接。文章包含完整代码示例及注释,指导开发者从环境搭建到代码运行,实现批量下载指定贴吧的图片资源。
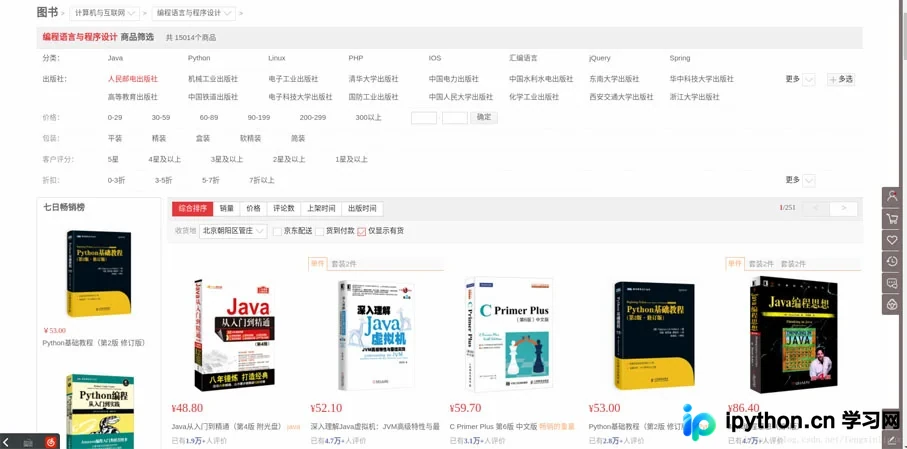
本文详细介绍如何利用Python 3编写图片爬虫,从京东网站批量下载编程类图书封面。通过解析URL分页规律,结合正则表达式对HTML源码进行两次过滤,精准提取商品图片链接,并使用urllib库实现本地存储。文中包含完整代码示例及异常处理逻辑,适用于学习网络爬虫基础与数据抓取技术。
本文介绍基于Python3.4编写的简易爬虫程序,利用urllib和re模块抓取指定微博用户的头像图片。代码包含设置User-Agent、处理Cookie及正则表达式匹配等关键步骤,适合初学者学习网络请求与数据解析基础。
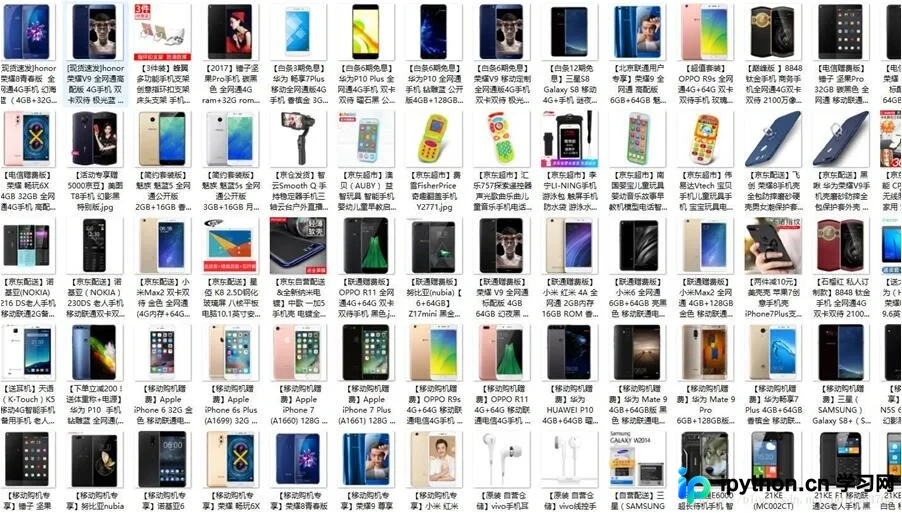
本文介绍使用Python 2.7结合urllib与BeautifulSoup库,实现从京东网站批量爬取商品图片的方法。通过解析页面DOM结构获取图片链接与商品名称,自动创建目录并按名保存。代码包含URL构造、异常处理及进度显示,适用于学习网页抓取与文件存储操作。
本文详细介绍Python中Beautiful库的HTML解析方法。内容涵盖安装步骤、解析器选择(lxml/html5lib)、基础代码示例及利用select方法结合CSS选择器定位元素。通过具体案例演示如何提取页面数据,适合初学者快速掌握网页内容抓取技巧。
本文介绍Python3中如何使用BoundedSemaphore限制线程并发数量。通过示例代码展示如何初始化信号量并配合with语句在爬虫场景中控制同时活动的线程数,确保资源不被过度占用。
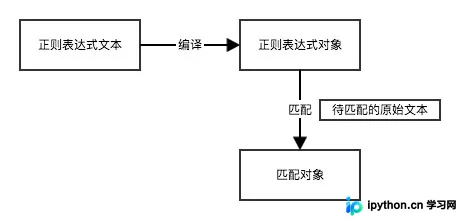
本文系统讲解Python中正则表达式的核心概念,涵盖原始字符串定义、基础与预设元字符、边界与重复匹配、逻辑分支及分组技巧。重点解析贪婪与非贪婪模式,并结合爬虫场景演示如何利用sub函数与正则表达式进行HTML标签处理与路径替换,帮助开发者高效处理文本提取与验证任务。
本文详解如何利用Python的Requests库模拟网站登录并维持Cookie状态。针对nosec.org等需要动态Token的网站,通过解析页面获取authenticity_token,结合用户名密码POST提交,实现自动登录。文章提供完整代码示例,解析Session对象复用机制,帮助开发者解决爬虫登录验证及会话保持问题。
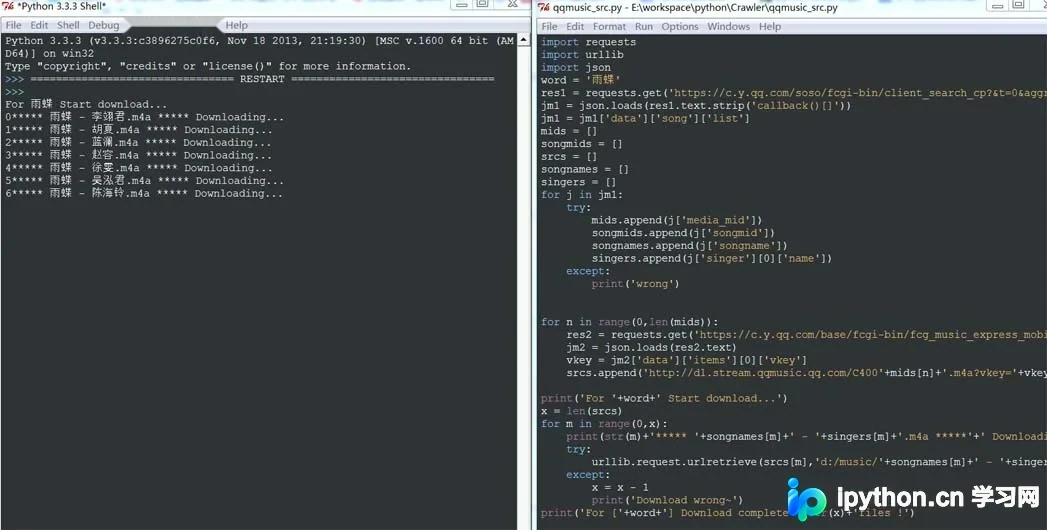
本文详细介绍如何利用Python编写爬虫程序,通过构造特定URL参数获取QQ音乐的播放链接(vkey),并实现批量下载功能。文章涵盖从搜索接口到文件下载的完整流程,提供Python 3.3.3环境下的代码示例与运行效果分析,适合希望自动化获取音乐资源的开发者参考。
本文详解Python爬虫中常见的403禁止访问错误原因,介绍通过urllib2模块添加User-Agent、Host和Referer等请求头来伪装浏览器访问的方法,并提供封装好的随机User-Agent选择函数代码,帮助开发者绕过基础反爬限制。
本文详解Python环境下Scrapy框架的安装配置及常见错误解决,并通过两个实例演示如何使用urllib和re模块爬取静态网页图片及处理百度图片滚动加载的反爬虫机制,提供完整代码与注意事项。
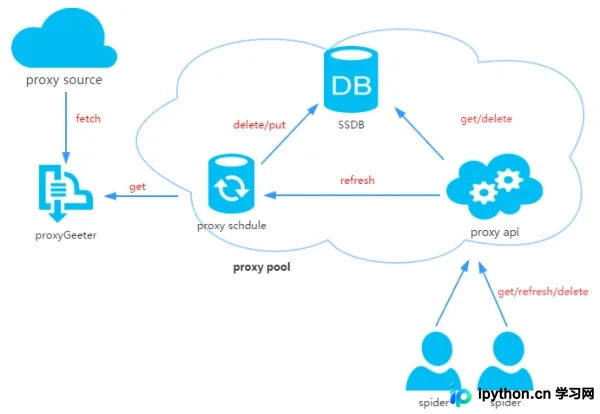
本文详细介绍如何使用Python搭建一个轻量级的分布式爬虫代理IP池。通过整合多个免费代理源,利用SSDB进行高性能存储,并结合Flask提供RESTful API接口。文章涵盖代理获取、质量检测、定时刷新及爬虫调用等核心模块,帮助开发者快速实现稳定高效的代理IP管理服务。