

Python实现百度贴吧图片爬虫完整示例
本文提供Python实现的百度贴吧图片爬取完整示例。代码涵盖贴吧名称、页码范围输入,利用urllib构造请求URL,通过lxml解析HTML获取图片链接,并使用requests下载图片保存至本地。示例包含完整的类定义与执行逻辑,供Python学习者参考。
2026-10-13
7

本文提供Python实现的百度贴吧图片爬取完整示例。代码涵盖贴吧名称、页码范围输入,利用urllib构造请求URL,通过lxml解析HTML获取图片链接,并使用requests下载图片保存至本地。示例包含完整的类定义与执行逻辑,供Python学习者参考。
本文详细介绍使用Python 2.7环境爬取12306验证码的方法。通过构造请求、处理SSL证书验证及文件写入,实现验证码的批量保存。文章还分析了12306验证码的结构特点及识别难点,为后续图像识别训练提供数据基础。
本文介绍如何使用Python的urllib和BeautifulSoup库爬取网页数据,并通过json模块将提取的信息保存为JSON格式文件。示例代码展示了设置请求头、解析HTML、遍历元素及处理文件写入的完整流程,适用于基础数据抓取场景。
本文详细解析使用Python爬取微博特定用户评论的技术流程。针对微博主页及详情页的Ajax动态加载特性,通过逆向分析接口规律获取数据。重点介绍如何处理源码中的转义字符与HTML实体编码,利用正则表达式提取关键ID,并拼接评论接口URL。文中包含完整的代码实现及Cookie配置注意事项,旨在帮助开发者掌握动态网页数据抓取的核心技巧。
本文详解如何在Python Scrapy框架中实现数据的异步MySQL存储。通过引入twisted.enterprise.adbapi创建数据库连接池,结合自定义Pipeline与from_settings方法,将爬虫抓取与数据库写入解耦。文章包含settings配置、Item定义、Pipeline实现及错误处理机制,确保高并发爬虫场景下的数据完整性与写入效率。
本文深入解析Python的核心价值与应用场景。作为一门动态面向对象语言,Python凭借简洁语法和C语言底层支持,广泛应用于Web开发、数据科学(机器学习与可视化)、网络爬虫采集、自动化运维及嵌入式与游戏开发。了解Python的实际用途,助力技术选型与职业发展。
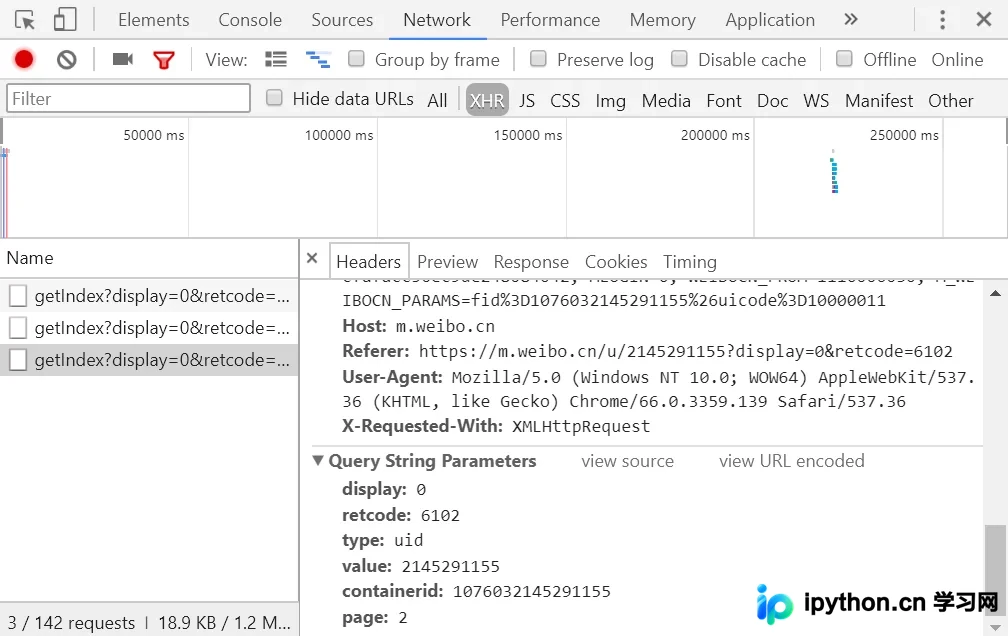
本文通过Python代码演示如何抓取马云的微博内容。首先利用浏览器开发者工具分析Ajax请求,识别GET请求中的关键参数及分页机制。接着解析返回的JSON数据,提取cardlistInfo中的总数量及cards中的微博正文、点赞、评论和转发数。最后结合Requests与PyQuery库,实现批量获取并保存微博信息至本地文件。
本文介绍如何利用Python的BeautifulSoup库批量从城市美食及景点介绍等HTML页面中提取body标签内的具体内容。通过遍历目录结构并解析文件,实现自动化数据抓取与存储,为后续数据处理提供基础。
本文介绍利用Python编写爬虫程序,自动从指定网站批量抓取动态GIF图片的方法。通过解析HTML页面获取图片链接,并实现多页循环下载与本地存储,解决手动保存繁琐及部分网站禁止右键的问题。
本文详细介绍如何使用Python构建基础爬虫架构。通过解析urllib库的网络请求功能与BeautifulSoup的HTML解析能力,演示从导入模块、打开网址到提取节点信息的完整流程。同时涵盖常见错误如HTTPError和None值的排查与处理,帮助开发者掌握基础爬虫的核心步骤与异常处理机制。
本文详细介绍在Windows 7系统下搭建Python Scrapy爬虫环境的具体步骤。重点讲解64位环境下需预先安装pywin32、pyOpenSSL、lxml及VCForPython27等依赖组件,以避免pip安装scrapy时出错。同时涵盖32位系统的配置差异及安装验证方法,确保环境正确运行。
本文介绍了一种将Python爬虫获取的图片写入Word文档的方法。针对直接保存二进制数据导致乱码的问题,提出先本地保存图片、利用python-docx库插入图片后再删除本地文件的思路。通过具体代码示例,展示了如何结合requests和BeautifulSoup解析网页,并使用docx库实现图文混排保存,供爬虫开发者参考。