

Python实现贴吧图片爬虫:从环境配置到代码解析

本文详细介绍如何使用Python2编写贴吧图片爬虫。通过安装Lxml库并利用Chrome插件辅助分析HTML结构,利用XPath精准定位图片链接。文章包含完整代码示例及注释,指导开发者从环境搭建到代码运行,实现批量下载指定贴吧的图片资源。
近期完成了一个贴吧图片下载工具的开发,开发环境选用PyCharm,该工具在Python开发中具有较高的实用性。此前曾尝试使用Eclipse,但在类库集成与操作便捷性上表现不佳,因此最终选择专业的Python开发工具。当前使用的Python版本为2,这源于大学时期自学Python时使用的是该版本。
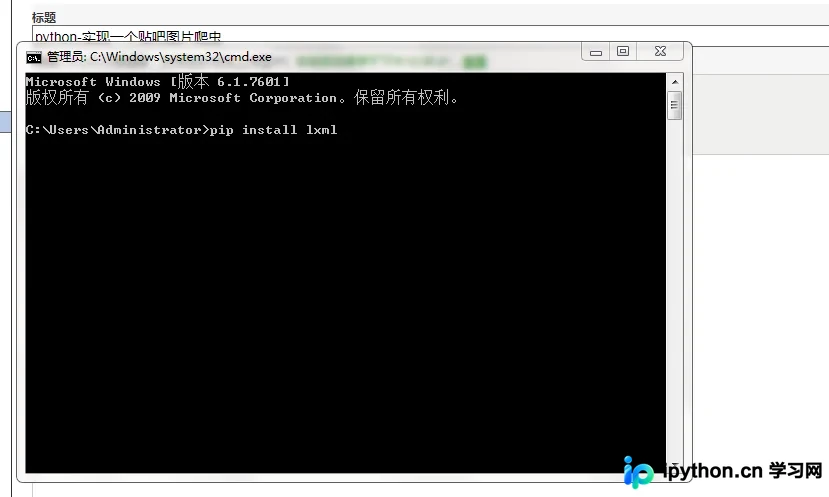
第一步操作是在命令行窗口(cmd)中执行安装命令:pip install lxml,以获取必要的解析库支持。
安装过程及结果如图所示。
第二步,需下载并安装一个Chrome浏览器插件,该插件专门用于将HTML文件转换为XML格式,从而支持通过XPath技术进行元素定位。
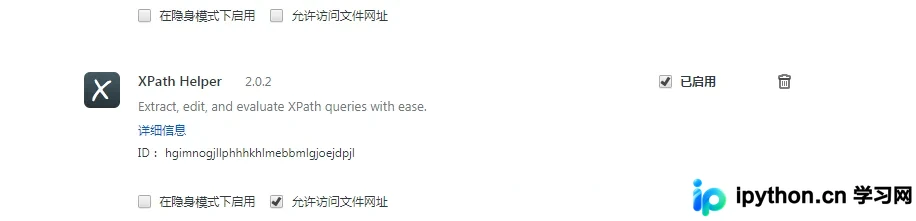
在目标网页界面按下快捷键Ctrl+Shift+X,即可启动插件进入页面分析模式。
具体操作界面如下图所示。
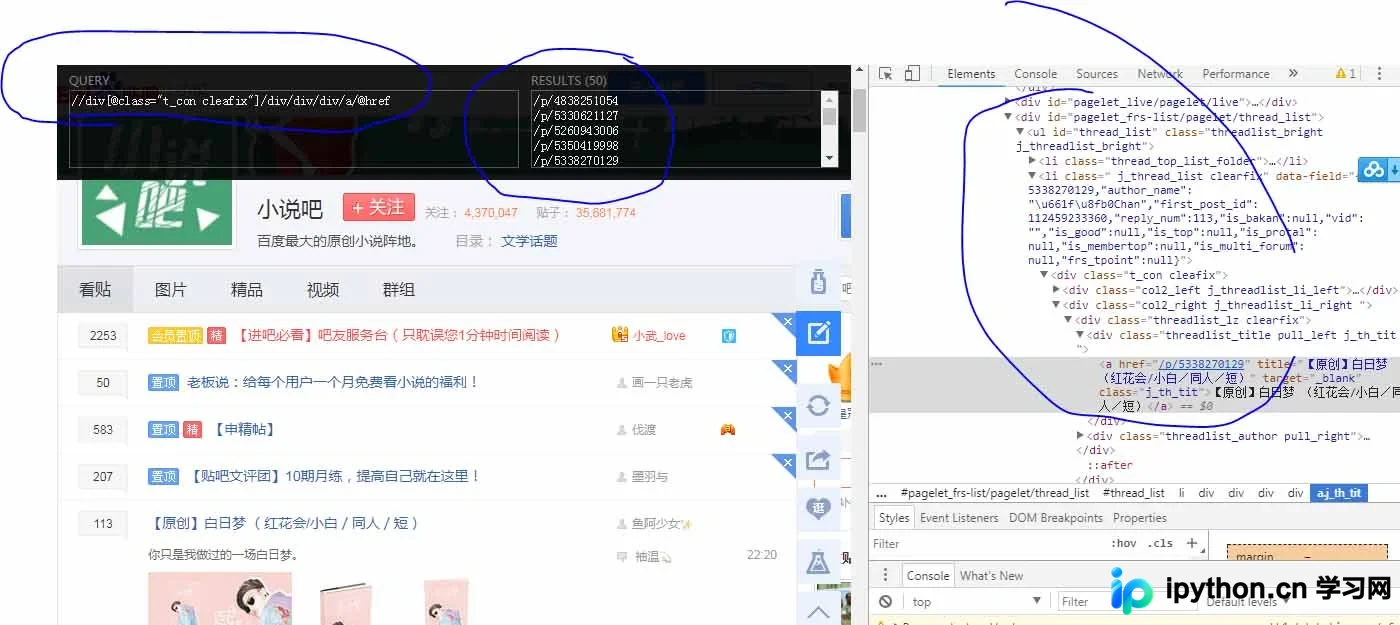
在插件界面中,黑色方框左侧输入XPath表达式,右侧将返回匹配结果。观察可知,当前页面的所有帖子链接均已被成功抓取。XPath的具体编写需结合右侧“检查元素”功能深入分析,寻找DOM结构的规律。不同网站的HTML结构各异,但通过细致排查总能找到通用的匹配规则。
在确认规律并实现匹配后,即可开始编写核心代码。
代码部分对每一行尽量添加了详细注释,以便读者理解逻辑。
# -*- coding:utf-8 -*-

import urllib
import urllib2
from lxml import etree


def loadPage(url):
 """
  作用:根据url发送请求,获取服务器响应文件
  url: 需要爬取的url地址
 """
 #print url
 #美女
 # headers = {"User-Agent" : "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_7_0) AppleWebKit/535.11 (KHTML, like Gecko) Chrome/17.0.963.56 Safari/535.11"}

 request = urllib2.Request(url)
 html = urllib2.urlopen(request).read()
 # 解析HTML文档为HTML DOM模型
 content = etree.HTML(html)
 #print content
 # 返回所有匹配成功的列表集合
 link_list = content.xpath('//div[@class="t_con cleafix"]/div/div/div/a/@href')

 #link_list = content.xpath('//a[@class="j_th_tit"]/@href')
 for link in link_list:
  fulllink = "http://tieba.baidu.com" + link
  # 组合为每个帖子的链接
  #print link
  loadImage(fulllink)


# 取出每个帖子里的每个图片连接
def loadImage(link):
 headers = {"User-Agent" : "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/54.0.2840.99 Safari/537.36"}
 request = urllib2.Request(link, headers = headers)
 html = urllib2.urlopen(request).read()
 # 解析
 content = etree.HTML(html)
 # 取出帖子里每层层主发送的图片连接集合
 #link_list = content.xpath('//img[@class="BDE_Image"]/@src')
 #link_list = content.xpath('//div[@class="post_bubble_middle"]')
 link_list = content.xpath('//img[@class="BDE_Image"]/@src')
 # 取出每个图片的连接
 for link in link_list:
  print link
  writeImage(link)


def writeImage(link):
 """
  作用:将html内容写入到本地
  link:图片连接
 """
 #print "正在保存 " + filename
 headers = {"User-Agent" : "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/54.0.2840.99 Safari/537.36"}
 # 文件写入
 request = urllib2.Request(link, headers = headers)
 # 图片原始数据
 image = urllib2.urlopen(request).read()
 # 取出连接后10位做为文件名
 filename = link[-10:]
 # 写入到本地磁盘文件内
 with open("d:\image\\"+filename, "wb") as f:
  f.write(image)
 print "已经成功下载 "+ filename

def tiebaSpider(url, beginPage, endPage):
 """
  作用:贴吧爬虫调度器,负责组合处理每个页面的url
  url : 贴吧url的前部分
  beginPage : 起始页
  endPage : 结束页
 """
 for page in range(beginPage, endPage + 1):
  pn = (page - 1) * 50
  filename = "第" + str(page) + "页.html"
  fullurl = url + "&pn=" + str(pn)
  print fullurl
  loadPage(fullurl)
  #print html

  print "谢谢使用"

if __name__ == "__main__":
 kw = raw_input("请输入需要爬取的贴吧名:")
 beginPage = int(raw_input("请输入起始页:"))
 endPage = int(raw_input("请输入结束页:"))

 url = "http://tieba.baidu.com/f?"
 key = urllib.urlencode({"kw": kw})
 fullurl = url + key
 tiebaSpider(fullurl, beginPage, endPage)
代码运行效果如下所示。
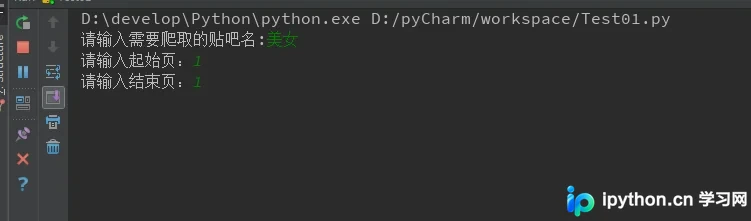
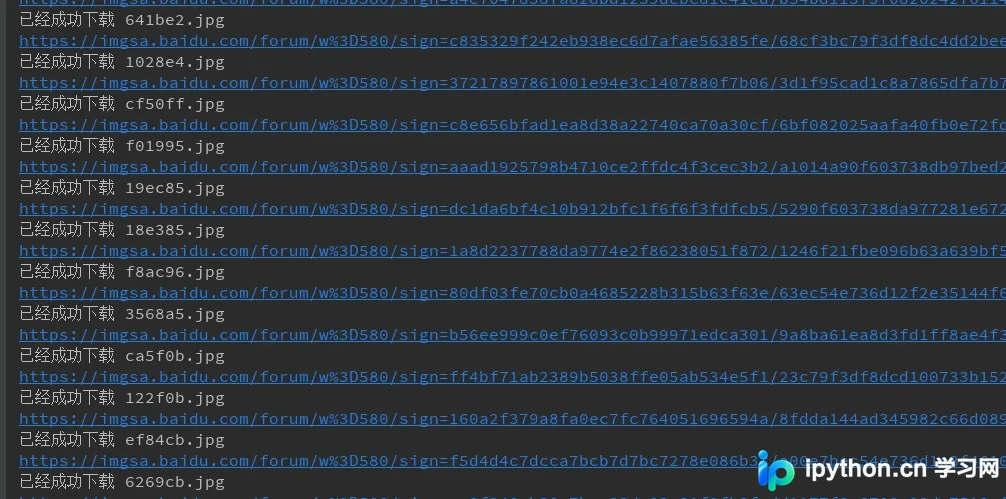
从输出结果可见,程序已成功运行。当然,实际开发过程并非一帆风顺,此处提供的代码仅供学习参考。
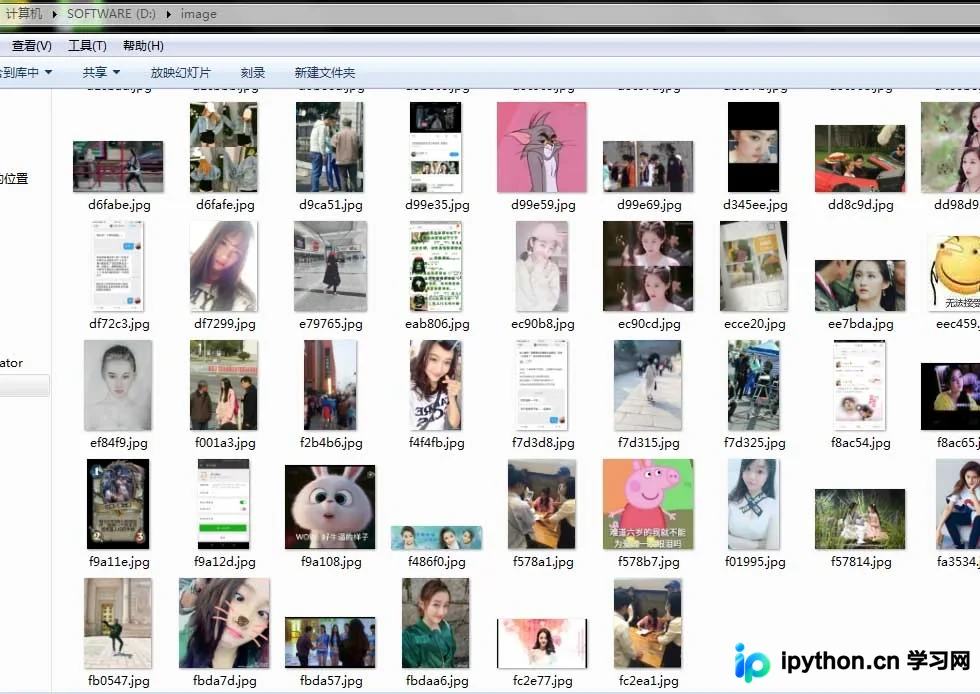
以上即为Python实现贴吧图片爬虫的完整示例,分享给各位读者参考,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









