

用 Scrapy 抓取慕课网全部免费课程:从分页采集到 MySQL 入库
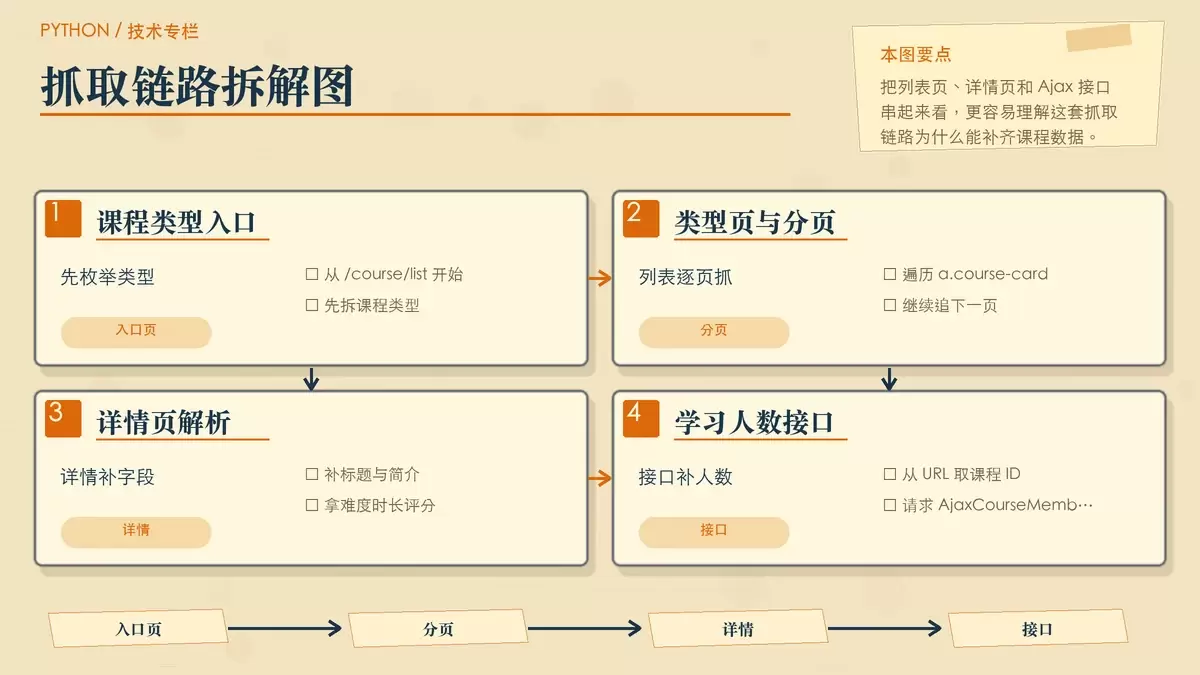
这篇文章把一个抓取慕课网免费课程的 Scrapy 示例,整理成可直接复用的完整流程:从按课程类型翻页抓取,到进入详情页补齐难度、时长、评分,再通过接口拿到学习人数,最后异步写入 MySQL。代码事实、命令和表结构均保留,方便对照落地。
2026-08-25
196

这篇文章把一个抓取慕课网免费课程的 Scrapy 示例,整理成可直接复用的完整流程:从按课程类型翻页抓取,到进入详情页补齐难度、时长、评分,再通过接口拿到学习人数,最后异步写入 MySQL。代码事实、命令和表结构均保留,方便对照落地。
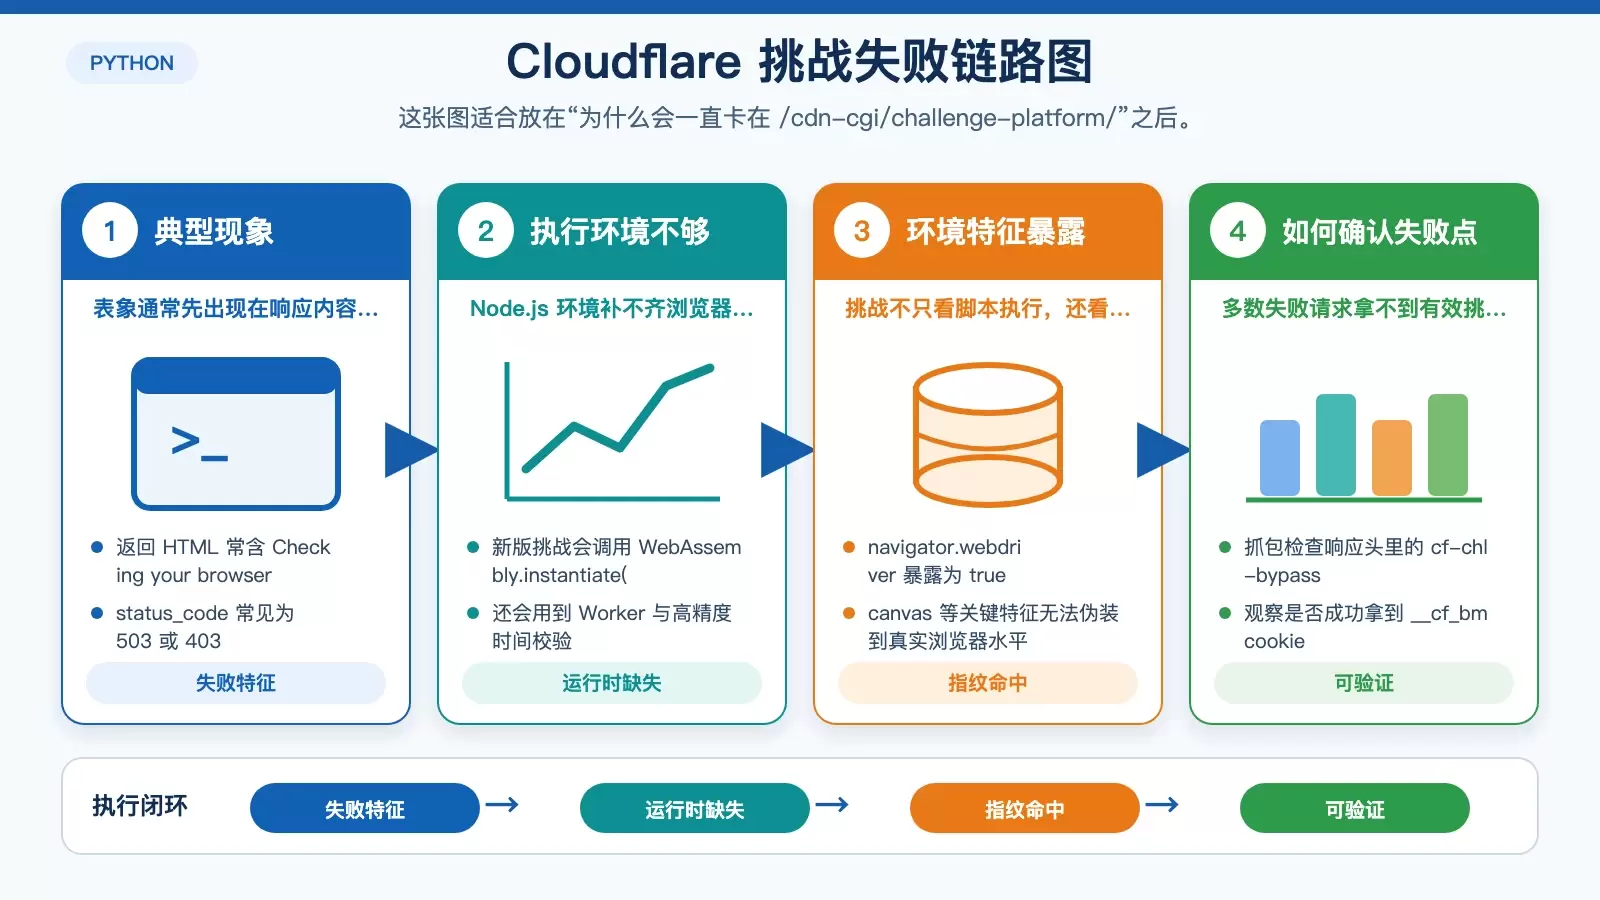
在当前主流 Cloudflare 防护下,`cloudscraper` 往往会卡在 `/cdn-cgi/challenge-platform/`,最终返回 `403/503`。问题不在于“请求没发出去”,而是新版 JS 挑战依赖 `WebAssembly`、时间校验和浏览器指纹,Node.js 模拟环境很难通过。能稳定跑通的方向,已经转向复用真实 Chromium 实例并尽量贴近人工访问行为。
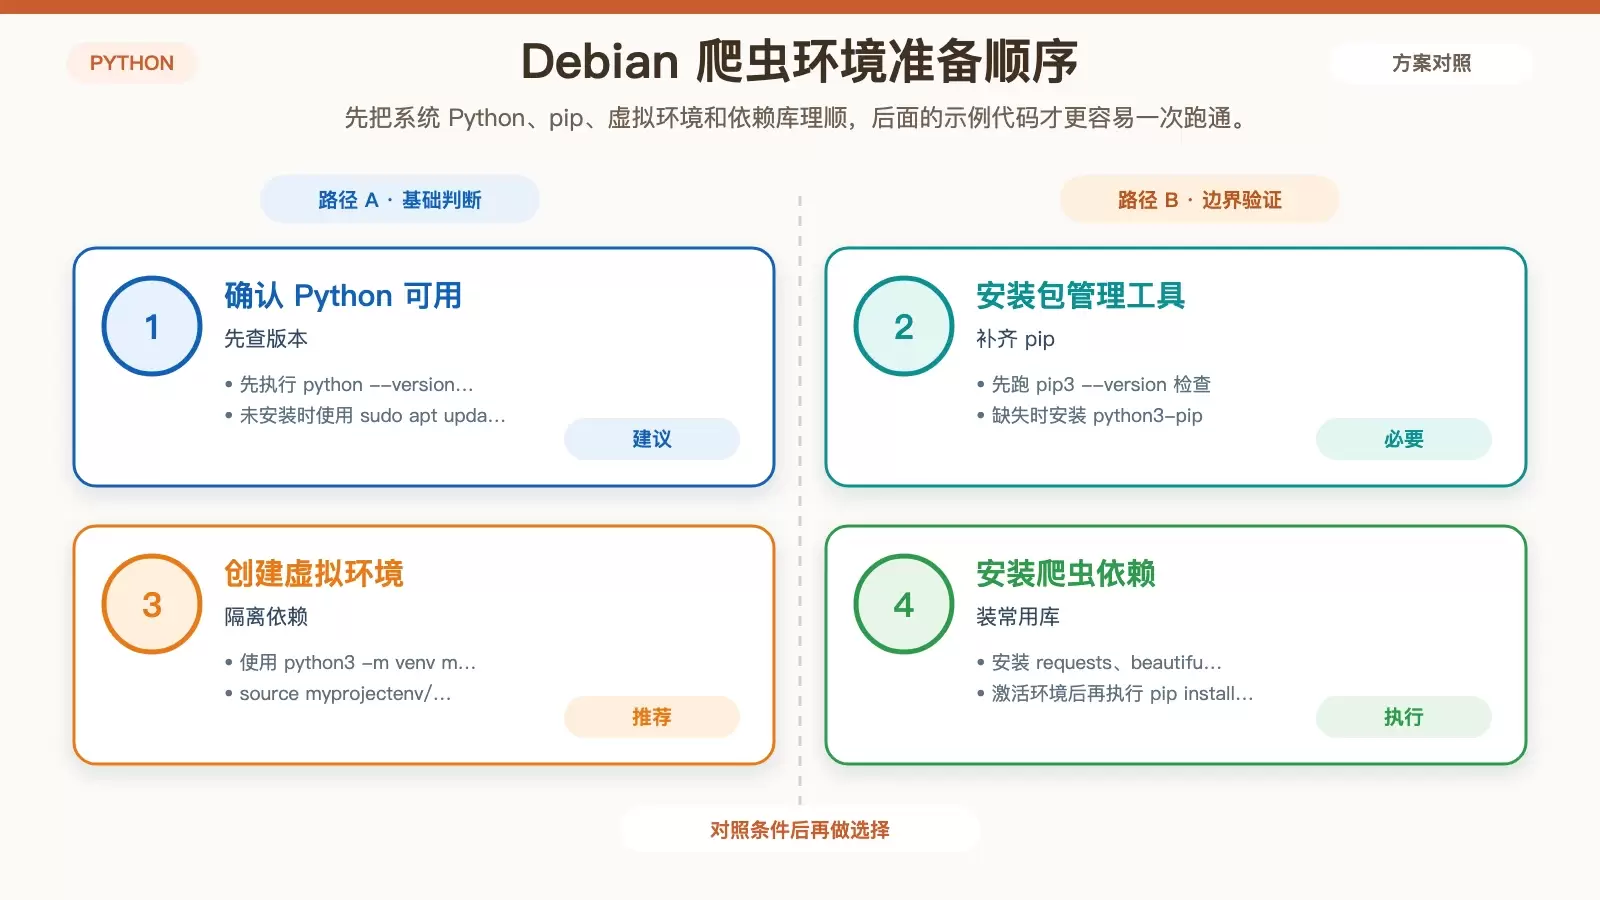
这篇文章把 Debian 上搭建 Python 爬虫的基础流程拆成可直接照做的几个环节:检查 Python、补齐 pip、创建虚拟环境、安装常用库、编写并运行示例程序,同时补上爬取礼仪和数据存储建议,适合刚开始在 Linux 环境里动手的人。
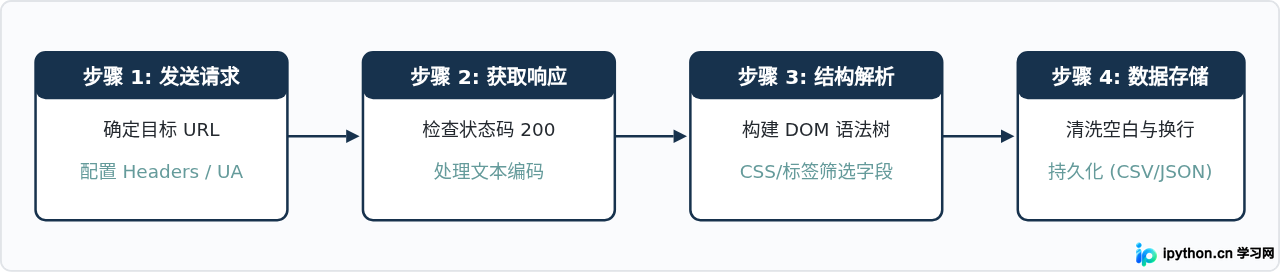
一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
本文分析Python爬虫中使用多进程生产者-消费者模式时,因未正确调用join()导致消费者进程过早终止的问题。通过对比错误与正确的代码结构,指出必须等待生产者完成并调用消费者join(),同时需向队列发送结束标志,确保所有任务被处理完毕。
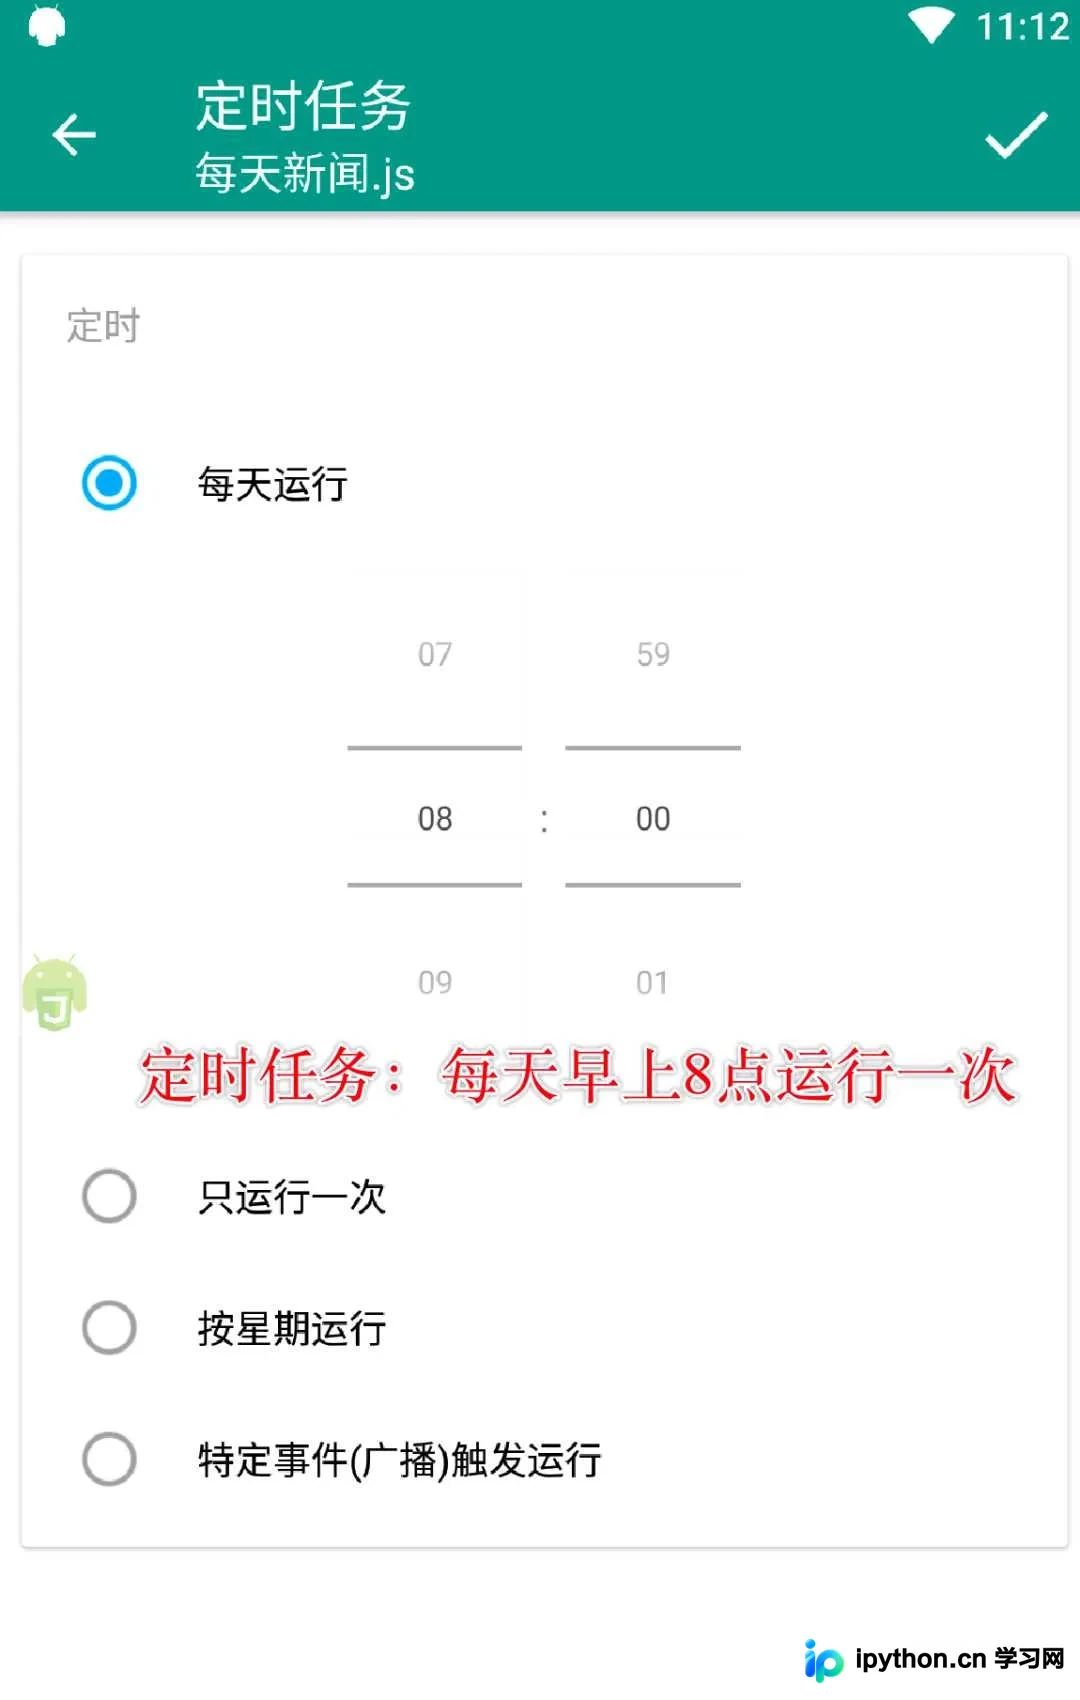
本文介绍一种无需编写原生App或利用无障碍服务即可实现微信群自动发送新闻早报的方案。通过Python结合Requests和FastAPI构建新闻获取接口,再使用AutoJS脚本在Android端调用该接口并自动操作微信发送消息。文章详细展示了从数据爬取、服务部署到脚本编写及定时任务设置的全过程,适用于希望实现自动化办公或信息推送的技术人员。
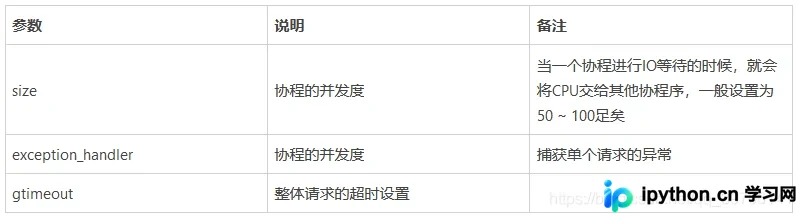
本文介绍Python中grequests模块的使用方法与适用场景。grequests基于requests和gevent实现异步并发请求,支持GET、POST等多种HTTP方法,常用于爬虫IP代理池验证及压力测试。文章提供基础用法、自定义返回结果修改源码示例以及事件钩子配置代码,帮助开发者高效处理批量网络请求。
本文详解Python中urllib模块的核心用法,涵盖urlopen发起请求、Request设置User-Agent伪装、urlencode处理查询参数及quote编码等关键步骤。通过百度贴吧多页数据抓取的完整案例,演示如何构建爬虫类、拼接URL并保存HTML文件,帮助开发者掌握基础网络数据采集技能。
教你使用 Python 的 requests 与 BeautifulSoup 编写第一个网页爬虫,步骤详尽,示例完整。
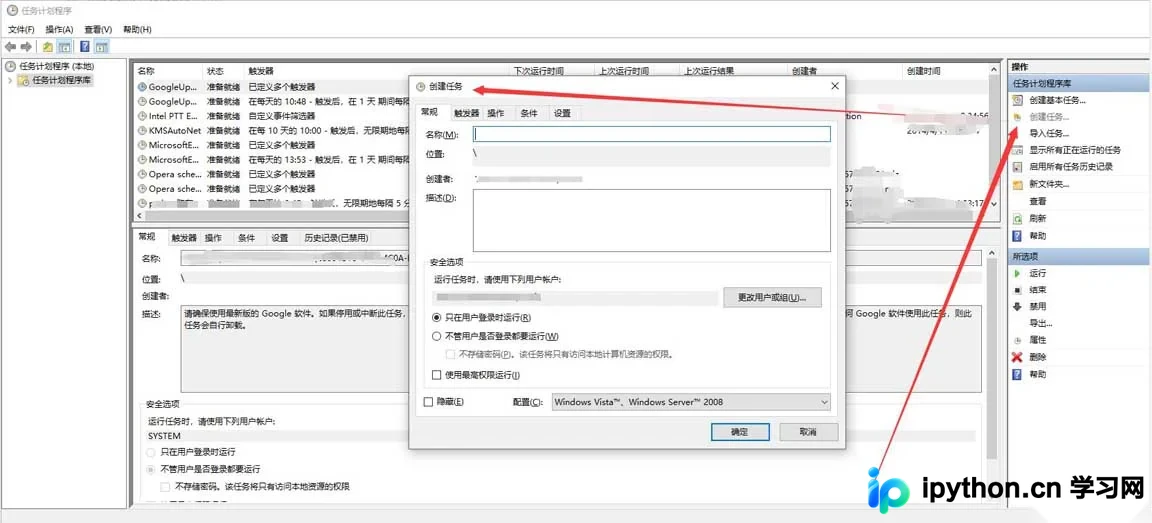
本文详细介绍在Windows系统中利用Python脚本结合Selenium库实现自动化数据采集与更新的方法。内容涵盖通过psutil监控Chrome进程状态、处理长时间未生成数据的异常退出机制,以及利用Windows计划任务实现脚本的周期性自动执行。此外,还包含基于日志的企业微信错误报警集成方案,确保自动化流程的稳定运行。
本文详解如何在Python爬虫中通过百度智能云文字识别API解决图片验证码问题。内容涵盖从创建应用获取凭证、安装baidu-aip库,到使用Pillow库进行图像二值化预处理以提高识别率,最后调用handwriting接口完成自动登录的全过程。
本文详细介绍如何利用Python爬虫技术获取天气通讯社的高温预警数据。通过分析目标网站反爬机制,结合亿牛云代理IP配置示例,帮助开发者有效规避访问限制,提前获取高温、暴雨等气象预警信息,做好防暑防灾准备。