

Python 3实战:使用正则表达式与urllib爬取京东图书图片

本文详细介绍如何利用Python 3编写图片爬虫,从京东网站批量下载编程类图书封面。通过解析URL分页规律,结合正则表达式对HTML源码进行两次过滤,精准提取商品图片链接,并使用urllib库实现本地存储。文中包含完整代码示例及异常处理逻辑,适用于学习网络爬虫基础与数据抓取技术。
前言
近期工作中遇到一个实际需求,需要批量获取京东平台上图书商品的封面图片。若手动复制保存所有分类下的图片,工作量巨大且效率低下。为此,我们可以利用Python编写网络爬虫程序,这类专门用于抓取图片的脚本被称为图片爬虫。本文将逐步演示如何实现这一功能。
实现分析
首先确定目标网页,即爬虫的起始页面。访问京东网站并进入图书分类板块。鉴于图书种类繁杂,本文选取“编程语言”类别作为爬取对象,起始网址为:https://list.jd.com/list.html?cat=1713,3287,3797&page=1&sort=sort_rank_asc&trans=1&JL=6_0_0#J_main
如图:
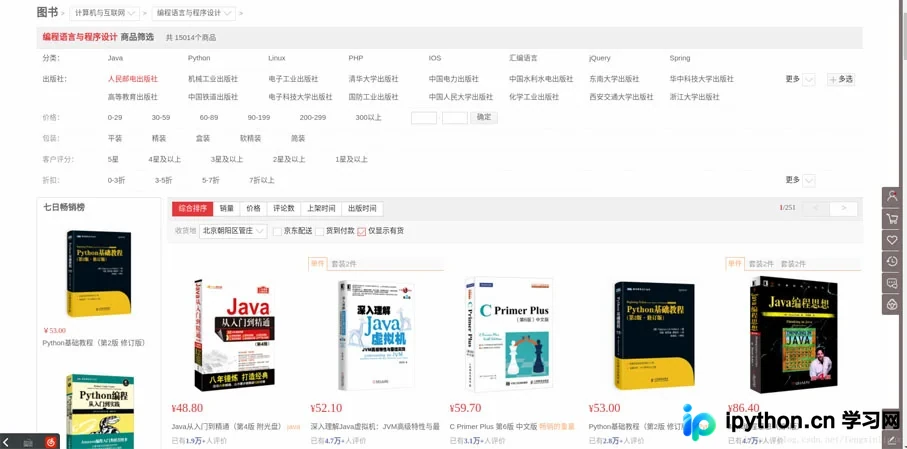
进入页面后可以看到,该分类下总共有251页内容。
那么,如何自动爬取除第一页之外的其他页面呢?
可以通过点击“下一页”按钮来观察网址的变化规律。点击后,网址变为:https://list.jd.com/list.html?cat=1713,3287,3797&page=2&sort=sort_rank_asc&trans=1&JL=6_0_0#J_main。
观察可知,页面索引通过URL参数识别,采用GET请求方式。该请求包含多个字段,其中“page”字段对应页码值(如2)。因此,URL的关键结构可简化为:https://list.jd.com/list.html?cat=1713,3287,3797&page=2。经测试,将page参数改为6,也能成功访问第6页。
基于此规律,我们可以设计自动获取多页的方法:利用for循环遍历页码,每次循环将URL中的page参数值加1,从而自动切换至下一页。
在每一页中,我们需要提取对应的图片链接。可以使用正则表达式匹配源码中的图片链接部分,随后利用urllib.request.urlretrieve()函数将指定链接的图片保存到本地硬盘。
然而,这里存在一个难点:网页源码中不仅包含商品列表图片,还混入了其他无关图片。因此,需先进行初步信息过滤,保留中间商品列表部分的数据,剔除其他干扰内容。右键查看网页源代码,如图:
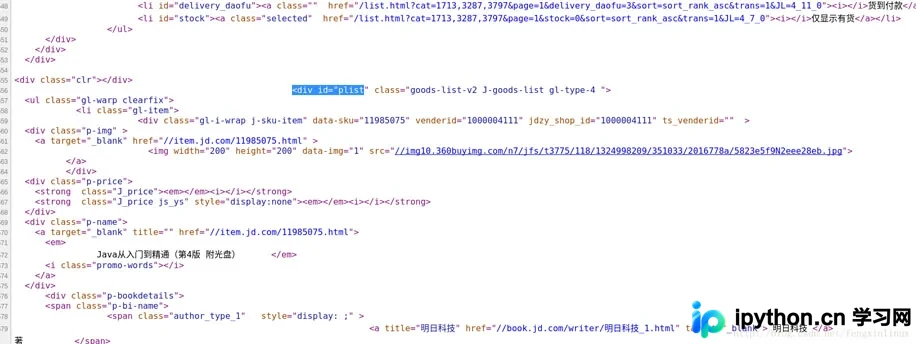
可以通过商品列表中第一个商品名“JAVA从入门到精通”快速定位到源码中的对应位置,然后观察其商品列表部分的特殊标识,可以看到,其上方有处“<div id="plist”代码,然后我们在源码中搜索该代码,发现只有一个地方有,随后打开其他页的对应页面,发现仍然具有这个规律,说明该特殊标识可以作为有效信息的起始过滤位置。当然,你可以使用其他的代码作为特殊标识,但是该特殊标识要满足唯一性,并且要包含要爬取的信息。
那么,有效信息到什么代码位置结束呢?
同样,我们通过在源码中查找该页商品列表中最后一个图书,快速定位到源码位置,进行分析,我们可以找到一个这样的代码作为标识,如图:
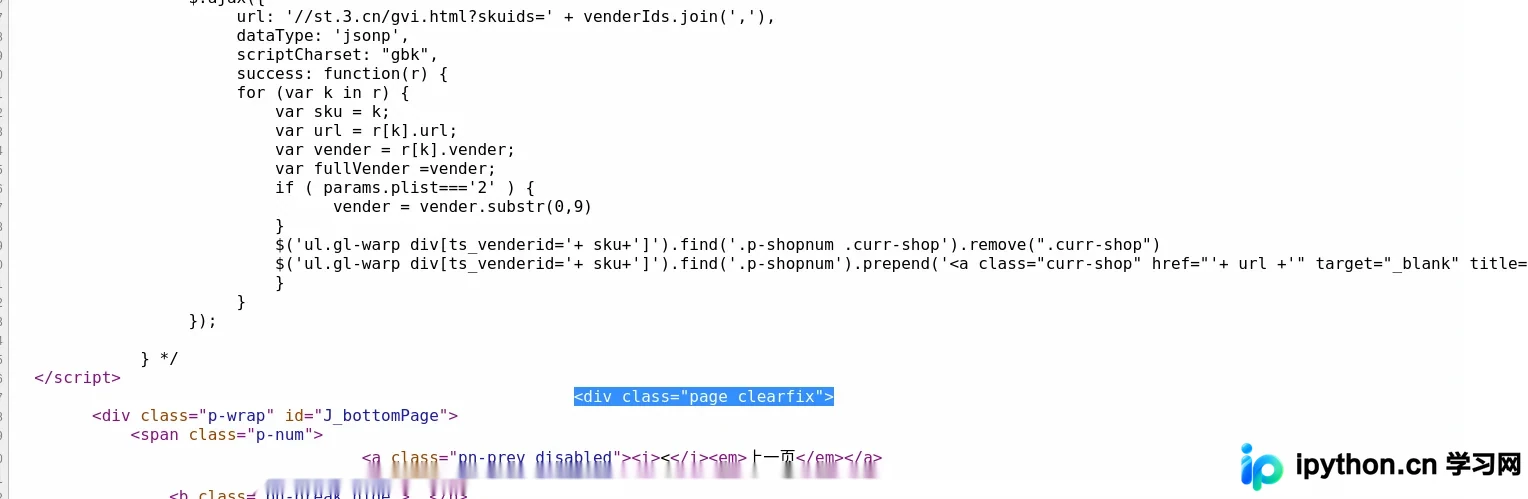
所以,如果要进行第一次过滤,我们的正则表达式可以构造为:
<div id="plist".+? <div class="page clearfix">
进行了第一次信息过滤后,留下来的图片链接就是我们想爬取的图片了,下一步需要在第一次过滤的基础上,再将图片链接信息过滤出来。
此时,需要观察网页中对应图片的源代码,我们观察到其中两张图片的对应源码:
图片1:
<img width="200" height="200" data-img="1" src="https://img13.360buyimg.com/n7/jfs/t6130/167/771989293/235186/608d0264/592bf167Naf49f7f6.jpg">
图片2:
<img width="200" height="200" data-img="1" src="https://img10.360buyimg.com/n7/g14/M03/0E/0D/rBEhV1Im1n8IAAAAAAcHltD_3_8AAC0FgC-1WoABweu831.jpg">
对比两张图片代码,发现其基本格式是一样的,只是图片的链接网址不一样,所以此时,我们根据该规律构造出提取图片链接的正则表达式:
<img width="200" height="200" data-img="1" src="https://(.+?\.jpg)">
刚开始到这里,我以为就结束了,后来在爬取的过程中我发现每一页都少爬取了很多图片,再次查看源码发现,每页后面的几十张图片又是另一种格式:
<img width="200" height="200" data-img="1" data-lazy-img="//img10.360buyimg.com/n7/jfs/t3226/230/618950227/110172/7749a8bc/57bb23ebNfe011bfe.jpg">
所以,完整的正则表达式应该是这两种格式的或:
<img width="200" height="200" data-img="1" src="https://(.+?\.jpg)">|<img width="200" height="200" data-img="1" data-lazy-img="//(.+?\.jpg)">
到这里,我们根据该正则表达式,就可以提取出一个页面中所有想要爬取的图片链接。
所以,根据上面的分析,我们可以得到该爬虫的编写思路与过程,具体如下:
- 建立一个爬取图片的自定义函数,该函数负责爬取一个页面下的我们想爬取的图片,爬取过程为:首先通过
urllib.request.utlopen(url).read()读取对应网页的全部源代码,然后根据上面的第一个正则表达式进行第一次信息过滤,过滤完成之后,在第一次过滤结果的基础上,根据上面的第二个正则表达式进行第二次信息过滤,提取出该网页上所有的目标图片的链接,并将这些链接地址存储的一个列表中,随后遍历该列表,分别将对应链接通过urllib.request.urlretrieve(imageurl,filename=imagename)存储到本地,为了避免程序中途异常崩溃,我们可以建立异常处理。 - 通过for循环将该分类下的所有网页都爬取一遍,链接可以构造为url='https://list.jd.com/list.html?cat=1713,3287,3797&page=' + str(i)
完整的代码如下:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-

import re
import urllib.request
import urllib.error
import urllib.parse


sum = 0
def craw(url,page):
 html1=urllib.request.urlopen(url).read()
 html1=str(html1)
 pat1=r'<div id="plist".+? <div class="page clearfix">'
 result1=re.compile(pat1).findall(html1)
 result1=result1[0]
 pat2=r'<img width="200" height="200" data-img="1" src="https://(.+?\.jpg)">|<img width="200" height="200" data-img="1" data-lazy-img="//(.+?\.jpg)">'
 imagelist=re.compile(pat2).findall(result1)
 x=1
 global sum
 for imageurl in imagelist:
  imagename='./books/'+str(page)+':'+str(x)+'.jpg'
  if imageurl[0]!='':
   imageurl='http://'+imageurl[0]
  else:
   imageurl='http://'+imageurl[1]
  print('开始爬取第%d页第%d张图片'%(page,x))

  try:
   urllib.request.urlretrieve(imageurl,filename=imagename)
  except urllib.error.URLError as e:
   if hasattr(e,'code') or hasattr(e,'reason'):
    x+=1

  print('成功保存第%d页第%d张图片'%(page,x))
  x+=1
  sum+=1

for i in range(1,251):
 url='https://list.jd.com/list.html?cat=1713,3287,3797&page='+str(i)
 craw(url,i)
print('爬取图片结束,成功保存%d张图'%sum)
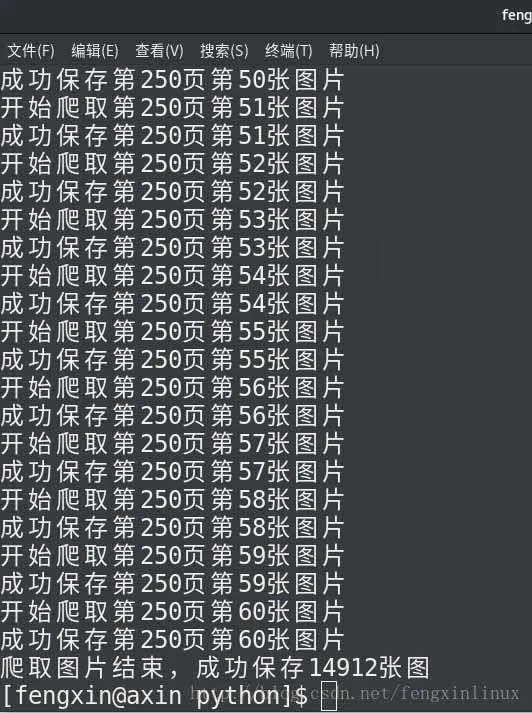
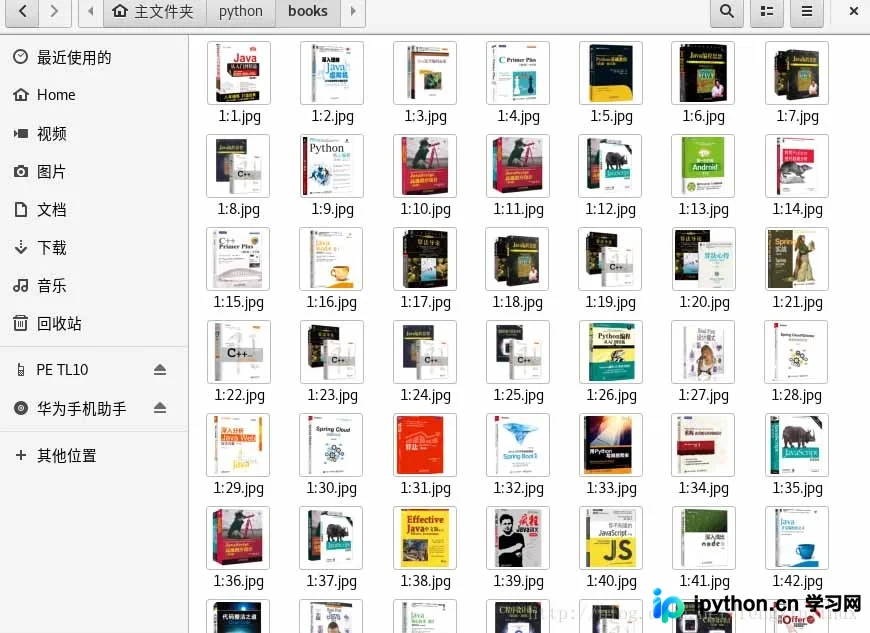
运行结果如下:
总结
以上就是这篇文章的全部内容了,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









