

Python实现轻量级分布式爬虫代理IP池教程

本文详细介绍如何使用Python搭建一个轻量级的分布式爬虫代理IP池。通过整合多个免费代理源,利用SSDB进行高性能存储,并结合Flask提供RESTful API接口。文章涵盖代理获取、质量检测、定时刷新及爬虫调用等核心模块,帮助开发者快速实现稳定高效的代理IP管理服务。
在企业级分布式深网爬虫项目中,构建一套稳定可靠的代理池服务至关重要。该服务需为成百上千的爬虫实例提供有效的代理IP,确保每个爬虫都能获取到对应网站可用的IP地址,从而保障爬虫系统的高速与稳定运行。虽然公司内部项目通常不对外开源,但在业余时间,利用现有免费资源构建一个简易的代理池服务也是可行的实践。
1、核心问题分析
代理IP的来源问题: 在初学爬虫阶段,若缺乏付费代理资源,通常会转向西刺、快代理等提供免费代理的网站进行抓取。尽管这类免费代理中仅有少数可用,但若拥有更优质的代理接口,也可自行接入。采集免费代理的流程相对简单,主要包含:访问目标页面 -> 使用正则表达式或XPath提取数据 -> 保存至存储介质。
如何确保代理质量: 必须承认,绝大多数免费代理IP是不可用的,否则付费代理市场便不会存在(事实上,许多付费代理的稳定性也堪忧)。因此,采集到的代理IP不能直接投入使用,必须编写检测程序,利用多线程或异步技术不断尝试通过代理访问稳定网站,以验证其可用性。由于检测过程耗时较长,采用并发处理是必要的。
采集数据的存储方案: 此处推荐一款高性能且支持多种数据结构的NoSQL数据库SSDB,作为代理数据的存储后端(替代Redis)。SSDB支持队列、Hash、Set及K-V对等多种数据结构,并能处理T级别的数据量,是构建分布式爬虫中间存储层的理想工具。
如何简化爬虫对代理的使用: 最佳方案是将代理池封装为服务。Python拥有众多Web框架,任选其一编写API供爬虫调用即可。这样做优势明显:例如,当爬虫发现代理失效时,可通过API主动删除该IP;当代理池资源不足时,可主动触发刷新操作。这种机制比单纯依赖后台检测程序更为可靠和灵活。
2、代理池架构设计
代理池系统主要由以下四个核心部分组成:
ProxyGetter(代理获取模块): 提供代理获取接口,当前集成5个免费代理源。每次调用该接口,系统会抓取这5个网站的最新代理数据并存入数据库(DB)。用户可根据需求自行扩展额外的代理获取接口。
DB(数据库模块): 用于存储代理IP,目前仅支持SSDB。选择SSDB的原因可参考相关技术文章,它被视为Redis的不错替代方案。若未接触过SSDB,其安装过程相对简单,可参考官方文档或相关教程。
Schedule(计划任务模块): 负责定时检测数据库中代理IP的可用性,并删除失效代理。同时,该模块会主动通过ProxyGetter获取最新代理并更新至数据库,确保池内数据的时效性。
ProxyApi(外部接口模块): 提供代理池的外部访问接口。鉴于当前功能相对简单,选用Flask框架开发,耗时约两小时。该模块提供get、delete、refresh等接口,旨在方便爬虫直接调用。
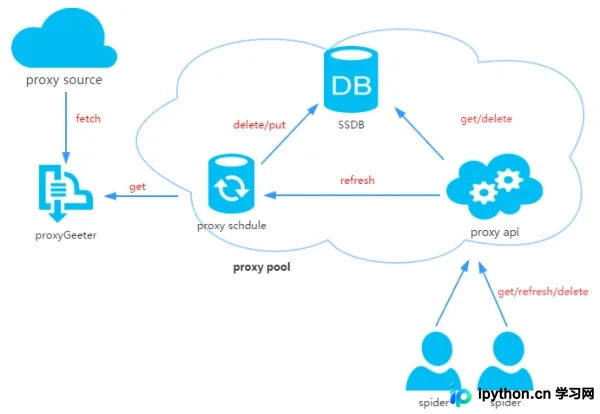
[图片占位符:代理池架构设计图]
3、代码模块详解
Python凭借其高层次的数据结构、动态类型和动态绑定特性,非常适合快速应用开发及作为胶水语言连接现有软件部件。使用Python构建此代理IP池较为简便,代码主要划分为6个模块:
Api模块:负责API接口相关代码,目前由Flask实现,逻辑简洁。客户端请求发送至Flask后,Flask调用ProxyManager中的具体实现,包括get/delete/refresh/get_all等接口功能。
DB模块:处理数据库相关代码,当前采用SSDB。代码采用工厂模式编写,便于日后扩展支持其他类型的数据库。
Manager模块:包含get/delete/refresh/get_all等接口的具体实现类。目前代理池仅负责管理proxy,未来可能扩展更多功能,如代理与爬虫的绑定、代理与账号的绑定等。
ProxyGetter模块:涉及代理获取的相关代码。目前抓取了快代理、代理66、有代理、西刺代理、guobanjia这五个网站的免费代理。经测试,这5个网站每日更新的可用代理仅约六七十条,当然也支持用户自行扩展代理接口。
Schedule模块:处理定时任务相关代码,目前仅实现定时刷新代码并验证可用代理,采用多进程方式运行。
Util模块:存放公共模块方法或函数,包含GetConfig(读取配置文件config.ini的类)、ConfigParse(集成重写ConfigParser的类,使其对大小写敏感)、Singleton(实现单例模式)、LazyProperty(实现类属性惰性计算)等工具类。
其他文件:配置文件Config.ini,用于配置数据库连接和代理获取接口。用户可在GetFreeProxy中添加新的代理获取方法,并在Config.ini中注册即可生效。
4、安装步骤
下载代码仓库:
git clone git@github.com:jhao104/proxy_pool.git

或者直接到https://github.com/jhao104/proxy_pool 下载zip文件
安装依赖库:
pip install -r requirements.txt
启动服务:
需要分别启动定时任务和api
到Config.ini中配置你的SSDB

到Schedule目录下:
>>>python ProxyRefreshSchedule.py

到Api目录下:
>>>python ProxyApi.py
5、使用方法
定时任务启动后,会通过代理获取方法fetch所有代理放入数据库并进行验证。此后,系统默认每20分钟重复执行一次该流程。定时任务启动约一两分钟后,即可在SSDB中看到刷新出来的可用代理数据。
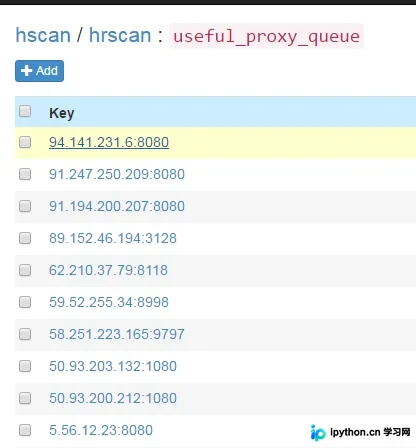
启动ProxyApi.py后,即可在浏览器中通过接口获取代理。以下是浏览器中的界面截图: index页面展示:
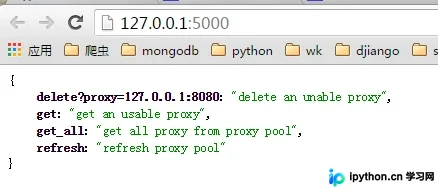
get页面功能展示:
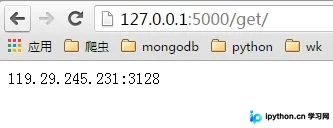
get_all页面功能展示:
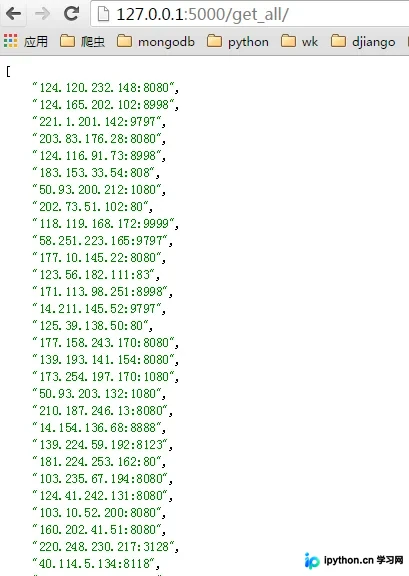
在爬虫中使用:若需在爬虫代码中调用,可将此API封装为函数直接使用,示例如下:
import requests

def get_proxy():
  return requests.get("http://127.0.0.1:5000/get/").content

def delete_proxy(proxy):
  requests.get("http://127.0.0.1:5000/delete/?proxy={}".format(proxy))

# your spider code

def spider():
  # ....
  requests.get('https://www.example.com', proxies={"http": "http://{}".format(get_proxy)})
  # ....
6、总结与展望
由于时间仓促,当前功能和代码较为简陋,后续若有时间将进行改进和完善。欢迎在GitHub上给项目点个Star。感谢支持!
项目地址:https://github.com/jhao104/proxy_pool
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









