Python去除HTML标签的几种方法总结
本文总结了在Python中清洗小说数据时去除HTML标签的三种常用方法。通过对比正则表达式、BeautifulSoup解析器以及lxml库的实际代码示例,展示了如何从混杂HTML的字符串中提取纯文本。此外,还介绍了利用正则表达式移除HTML标签属性的技巧,帮助开发者快速实现数据清洗。
2026-10-16
3

本文总结了在Python中清洗小说数据时去除HTML标签的三种常用方法。通过对比正则表达式、BeautifulSoup解析器以及lxml库的实际代码示例,展示了如何从混杂HTML的字符串中提取纯文本。此外,还介绍了利用正则表达式移除HTML标签属性的技巧,帮助开发者快速实现数据清洗。
本文介绍Python中从HTML提取纯文本的三种常用方法:使用正则表达式移除标签、调用NLTK库的clean_html函数以及自定义HTMLParser解析器。文章对比了各方案的代码实现、依赖要求及适用场景,帮助开发者根据项目需求选择最高效的文本提取方案。
本文详细介绍Python中lxml库的安装方法及基础使用。涵盖通过pip安装lxml,利用etree.HTML解析HTML字符串或文件,以及使用XPath语法提取特定标签文本和属性值。内容包含代码示例,帮助开发者快速掌握lxml在爬虫数据采集中的高效应用。
本文详解如何使用Python的smtplib和email模块通过QQ邮箱发送电子邮件。重点讲解开启SMTP服务、获取第三方授权码的安全配置步骤,并分别演示纯文本与HTML格式邮件的代码实现,涵盖端口配置及常见参数说明。
解决浏览器解析 XML 兼容性问题的核心方案是在服务器端将 XML 数据通过 XSLT 转换为纯 HTML。本文以 ASP/VBScript 为例,演示如何加载 XML 文档与样式表,并利用 transformNode 方法输出标准化页面,确保所有浏览器均可正确显示结构化数据。
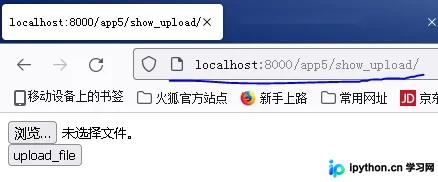
本文介绍如何使用Django框架实现前端页面文件上传功能。详细解析urls.py路由配置、views.py中处理POST请求及文件保存逻辑,以及HTML模板中action与csrf_token的设置。重点排查了因HTML标签拼写错误(from误写)导致的提交失败问题,提供完整的代码示例与调试步骤。
XML擅长数据存储但缺乏显示能力。本文详解利用XSLT(XSL Transformation)技术将原始XML数据转换为HTML页面的完整流程。通过DOM解析构建结果树,并应用格式化规则,实现数据与显示的完美分离,让杂乱的数据瞬间变得美观易读。
本文详细介绍Python中pdfkit库的使用,该库封装了wkhtmltopdf工具实现HTML到PDF的转换。内容涵盖pdfkit与wkhtmltopdf的安装步骤(Windows、Ubuntu、CentOS),代码示例演示如何通过URL或字符串生成PDF文件,并重点解决“No wkhtmltopdf executable found”报错,提供路径配置与环境变量设置方案。
本文介绍如何利用Python将HTML网页文件转换为PDF文档和PNG图片。通过集成wkhtmltopdf工具,分别使用pdfkit和imgkit库处理本地HTML文件、URL链接及字符串内容。文章提供了完整的函数示例,涵盖路径配置、编码设置及批量处理逻辑,帮助开发者快速实现网页内容导出功能。
本文介绍了一个用于修复 HTML 未闭合标签的 PHP 函数。该函数支持嵌套闭合与就近闭合两种模式,可处理常见单标签及 XHTML 规范转换。通过配置参数数组,用户可根据需求自定义行为,快速补全缺失的结束标签,优化 HTML 结构完整性。
本文解决Python中使用xlrd读取HTML格式Excel文件时出现的Unsupported format报错,并针对pd.read_html读取数据不完整的问题,推荐将解析器flavor设置为'bs4'以获取完整数据。
本文详细记录了使用Python的Django框架与HTML实现前后端不分离的数据交互过程。通过创建Django项目,编写后端视图处理逻辑与前端表单页面,实现了从用户输入数据、后端计算到结果返回前端显示的全流程。教程涵盖项目创建、代码编写及启动测试步骤,适合初学者参考。