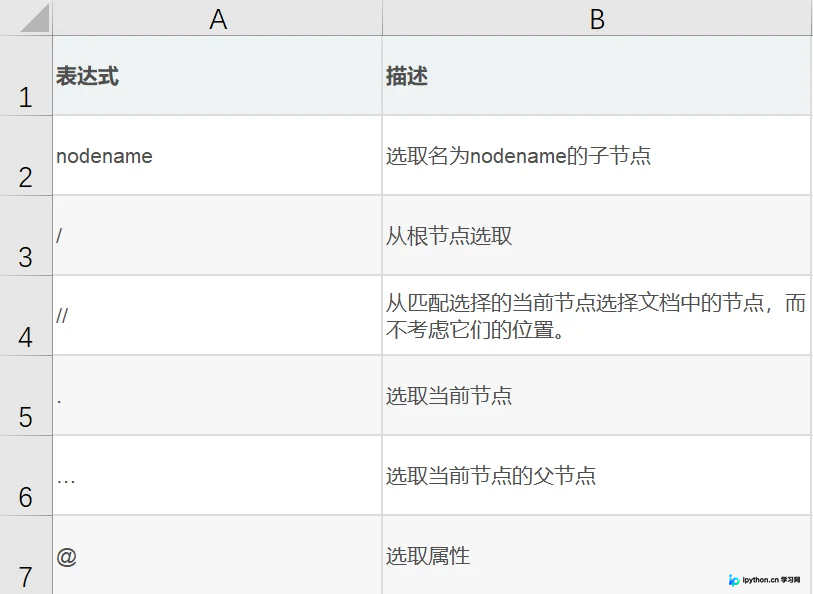
Python lxml库Xpath语法实战指南
本文详解Python中lxml库的Xpath使用技巧,涵盖基础语法、节点定位、文本提取(text与string函数)及多路径选择。通过具体代码示例,帮助开发者掌握高效解析XML/HTML文档的核心方法。
2026-10-16
9

本文详解Python中lxml库的Xpath使用技巧,涵盖基础语法、节点定位、文本提取(text与string函数)及多路径选择。通过具体代码示例,帮助开发者掌握高效解析XML/HTML文档的核心方法。
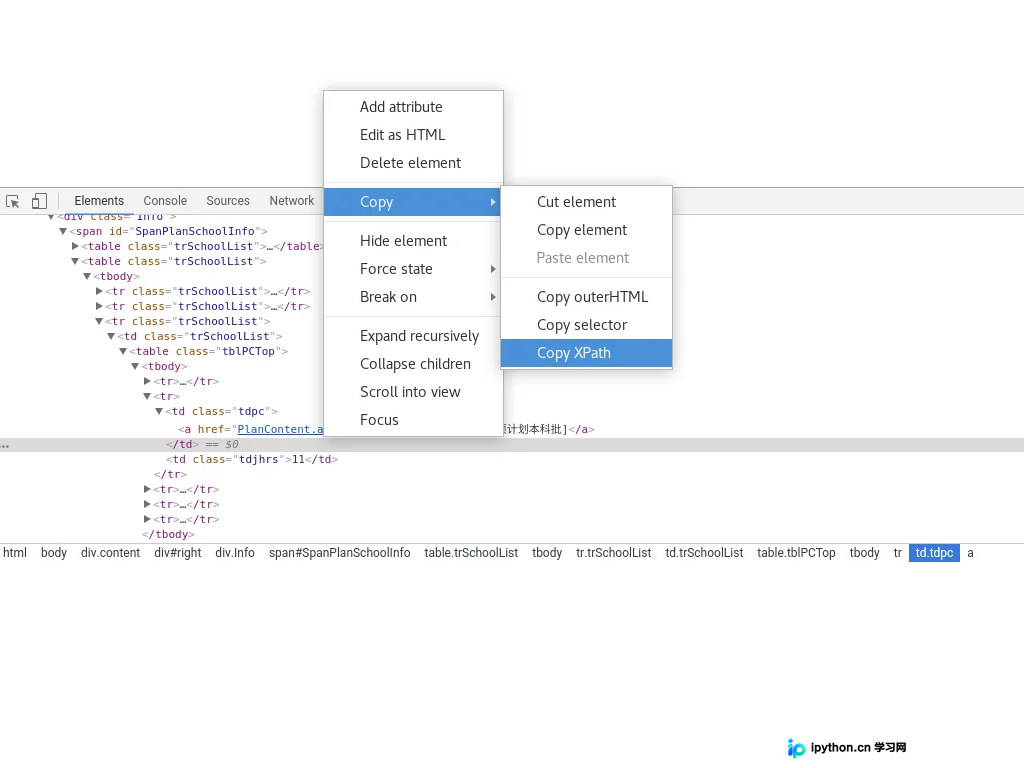
本文分析Scrapy中使用Chrome开发者工具生成的XPath在爬虫中失效的问题。根本原因在于浏览器自动插入tbody标签,而原始HTML结构中可能不存在该标签。通过对比Chrome生成的含tbody XPath与Scrapy实际解析结果,发现需手动移除xpath中的tbody节点。文章提供了使用scrapy shell逐步定位问题的方法,并给出修正后的正确XPath示例,帮助开发者避免此类常见坑点。
本文深入解析Python中字符串截取与切片的核心机制,涵盖正向与反向索引规则、切片语法[start:end:step]的具体用法及实例演示。同时提供两种自定义字符串截取函数的实现方案,分别适用于单次提取和批量提取特定标签间内容的场景,助力开发者高效处理XML、JSON等字符串数据。
本文解析Python爬虫中因服务器使用Brotli压缩导致的中文乱码问题。详细说明了如何识别Accept-Encoding头中的br格式,通过手动导入brotli库或使用httpx自动处理来正确解码数据,并提供了修改请求头以禁用br压缩的替代方案。
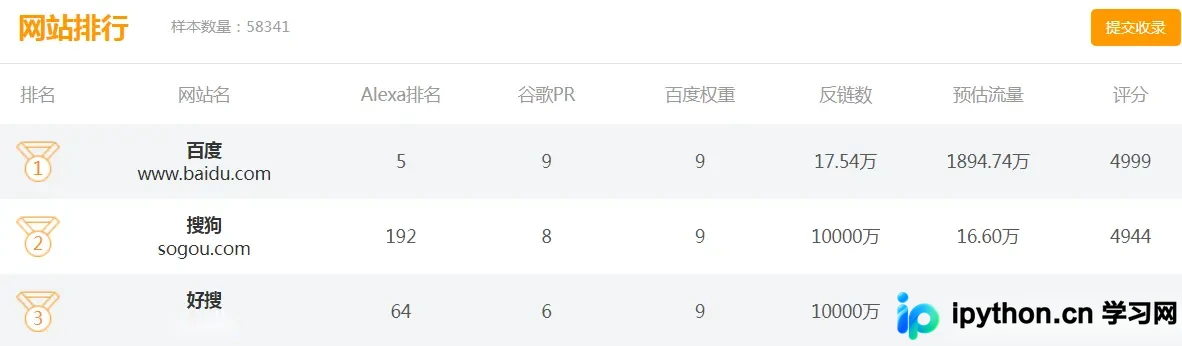
本文详解如何使用Python结合requests、lxml、threading和queue模块,高效爬取中介网网站排行榜。通过多线程生产者-消费者模型,自动解析总页码并批量抓取域名详情页数据,提供完整的逻辑梳理与代码实现参考。
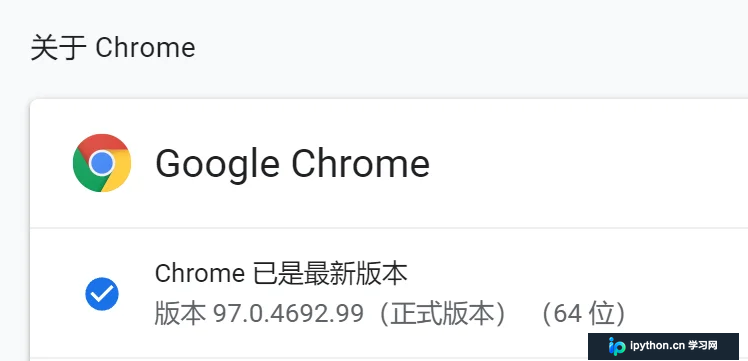
本文详细介绍如何在Python中利用Selenium库搭建代理IP池,以规避网站访问限制。内容涵盖Selenium及浏览器驱动的下载安装、环境变量配置,以及通过Chrome Options添加随机代理IP的核心代码实现。文中提供了完整的代码示例和注意事项,帮助开发者高效管理多个代理IP,降低被封禁风险。
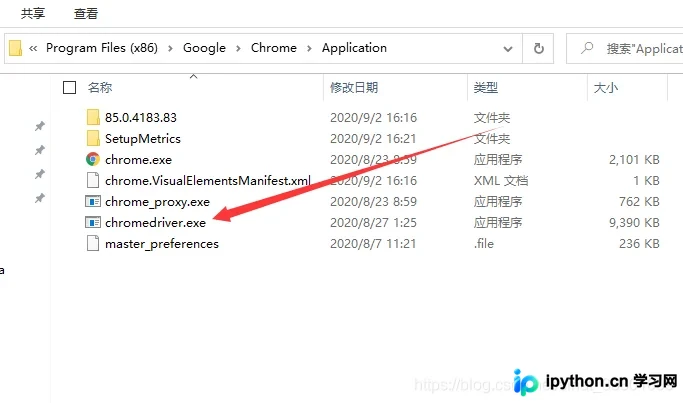
本文介绍如何利用Python Selenium获取并复用Cookie,实现Airbnb网站的免密登录。通过手动登录后保存Cookie文件,后续请求直接加载Cookie,无需重复输入账号密码,有效提升爬虫效率。
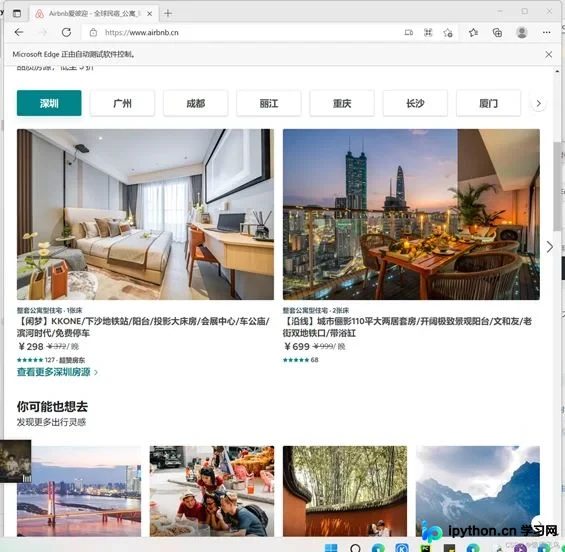
本文详细介绍Python中Selenium库的安装与ChromeDriver配置,演示无头模式、页面截图、元素定位及交互操作。涵盖多窗口切换、Cookie管理、代理设置及滑块验证码处理,并分析其优缺点,帮助开发者高效构建自动化测试与数据采集工具。
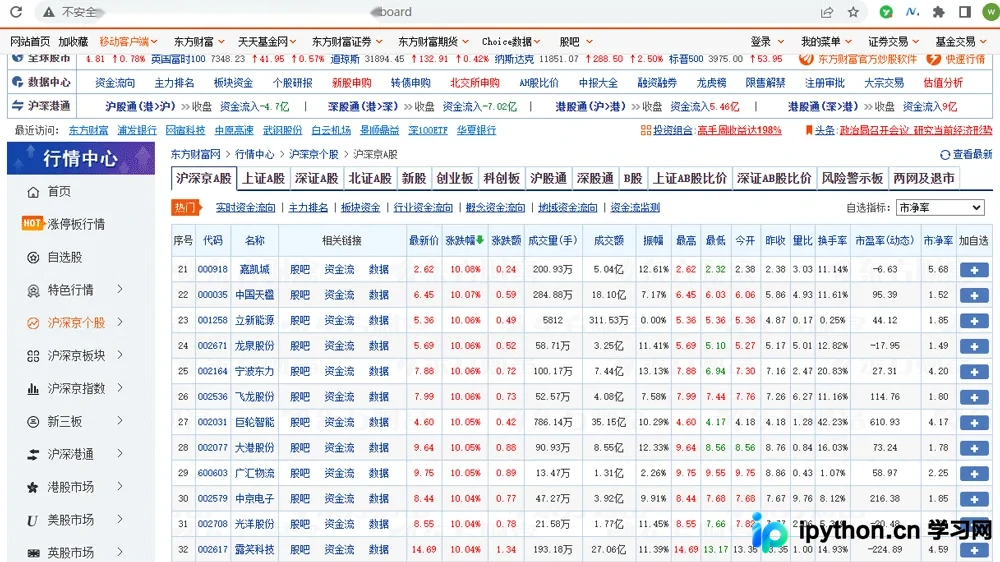
本文详细讲解如何利用Python爬取东方财富网的股票实时数据。通过F12开发者工具分析Ajax动态加载接口,识别关键参数如pn控制页码。针对非标准JSON返回格式进行清洗处理,提取f2至f22等字段含义,并编写Python脚本实现数据解析、存储及多页循环抓取,最终完成股票信息的本地保存。
本文详解如何在Python爬虫中通过百度智能云文字识别API解决图片验证码问题。内容涵盖从创建应用获取凭证、安装baidu-aip库,到使用Pillow库进行图像二值化预处理以提高识别率,最后调用handwriting接口完成自动登录的全过程。
本文详细介绍如何利用Python爬虫技术获取天气通讯社的高温预警数据。通过分析目标网站反爬机制,结合亿牛云代理IP配置示例,帮助开发者有效规避访问限制,提前获取高温、暴雨等气象预警信息,做好防暑防灾准备。
本文介绍如何使用Python编写爬虫程序,通过调用第三方条形码查询网站接口来获取商品信息。文章详细讲解了日志模块的配置、利用ddddocr库识别数字验证码的方法,以及处理HTTP请求和JSON响应的完整代码逻辑。通过具体案例演示了从输入条形码到获取商品名称、厂商及价格的全过程,旨在帮助开发者练习网络爬虫技术并了解商品信息查询的实现原理。