

Python实现QQ音乐URL抓取与批量下载教程

本文详细介绍如何利用Python编写爬虫程序,通过构造特定URL参数获取QQ音乐的播放链接(vkey),并实现批量下载功能。文章涵盖从搜索接口到文件下载的完整流程,提供Python 3.3.3环境下的代码示例与运行效果分析,适合希望自动化获取音乐资源的开发者参考。
前言
QQ音乐平台拥有海量曲库,但在网页端手动下载时常需处理登录验证等繁琐步骤。为此,本文介绍一种基于Python的QQ音乐爬虫方案。对于循环遍历式的爬虫而言,核心难点在于定位并构造待爬取元素所在的正确URL。接下来将逐步解析这一过程(如有理解偏差,欢迎指正)。
具体实现步骤如下
# 定位目标URL
该平台的URL结构相对隐蔽,不易直接获取,前期调试耗时较多。关键在于从大量返回数据中筛选有效信息,并组合生成音乐的真实下载地址。以下是调试过程中整理的几个关键中间URL:
# URL1(搜索接口):https://c.y.qq.com/soso/fcgi-bin/client_search_cp?&lossless=0&flag_qc=0&p=1&n=20&w=雨蝶
# URL2(获取元数据接口):https://c.y.qq.com/base/fcgi-bin/fcg_music_express_mobile3.fcg?&jsonpCallback=MusicJsonCallback&cid=205361747&[songmid]&C400+songmid+.m4a&guid=6612300644
# URL3(真实播放地址):http://dl.stream.qqmusic.qq.com/[filename]?vkey=[vkey](其中vkey为每个音乐文件特有的临时字符串)
requests(url1)
通过第一个URL的搜索结果,可以提取出每首音乐的songmid和media_mid(经观察,这两个值是每首音乐的唯一标识)。利用这两个参数,即可构造出完整的URL2请求。
requests(url2)
在获取URL2的响应后,可解析出每首音乐的vkey值。经分析,filename的格式通常为C400加上media_mid并后缀.m4a。由此确定了URL3的具体构成。URL3即为音乐的真实下载地址。由于对该URL其他参数的研究尚不深入,每次请求最多返回20首音乐的URL。获取这些URL后,即可通过Python脚本享受腾讯音乐资源。
# 代码实现
以下是获取音乐源地址(srcs)的核心代码块:
import requests
import urllib
import json
word = '雨蝶'
res1 = requests.get('https://c.y.qq.com/soso/fcgi-bin/client_search_cp?&t=0&aggr=1&cr=1&catZhida=1&lossless=0&flag_qc=0&p=1&n=20&w='+word)
jm1 = json.loads(res1.text.strip('callback()[]'))
jm1 = jm1['data']['song']['list']
mids = []
songmids = []
srcs = []
songnames = []
singers = []
for j in jm1:
 try:
  mids.append(j['media_mid'])
  songmids.append(j['songmid'])
  songnames.append(j['songname'])
  singers.append(j['singer'][0]['name'])
 except:
  print('wrong')


for n in range(0,len(mids)):
 res2 = requests.get('https://c.y.qq.com/base/fcgi-bin/fcg_music_express_mobile3.fcg?&jsonpCallback=MusicJsonCallback&cid=205361747&songmid='+songmids[n]+'&filename=C400'+mids[n]+'.m4a&guid=6612300644')
 jm2 = json.loads(res2.text)
 vkey = jm2['data']['items'][0]['vkey']
 srcs.append('http://dl.stream.qqmusic.qq.com/C400'+mids[n]+'.m4a?vkey='+vkey+'&guid=6612300644&uin=0&fromtag=66')
# 执行下载操作
获取到源地址列表后,下载过程便不再困难。当然,你也可以直接复制单个src链接到浏览器进行手动下载,或者利用Python进行批量下载。后者本质上是一个循环操作,原理与之前介绍的搜狗图片批量下载方法类似(注:本文使用的Python版本为python3.3.3)。
print('For '+word+' Start download...')
x = len(srcs)
for m in range(0,x):
 print(str(m)+'***** '+songnames[m]+' - '+singers[m]+'.m4a *****'+' Downloading...')
 try:
  urllib.request.urlretrieve(srcs[m],'d:/music/'+songnames[m]+' - '+singers[m]+'.m4a')
 except:
  x = x - 1
  print('Download wrong~')
print('For ['+word+'] Download complete '+str(x)+'files !')
将上述两段代码整合至同一个Python文件中,运行即可根据关键词批量下载对应的音乐文件。
# 运行效果展示
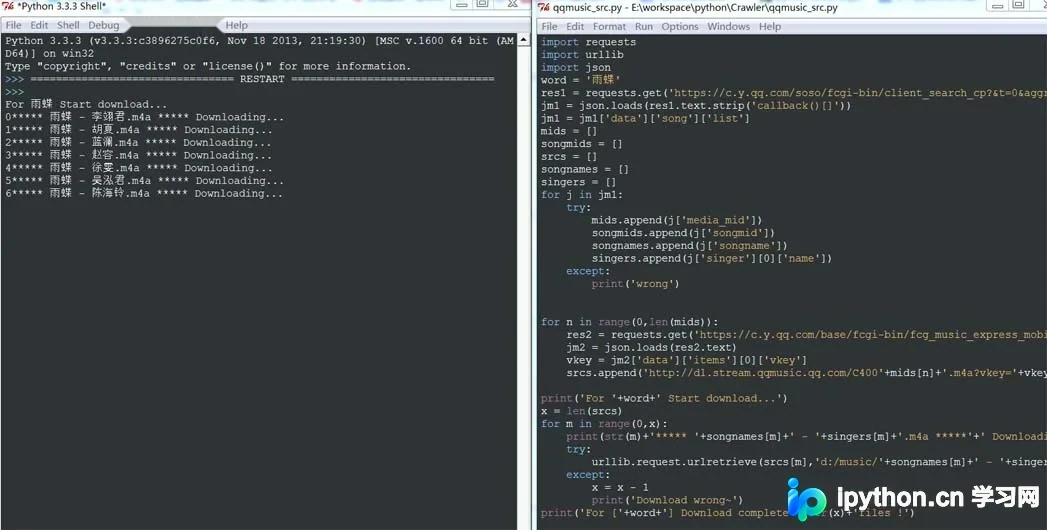
下载程序启动后,控制台将输出进度信息。查看指定的下载目录,确认文件是否生成:
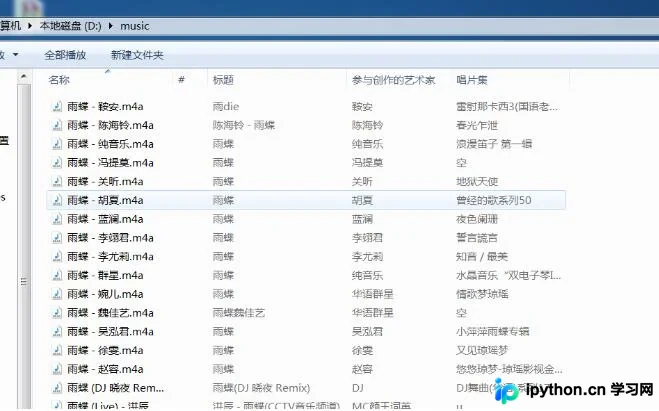
可以看到,音乐文件已成功下载至本地目录。
至此,关于QQ音乐URL爬虫程序的思路分析与实现细节已叙述完毕。
# 应用场景
对于正在开发音乐播放器壳体的开发者而言,此工具可能颇具实用价值。实际上,编写此脚本的初衷是为了服务于一个基于HTML的音乐播放器项目。目前遇到的瓶颈在于JavaScript调用Python脚本的环节,若各位读者对此有深入研究或解决方案,恳请不吝赐教,万分感谢!
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作能带来一定的帮助,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









