Python爬虫实战:利用BeautifulSoup进行数据解析与持久化
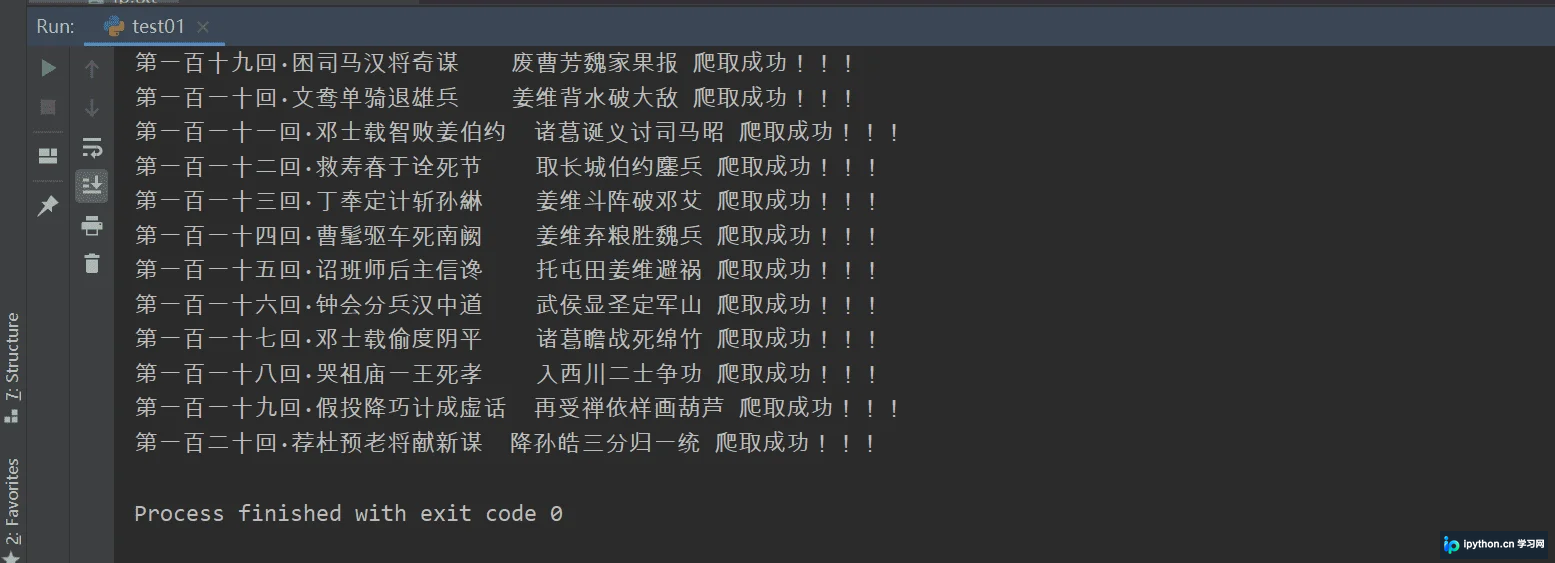
本文详解Python爬虫中BeautifulSoup库的数据解析流程。从环境安装、对象实例化到标签定位(find/select)、文本提取及属性获取,结合三国演义小说爬取案例,演示如何解析列表页与详情页,实现指定内容的持久化存储。
2026-10-11
6


本文详解Python爬虫中BeautifulSoup库的数据解析流程。从环境安装、对象实例化到标签定位(find/select)、文本提取及属性获取,结合三国演义小说爬取案例,演示如何解析列表页与详情页,实现指定内容的持久化存储。
教你使用 Python 的 requests 与 BeautifulSoup 编写第一个网页爬虫,步骤详尽,示例完整。
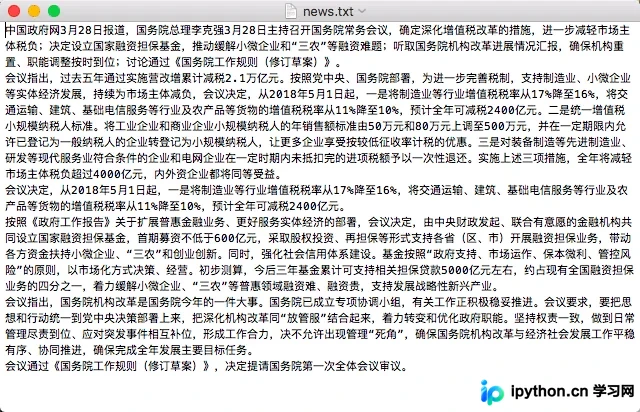
本文介绍如何使用Python的requests和BeautifulSoup库抓取指定网页的正文内容,并利用jieba库对提取的文本进行分词处理。通过具体代码示例,展示了从获取HTML、解析DOM、提取文本到写入文件及分词输出的完整流程,适用于简单的网页内容分析与预处理场景。
面向新手的Python爬虫入门教程,从Python运行环境检查、虚拟环境与核心依赖库配置入手,系统解析HTTP网络请求与DOM树解析机制,提供完整可运行的代码实现与常见报错排障方案。
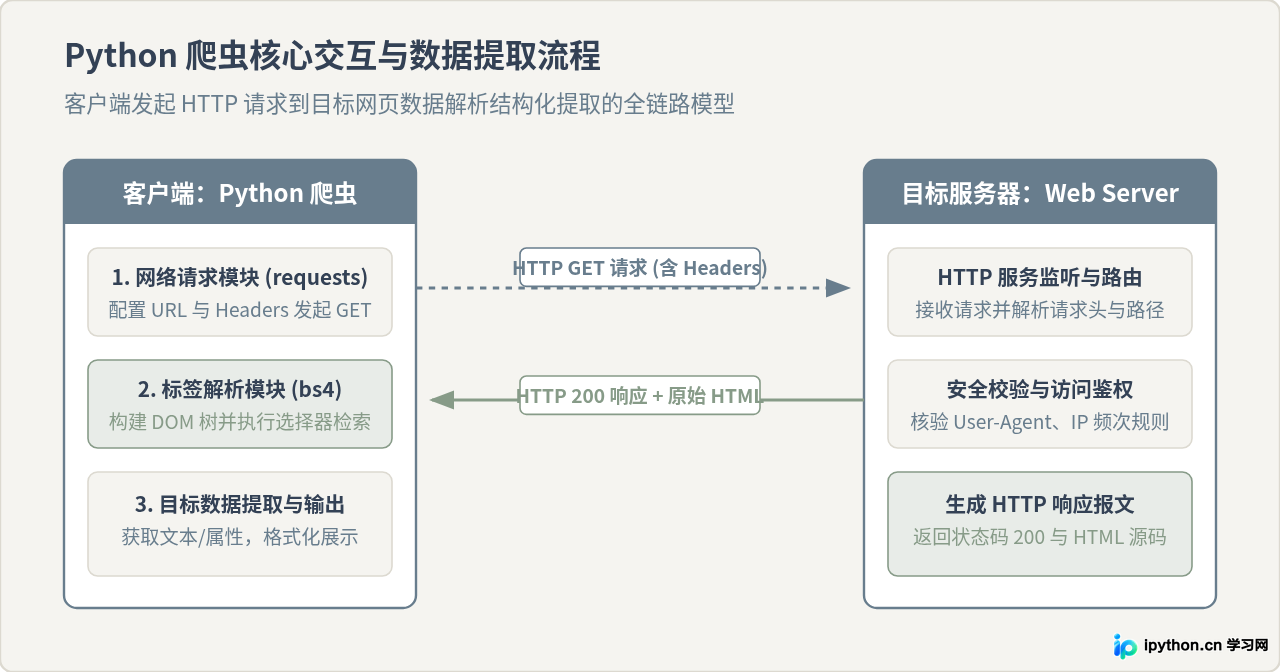
本文介绍如何使用 Python 爬取 114 黄页的商家联系电话及名称。通过 requests 获取页面源码,利用 BeautifulSoup 解析 HTML 结构,提取特定 div 下的列表数据。代码包含翻页逻辑、请求头设置及 CSV 文件写入,适合初学者学习基础爬虫开发。
本文介绍如何使用Python爬虫批量抓取城市公交网络站点数据。通过requests获取页面,利用BeautifulSoup解析HTML结构,提取公交线路链接、站点信息及运营详情。代码包含完整的请求、解析与数据保存逻辑,适用于学习网络爬虫基础及数据抓取实战。
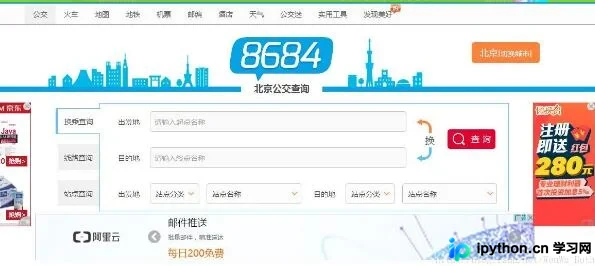
深入解析为什么Python成为网络爬虫开发的首选语言,从原型开发敏捷度、全流程专项工具生态、I/O密集型任务特性及下游数据协同等维度展开系统剖析,并提供技术选型指南。
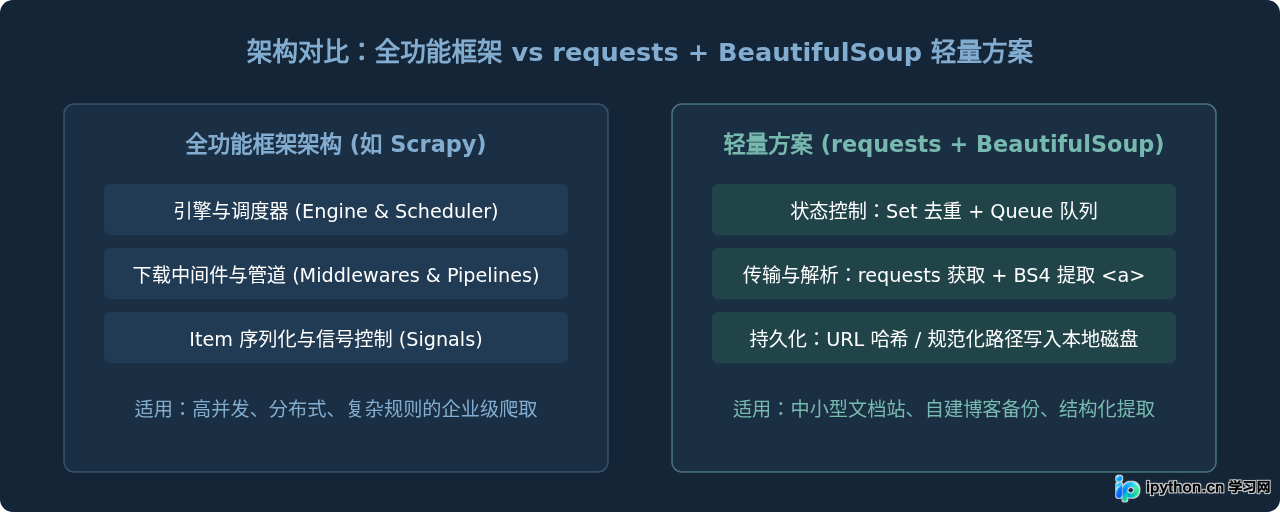
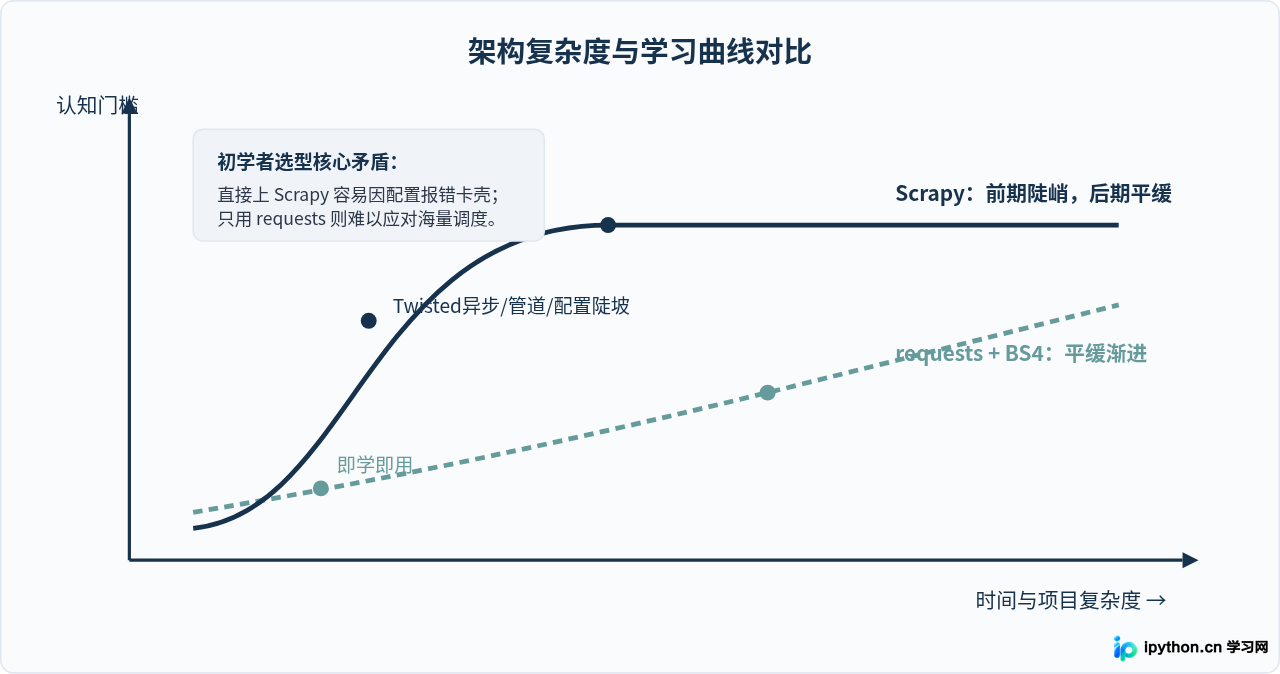
针对Python爬虫初学者在Scrapy与requests+BS4之间的选型困惑,深入对比两者的学习成本、架构复杂度、适用场景与演进路径,提供清晰可执行的决策建议。
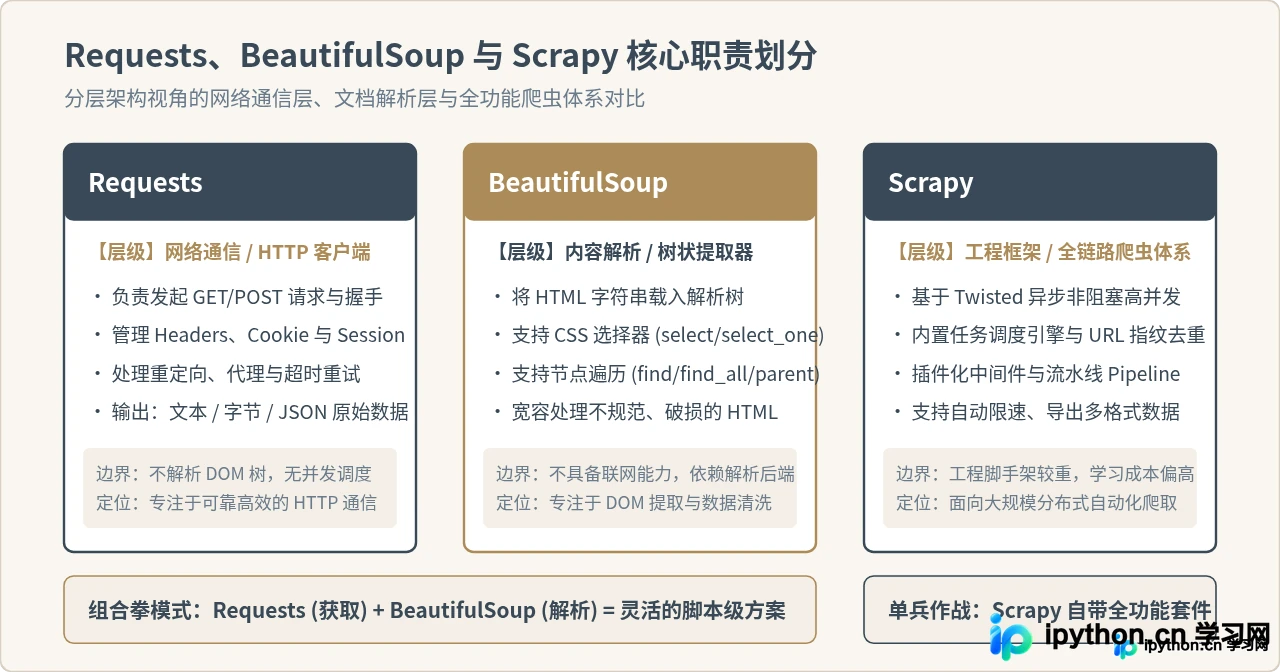
深入对比 Python 爬虫三大主流工具 Requests、BeautifulSoup 与 Scrapy 的定位差异、工作原理与适用场景,提供选型决策树与实践代码。
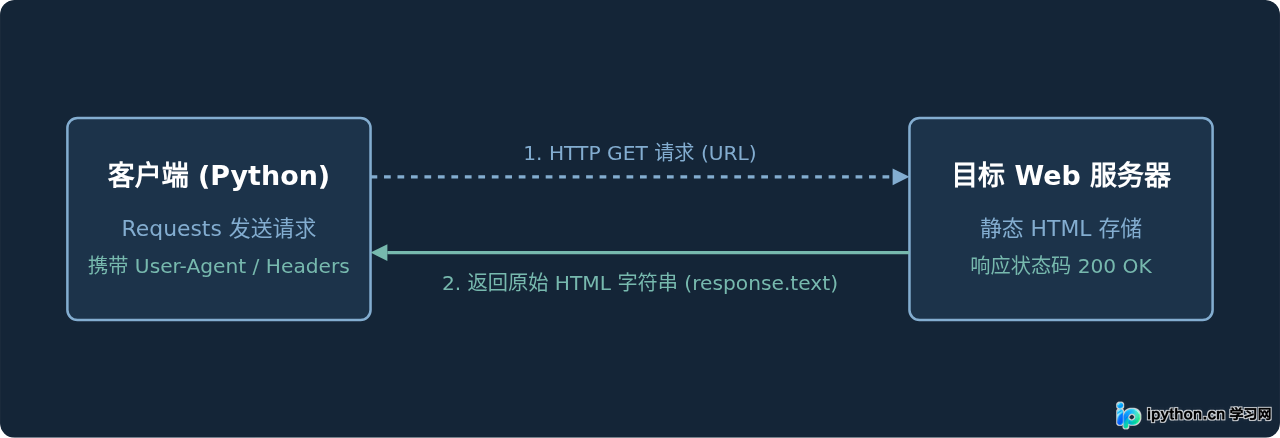
面向初学者的Python静态网页爬虫教程,系统讲解Requests网络请求与BeautifulSoup解析库的配合使用,包含环境安装、选择器提取、完整实战代码与常见问题排查。
讲解如何使用Python批量爬取网站页面,将HTML、CSS、JavaScript和图片等资源保存到本地,并重写网页链接,形成可以离线浏览的完整HTML目录结构。
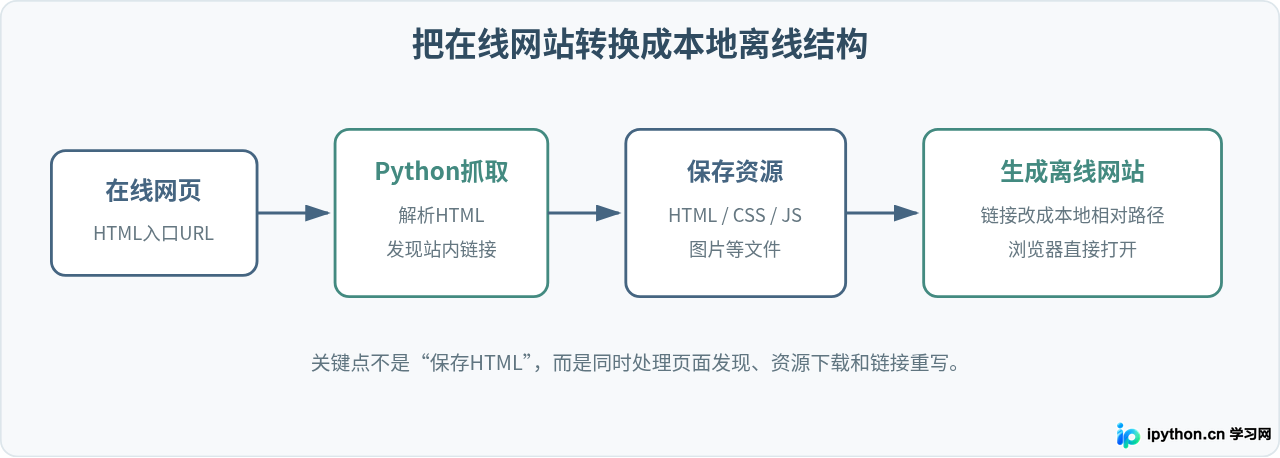
本文讲解如何仅使用 Python 标准库配合 requests 与 BeautifulSoup 两个轻量模块,实现从单个入口页出发、递归抓取全站链接并批量将 HTML 页面持久化到本地磁盘的完整方案。