

Python爬虫库怎么选?Requests、BeautifulSoup与Scrapy适用场景对比

在 Python 爬虫开发中,许多初学者容易陷入一个认知误区:将 Requests、BeautifulSoup 与 Scrapy 视为并列的“三选一”竞品。事实上,这三个库所处的技术层级与职责边界完全不同。简明结论是:Requests 专注底层网络通信与 HTTP 数据收发;BeautifulSoup 专注 HTML/XML 语法树的解析与字段提取;而 Scrapy 是一整套工业级工程爬虫框架,内置异步并发、任务调度、防反爬中间件与数据持久化管道。对于几百页以内的轻量级、临时性采集任务,通常使用“Requests + BeautifulSoup”的黄金搭档;而对于数万至百万级页面、需要断点续爬与分布式扩展的大规模工程,Scrapy 是当之无愧的工业标准。本文将从架构定位、代码实现、运行机制与选型决策四个维度展开深入对比。
一、核心定位与职责分工:三大工具的本质差异
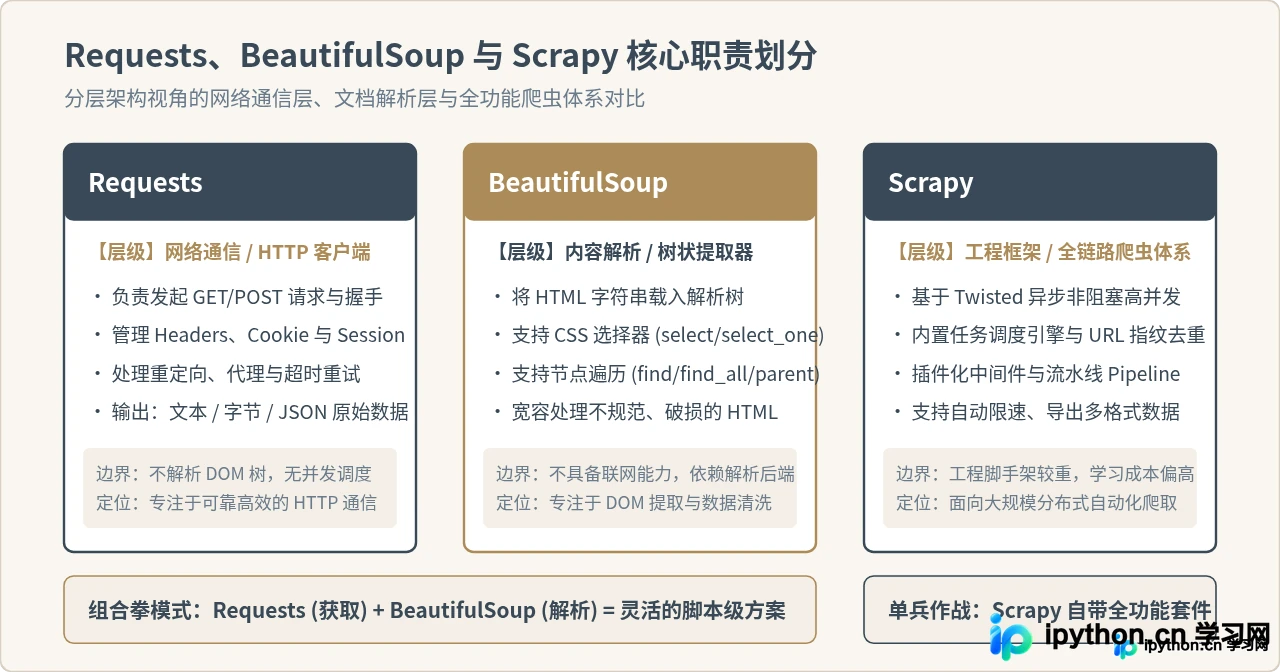
理解这三者的第一步,是明确它们在网络爬虫流水线中所处的层级位置。很多开发者以为 BeautifulSoup 可以独立抓取网页,或者以为 Scrapy 只是一个加强版的 Requests,这些都是对技术边界的混淆。
- Requests(网络通信层):只负责 HTTP 请求的组装与发送。它能够高效处理 Cookie、Session 会话、请求头伪装、代理设置及连接池复用,但它完全不具备任何解析 HTML 树结构的能力,返回的只是网页原始文本或二进制字节流。
- BeautifulSoup(文档解析层):只负责解析传入的 HTML 或 XML 字符串,构建内存中的 DOM 节点树。它提供了简洁优雅的 CSS 选择器与节点遍历 API,但它自身完全没有网络请求功能,必须依赖外部库传入网页源码。
- Scrapy(工程体系层):基于 Twisted 异步事件驱动架构的完整应用框架。它不仅内置了高性能的 Request 下载引擎和基于 XPath/CSS 的选择器,更具备调度队列、指纹去重、数据清洗流水线和插件系统。
二、Requests + BeautifulSoup 组合:轻量级数据抓取的操作流程
在日常数据抓取中,超过 70% 的需求属于小型采集:例如抓取几页行业报告、监控特定商品价格、提取某个博客的全部文章。这种场景下,搭建笨重的工程框架并不经济,“Requests + BeautifulSoup”是极其高效且灵活的组合。
这一组合的标准操作流程分为 6 个步骤:准备元信息、发送 HTTP 请求、编码校验、加载 DOM 树、定位提取节点、数据格式化存储。
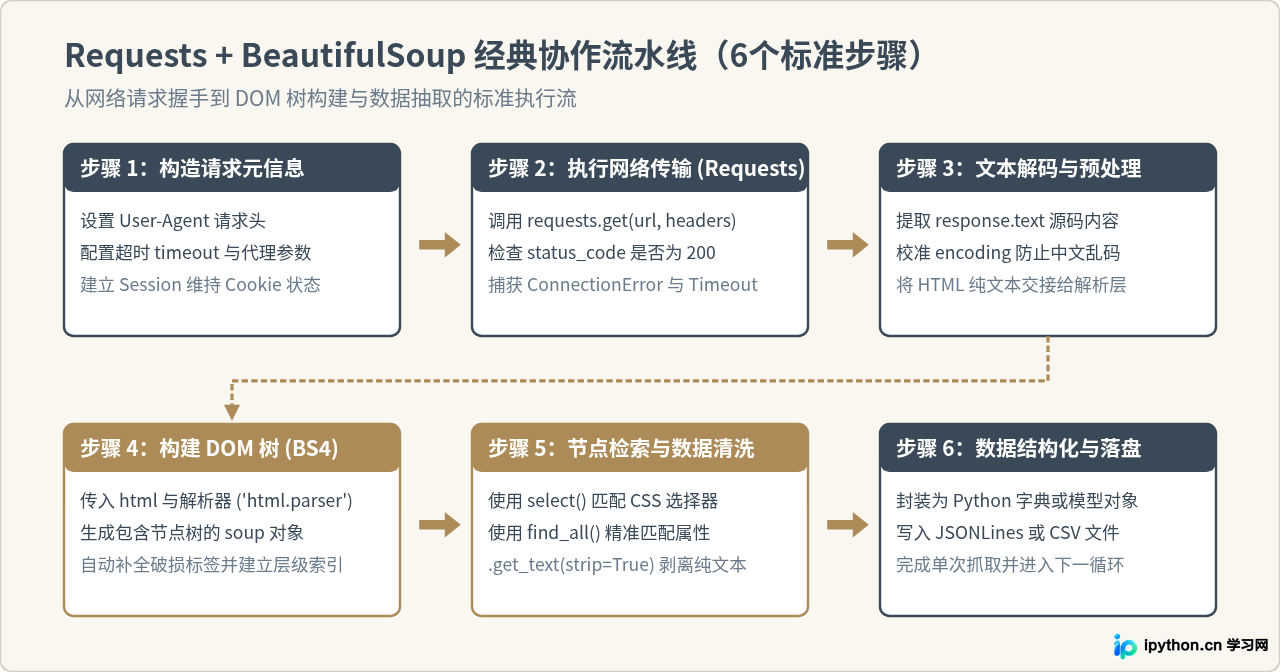
实战示例:抓取静态列表页文章标题与链接
下面是一个标准的轻量级爬虫示例。代码中包含异常捕获、请求头伪装、状态码检查以及 CSS 选择器提取:
import requests
from bs4 import BeautifulSoup
import json

def fetch_articles(target_url):
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36',
        'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8'
    }

    try:
        # 1. 发送 HTTP 请求
        response = requests.get(target_url, headers=headers, timeout=10)
        # 2. 检查响应状态码
        if response.status_code != 200:
            print(f'请求失败,HTTP 状态码: {response.status_code}')
            return []

        # 3. 确保正确编码
        response.encoding = response.apparent_encoding
        html_content = response.text

        # 4. 交给 BeautifulSoup 解析 DOM 树
        soup = BeautifulSoup(html_content, 'html.parser')

        articles = []
        # 5. 使用 CSS 选择器抽取文章卡片
        cards = soup.select('div.article-card')
        for card in cards:
            title_node = card.select_one('h2.title > a')
            date_node = card.select_one('span.publish-date')

            if title_node:
                articles.append({
                    'title': title_node.get_text(strip=True),
                    'link': title_node.get('href', ''),
                    'date': date_node.get_text(strip=True) if date_node else ''
                })
        return articles

    except requests.exceptions.RequestException as error:
        print(f'网络通信异常: {error}')
        return []

# 示例调用
if __name__ == '__main__':
    data = fetch_articles('https://example.com/news')
print(f'成功抓取到 {len(data)} 条数据')代码要点说明:在这段代码中,Requests 负责通信保障(超时中断与状态码判定),BeautifulSoup 负责在内存中查询目标节点。两个库各司其职,脚本总共不到 50 行,无需任何项目配置或命令行脚手架,开箱即用。
三、Scrapy 工业级框架:异步架构与高并发机制
当目标网站规模扩大到几万甚至几百万个页面时,Requests + BeautifulSoup 组合就会面临严峻挑战:Requests 本质是同步阻塞的,每一条请求都必须等待网络 I/O 返回才能执行下一条;如果自行引入多线程或线程池,就必须手动处理复杂的任务队列、线程锁、网络重试和 URL 指纹去重。这时,继续“手搓轮子”的成本将急剧上升,而 Scrapy 正是为此类工程化场景而生。
Scrapy 底层基于 Twisted 异步事件驱动引擎构建,具有严密而高效的五大核心组件:
- Engine(引擎中枢):协调各个模块之间的数据流转,在特定事件发生时触发相应操作。
- Scheduler(调度器):接收引擎发来的请求并排入队列,利用 SHA1 哈希指纹自动过滤已抓取的重复 URL。
- Downloader(下载器):利用 Twisted 异步非阻塞高并发获取网页内容,并将生成的 Response 返回给引擎。
- Spiders(爬虫逻辑):开发者编写核心解析规则的地方,提取结构化数据(Item)或生成新的抓取请求。
- Item Pipeline(数据管道):负责对 Spider 提取出的数据进行清洗、有效性验证、去重并最终存入数据库(MySQL、MongoDB 或 Elasticsearch)。
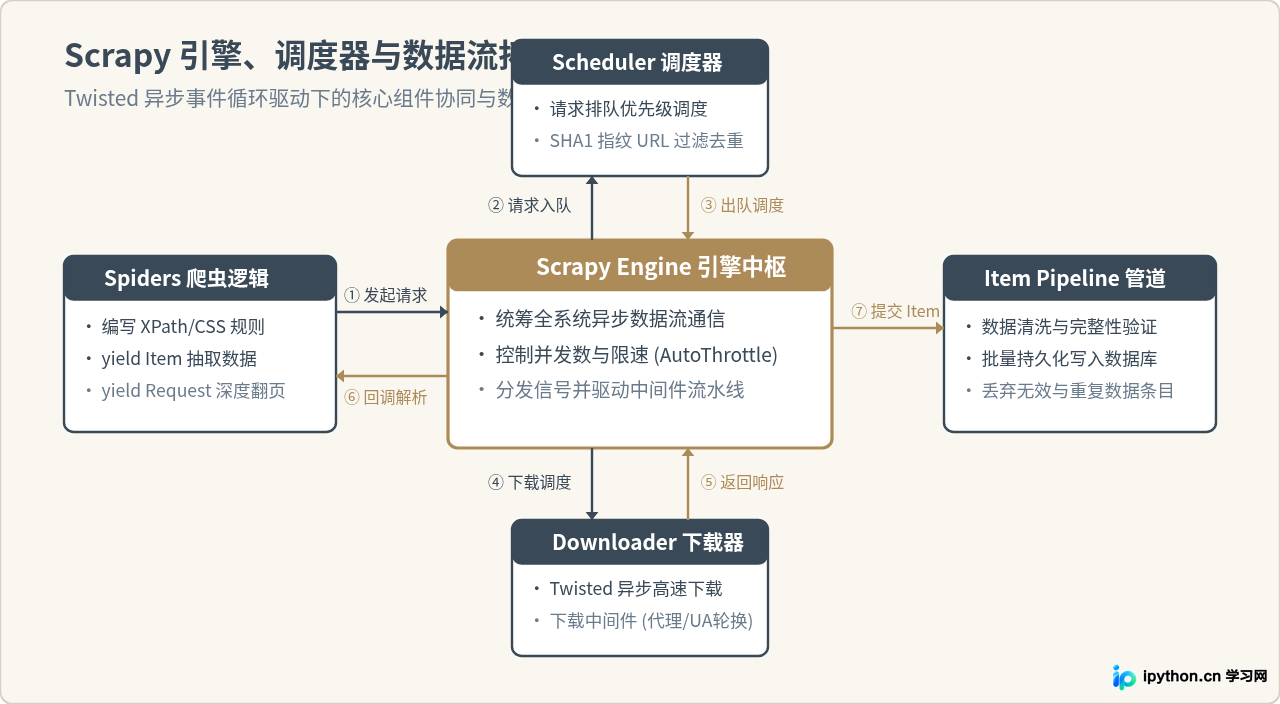
Scrapy Spider 核心代码范式
在 Scrapy 中,开发者无需关注并发连接管理与异常重试,只需定义爬虫入口并解析数据:
import scrapy

class TechBlogSpider(scrapy.Spider):
    name = 'tech_blog'
    allowed_domains = ['example.com']
    start_urls = ['https://example.com/blog/page/1']

    def parse(self, response):
        # 1. 使用内置的 CSS 选择器解析当前页文章
        for article in response.css('div.post-preview'):
            yield {
                'title': article.css('h2.title a::text').get(),
                'url': response.urljoin(article.css('h2.title a::attr(href)').get()),
                'author': article.css('span.author-name::text').get()
            }

        # 2. 自动追踪下一页链接并生成新 Request(由调度器接管去重)
        next_page = response.css('a.next-page::attr(href)').get()
        if next_page is not None:
yield response.follow(next_page, callback=self.parse)工程优势分析:当运行 scrapy crawl tech_blog 时,Scrapy 会自动启动 16 个并发下载线程,异步触发请求;若遇到 500 报错会自动进入重试队列;遇到访问过的 URL 会通过指纹库自动剔除;提取出的字典会自动流入数据管道进行存储。这些机制若用 Requests + BeautifulSoup 自行实现,往往需要上千行代码与极高的测试成本。
四、选型决策指南与典型业务场景对比
为了在实际开发中少走弯路,我们可以通过以下决策逻辑对号入座,根据具体项目规模和需求特点选择最合适的技术路线:
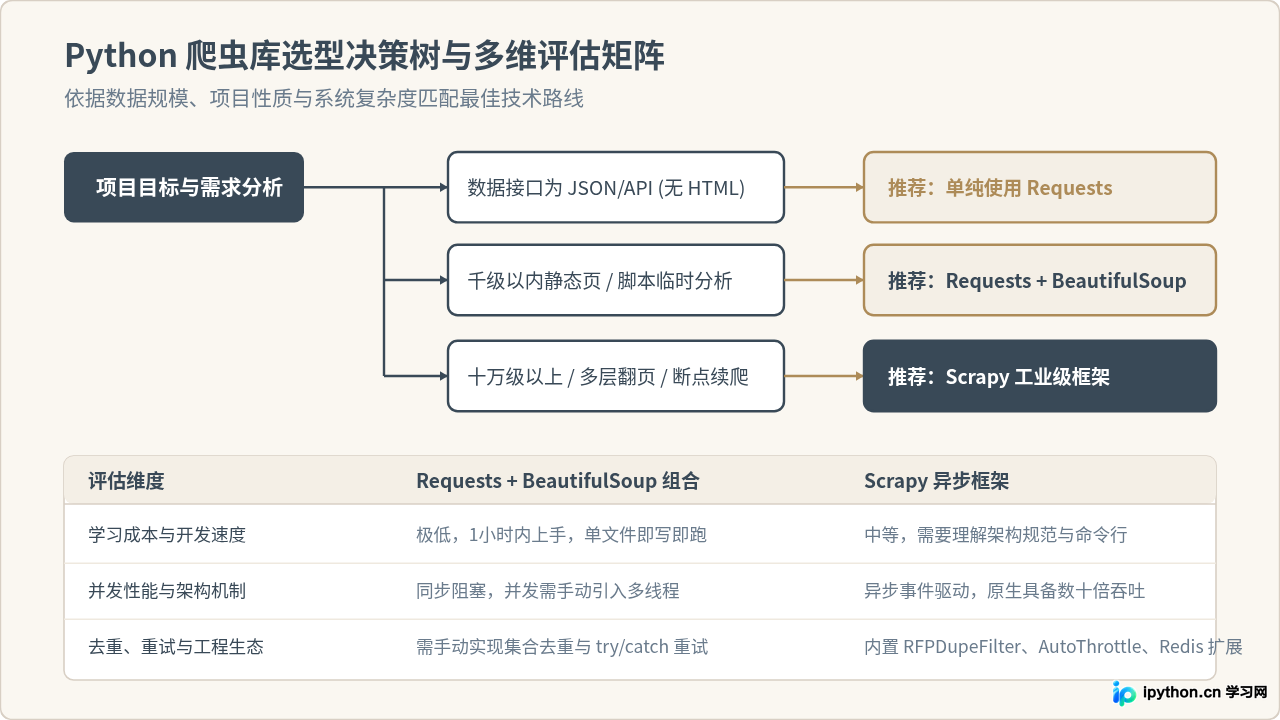
详细场景对照表
| 场景需求 | 推荐选择 | 核心理由与实施建议 |
|---|---|---|
| 纯 JSON 数据抓取(移动端 API、内部微服务) | 单纯使用 Requests | 直接调用 response.json() 即可获取字典,无需加载 DOM 解析器,节约内存开销。 |
| 1~2000 页的静态 HTML 采集、临时数据分析 | Requests + BeautifulSoup | 代码编写直观,便于单步调试,直接利用 CSS 选择器快速产出数据。 |
| 需要复杂树状遍历(查找兄弟节点、定位祖先元素) | BeautifulSoup(配 lxml 后端) | BeautifulSoup 的 find_parent()、find_next_sibling() 语法表达力极佳。 |
| 全站抓取、深度递归翻页、数十万级以上数据量 | Scrapy | Twisted 异步并发榨干网络带宽,内置调度队列防爆内存,管道批量落盘更稳定。 |
| 分布式爬虫集群(多台机器协同爬取) | Scrapy + Scrapy-Redis | 利用 Redis 共享调度队列与去重指纹库,现成生态成熟,无需从头自研。 |
五、关键避坑点与生产环境实践建议
-
编码陷阱与中文乱码:
在使用 Requests 抓取中文网站时,
response.encoding往往根据 HTTP 响应头部的Content-Type推断,如果网站未显式声明,Requests 默认会推断为ISO-8859-1,导致中文显示为乱码。解决办法是在读取文本前显式指定response.encoding = response.apparent_encoding,或者直接使用response.content.decode('utf-8', errors='ignore')。 -
BeautifulSoup 解析器选择:
BeautifulSoup 支持多种解析后端。Python 自带的
html.parser兼容性好且无需额外安装依赖;但在数据量较大或 HTML 格式极其混乱时,推荐安装lxml库并使用BeautifulSoup(html, 'lxml'),其 C 语言底层不仅解析速度提升数倍,对容错标签的修补能力也更为强悍。 -
反爬合规与礼貌爬取:
爬虫开发不仅要追求速度,更要注重稳定性与合规。无论是 Requests 还是 Scrapy,都必须始终携带合法的
User-Agent;在抓取过程中加入合理的随机延迟(如 0.5 到 2 秒),避免因瞬间高频请求打垮目标服务器或触发 IP 封禁;在 Scrapy 中应开启AUTOTHROTTLE_ENABLED = True智能限速插件。
总结
在 Python 爬虫的技术选型中,不存在绝对的“优胜劣汰”,只有“合适与否”。Requests 解决了怎么拿到数据,BeautifulSoup 解决了怎么理清数据,而 Scrapy 解决了怎么大规模、高并发、有条不紊地流水线作业。初学者建议先掌握 Requests 与 BeautifulSoup 的协作,理解网络通信与 DOM 树的底层细节;当面临工业级的大规模爬取挑战时,再平滑过渡到 Scrapy 框架,方能在爬虫工程开发中游刃有余。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









