Python爬取安居客二手房数据实战:从列表页到详情页的完整解析
本文详细讲解如何利用Python的requests和BeautifulSoup库,系统性地爬取安居客郑州地区的二手房源数据。内容涵盖列表页HTML结构分析、房源链接提取、分页逻辑处理(递归调用与下一页判断)以及详情页数据抓取。通过具体代码示例,展示如何构建完整的爬虫流程,包括请求头设置、DOM节点定位及数据清洗,为地理信息分析提供数据支持。
2026-10-13
4


本文详细讲解如何利用Python的requests和BeautifulSoup库,系统性地爬取安居客郑州地区的二手房源数据。内容涵盖列表页HTML结构分析、房源链接提取、分页逻辑处理(递归调用与下一页判断)以及详情页数据抓取。通过具体代码示例,展示如何构建完整的爬虫流程,包括请求头设置、DOM节点定位及数据清洗,为地理信息分析提供数据支持。
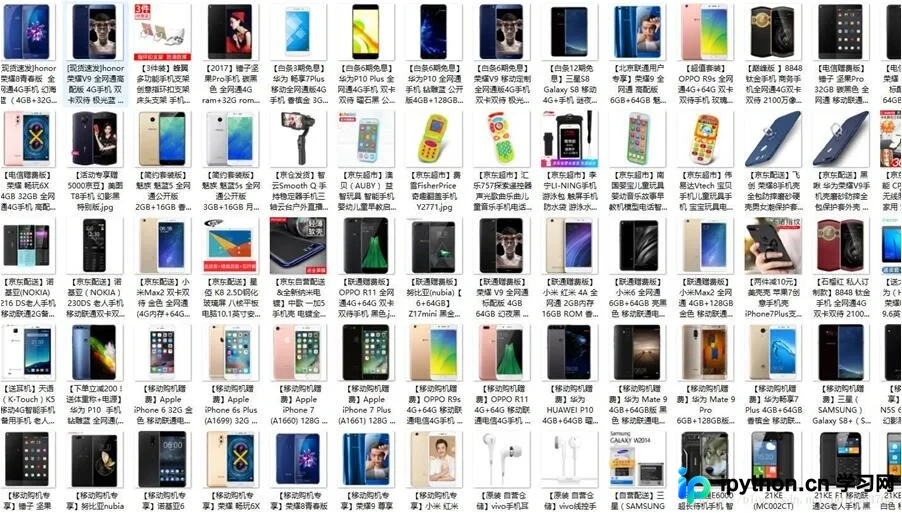
本文介绍使用Python 2.7结合urllib与BeautifulSoup库,实现从京东网站批量爬取商品图片的方法。通过解析页面DOM结构获取图片链接与商品名称,自动创建目录并按名保存。代码包含URL构造、异常处理及进度显示,适用于学习网页抓取与文件存储操作。
本文深入分析Python中获取当前页面所有链接的四种主流方法,涵盖正则表达式、BeautifulSoup、lxml及Selenium。重点指出iframe内容无法通过常规DOM解析获取的问题,并提供针对iframe的额外抓取策略,帮助开发者全面掌握网页数据提取技巧。
本文详细介绍Python中Beautiful库的HTML解析方法。内容涵盖安装步骤、解析器选择(lxml/html5lib)、基础代码示例及利用select方法结合CSS选择器定位元素。通过具体案例演示如何提取页面数据,适合初学者快速掌握网页内容抓取技巧。
本文详细讲解如何使用Python3结合Requests和BeautifulSoup库实现V2EX网站的模拟登录。通过获取动态Token、构造表单数据及发送POST请求,帮助开发者掌握Web自动化登录的核心技术,适合初学者进行练手实践。
本文探讨Python爬虫中常见的乱码问题,介绍如何利用chardet库自动检测网页编码,并通过unicode解码与encode编码将不同字符集(如Big5、GBK、EUC-JP)统一转换为UTF-8,确保数据顺利存入MySQL数据库。
本文介绍基于Python的爬虫实现方案,核心依赖urllib2进行HTTP请求与源码获取,利用BeautifulSoup解析HTML结构。文中提供了完整的类封装代码,涵盖分页链接生成、页面内容提取及数据存储功能,适用于基础网页数据采集场景。
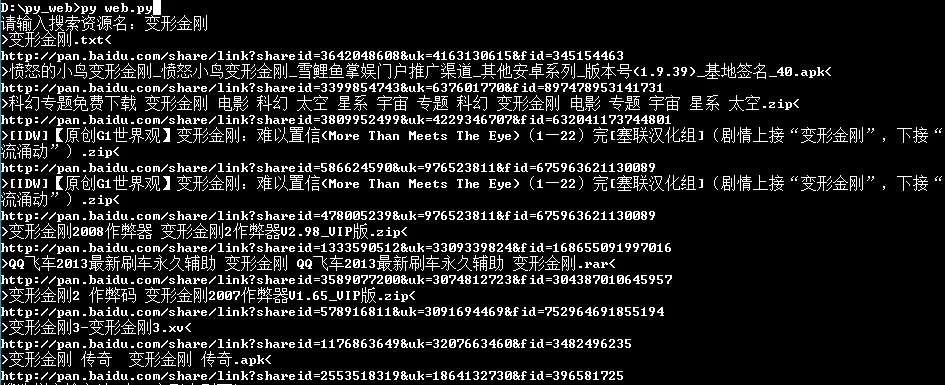
本文分享了一段使用Python编写的爬取盘多多网站百度云资源链接的示例代码。作者回顾了早期学习Python时的开发过程,提供了完整的源代码及必要的库依赖说明。代码通过urllib和BeautifulSoup解析网页,提取并解码搜索资源对应的百度云地址,适合初学者参考Python网络爬虫的基础实现逻辑。
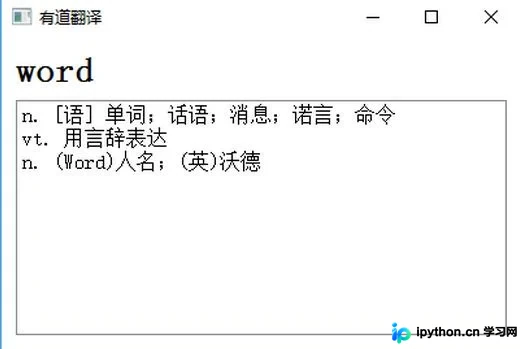
本文介绍了一款基于Python开发的Windows单词监控翻译工具。该程序利用Qt监听系统剪切板变化,自动识别英文单词并调用有道翻译接口获取释义,最终通过Qt界面展示结果。解决了传统PDF阅读器翻译与注释功能冲突的问题,提升英文文献阅读效率。
本文介绍一个基于Python的简单图片爬虫程序,旨在帮助用户批量保存知乎问题中的图片。程序通过Requests库模拟浏览器请求获取页面数据,利用BeautifulSoup解析HTML提取图片链接,并根据图片尺寸过滤头像和小图标。文中提供了使用PIL、OpenCV和skimage等多种方式处理图片的代码示例,适用于对网页图片抓取有基础需求的开发者。
本文深入讲解Python中BeautifulSoup库的使用,涵盖从安装到高级应用的全流程。内容详解HTML树形结构、Tag与NavigableString数据类型,并通过遍历文档树与搜索文档树(find/find_all)两种核心方法,演示如何高效定位和提取HTML中的目标数据,结合代码示例帮助开发者快速掌握网页数据抓取技巧。
本文介绍使用Python 2.7结合BeautifulSoup3.2.1实现优酷视频批量下载的方法。通过解析网页数据获取播放链接,利用Python的os.system调用iku命令行工具完成下载。文章详细说明了程序逻辑、环境配置及注意事项,旨在提供一种实用且高效的视频数据采集方案。