
解决Python爬虫报错:bs4.FeatureNotFound找不到解析器
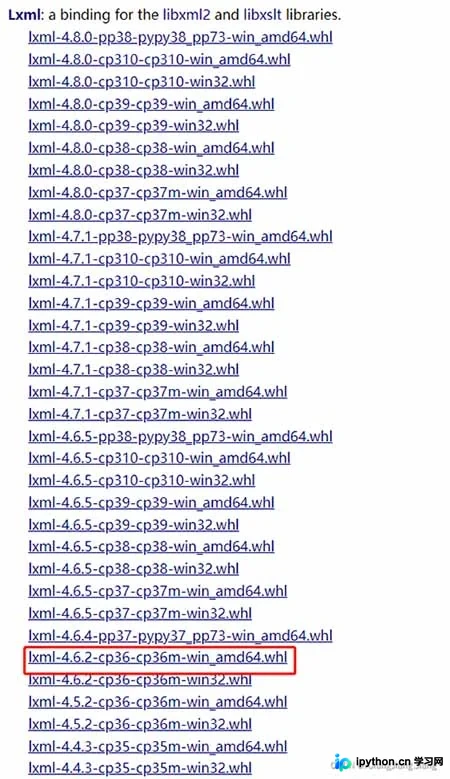
本文详细记录在Windows环境下为Python 3.6安装BeautifulSoup及lxml解析器的完整步骤。针对直接pip安装lxml报错的问题,提供通过下载whl文件手动安装的解决方案。同时解决PyCharm中因未正确引入库导致的bs4.FeatureNotFound错误,确保爬虫项目顺利运行。
2026-10-12
6


本文详细记录在Windows环境下为Python 3.6安装BeautifulSoup及lxml解析器的完整步骤。针对直接pip安装lxml报错的问题,提供通过下载whl文件手动安装的解决方案。同时解决PyCharm中因未正确引入库导致的bs4.FeatureNotFound错误,确保爬虫项目顺利运行。
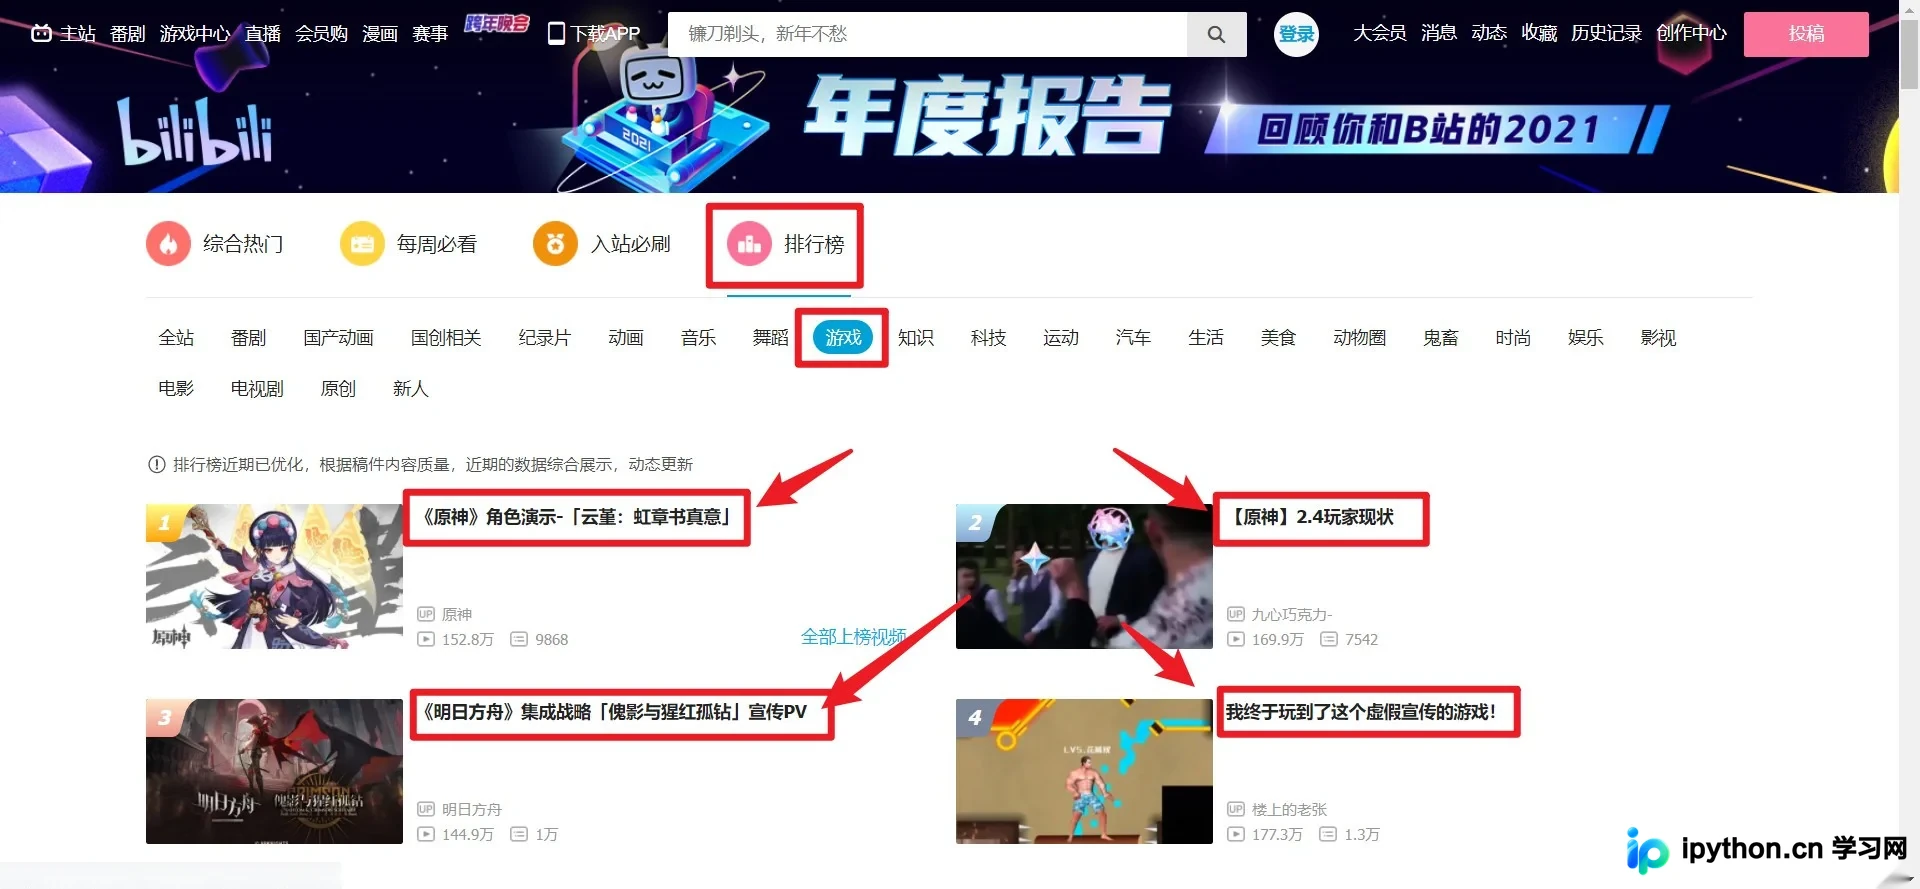
本文介绍如何使用Python的Requests和BeautifulSoup库,从Bilibili游戏排行榜页面抓取视频标题及对应链接。通过逐步优化代码,解决HTML解析、链接协议补全(http:)及数据提取问题,最终实现简洁高效的数据爬取,适合Python初学者参考学习。
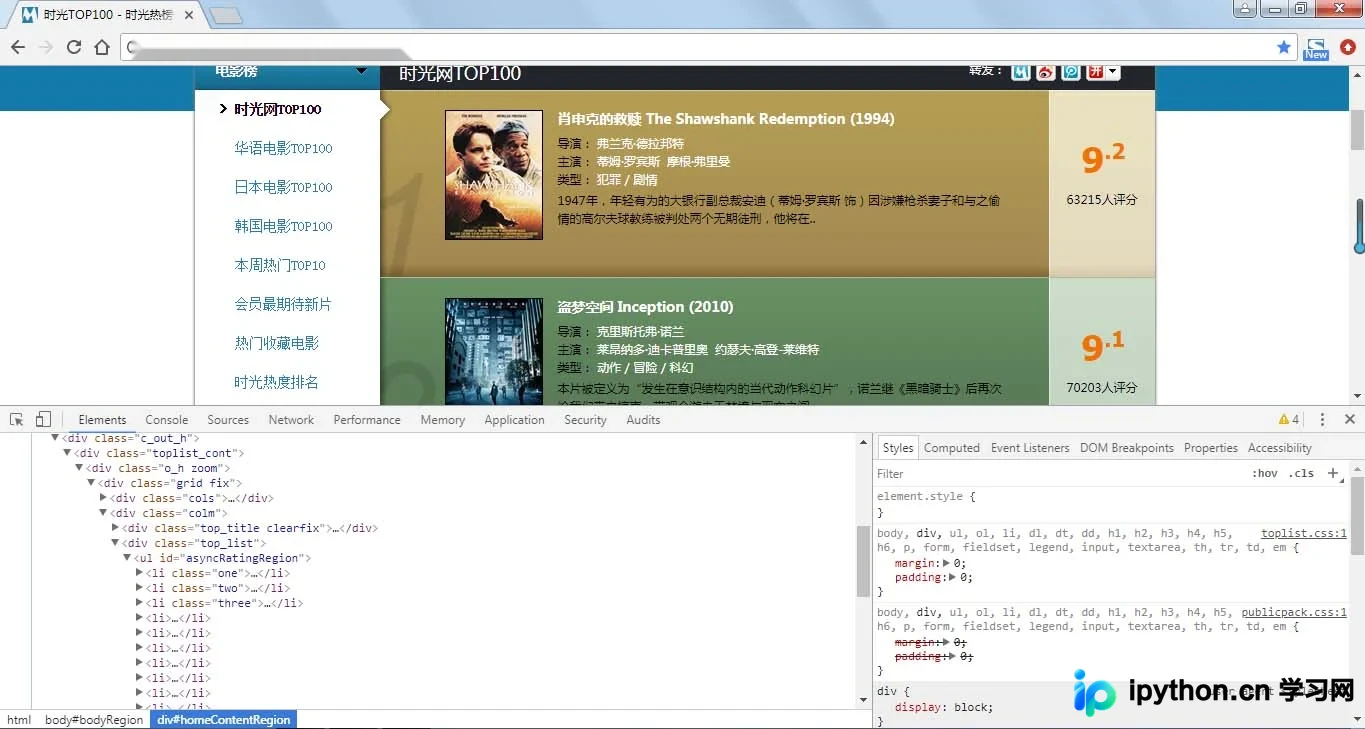
本文演示如何使用Python结合BeautifulSoup与正则表达式,从时光网爬取全球、华语、日本及韩国Top100电影数据。通过解析HTML结构处理分页逻辑,提取排名、名称、简介、评分及评论人数。随后将数据保存为CSV,利用matplotlib进行可视化对比分析,重点展示不同地区电影评论热度的差异,为数据清洗与初步分析提供完整代码示例。
简要说明使用 Python 结合 requests 和 BeautifulSoup 库,通过模拟请求与 HTML 解析,批量获取京东商城特定分类下商品详情页链接的方法。提供完整代码、运行条件及反爬注意事项,适合初学者掌握基础网页数据提取流程。
本文针对 Python 结合 BeautifulSoup 抓取网页时出现的中文乱码问题,详细分析了字符集不匹配与终端默认编码差异的根本原因。通过提供指定解析参数、显式转换输出编码等实操步骤,帮助开发者快速定位并彻底解决控制台或文件写入时的乱码现象,附带版本兼容性提示与常见排错方案。
本文提供基于 Python 3 提取网页图片链接的可靠方案。通过 requests 与 BeautifulSoup 组合,可精准定位 img 标签中的 src 属性,自动处理相对路径并补全域名。示例涵盖完整的 HTTP 请求、DOM 遍历逻辑及基础异常拦截,适用于常规数据采集任务。
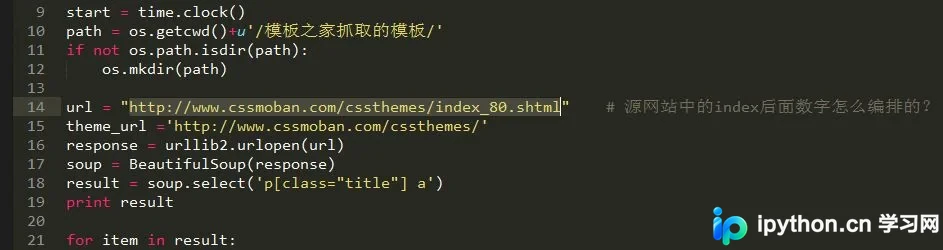
本文介绍如何使用Python结合BeautifulSoup库批量抓取指定站点的CSS模板资源。通过解析页面DOM结构提取目标链接,自动下载压缩文件至本地目录。附带完整代码示例、环境配置步骤及常见报错解决方法,帮助开发者快速实现静态资源的自动化采集。
本文系统梳理了Python解析HTML的核心方案,横向对比正则表达式、BeautifulSoup与lxml的运行差异与代码实现,提供动态渲染应对、表格转换与编码排错等实战技巧,助力开发者稳定高效地完成网页数据抽取任务。
本文介绍Python爬虫库Beautiful Soup的功能与安装方法。作为网页数据抓取工具,它提供简单的Python式函数处理导航、搜索、修改分析树。文章详细说明了从conda、pip到手动安装的多种途径,并演示了如何创建Beautiful Soup对象及解析HTML内容。
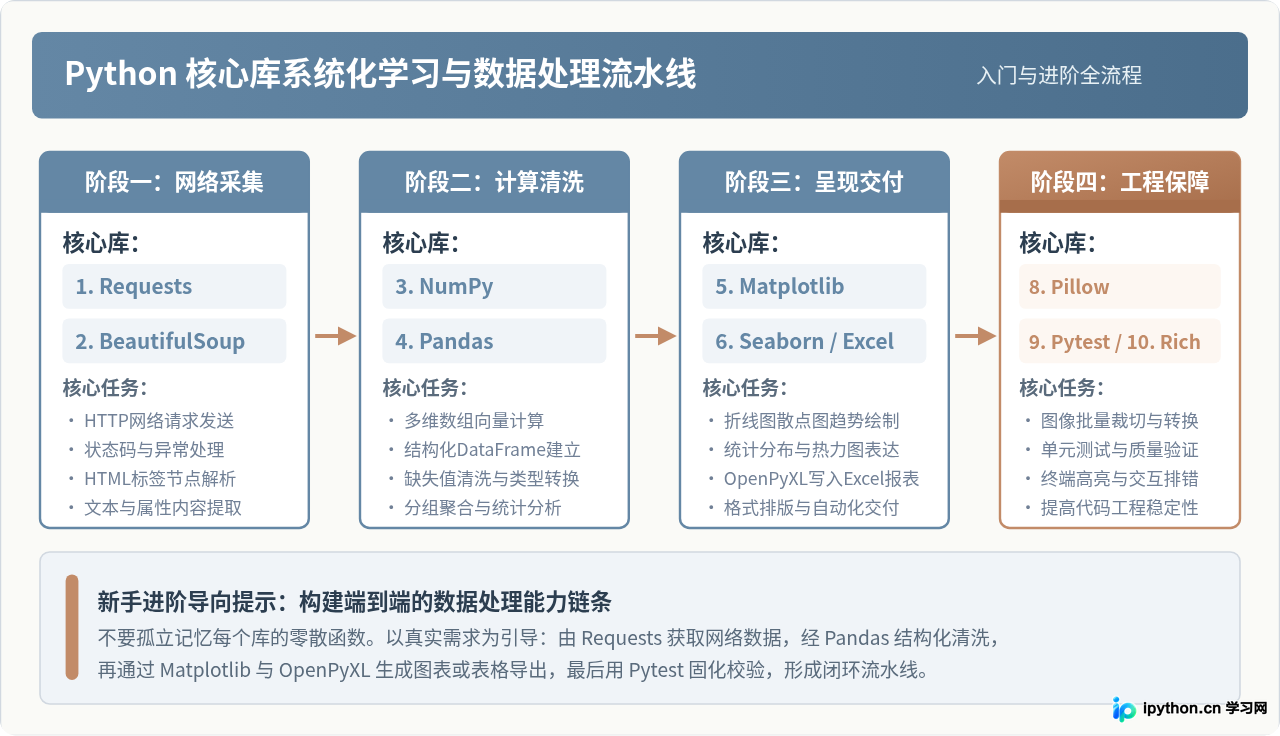
专为Python初学者梳理的10个核心第三方库入门指南,涵盖Requests、Pandas、NumPy、BeautifulSoup等高频库的适用场景、核心用法、示例代码与避坑要点。
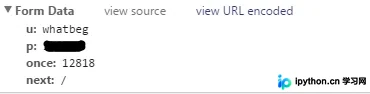
本文详细解析如何使用Python的requests.Session实现网站模拟登录。通过V2EX网站的登录流程为例,演示如何利用BeautifulSoup解析HTML获取动态参数(如once值),构建POST请求数据,并利用Session对象跨请求保持Cookie状态,最终验证登录成功。
本文详细介绍如何在 Python 中使用 BeautifulSoup 库解析 HTML 网页。通过安装依赖、配置代理请求、结合 find 方法与 CSS 选择器提取标题、链接及指定元素文本,帮助开发者快速实现静态页面的自动化数据抓取与结构化处理。