Python爬取网页的详细步骤与代码实例教程
一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
2026-10-15
40


一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
本文介绍如何利用Python的BeautifulSoup库批量从城市美食及景点介绍等HTML页面中提取body标签内的具体内容。通过遍历目录结构并解析文件,实现自动化数据抓取与存储,为后续数据处理提供基础。
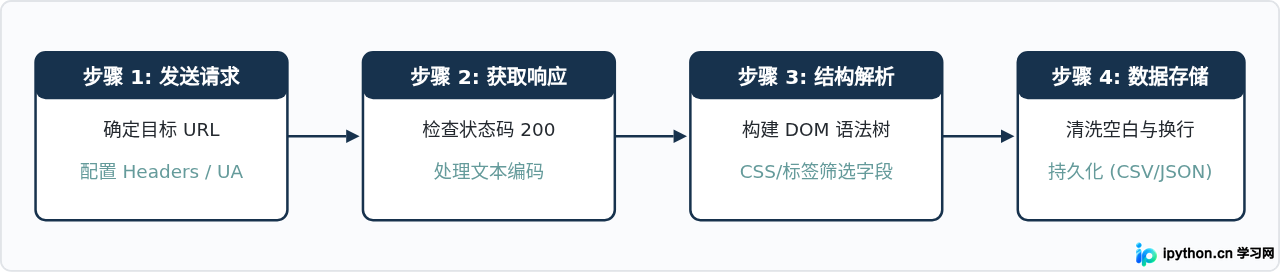
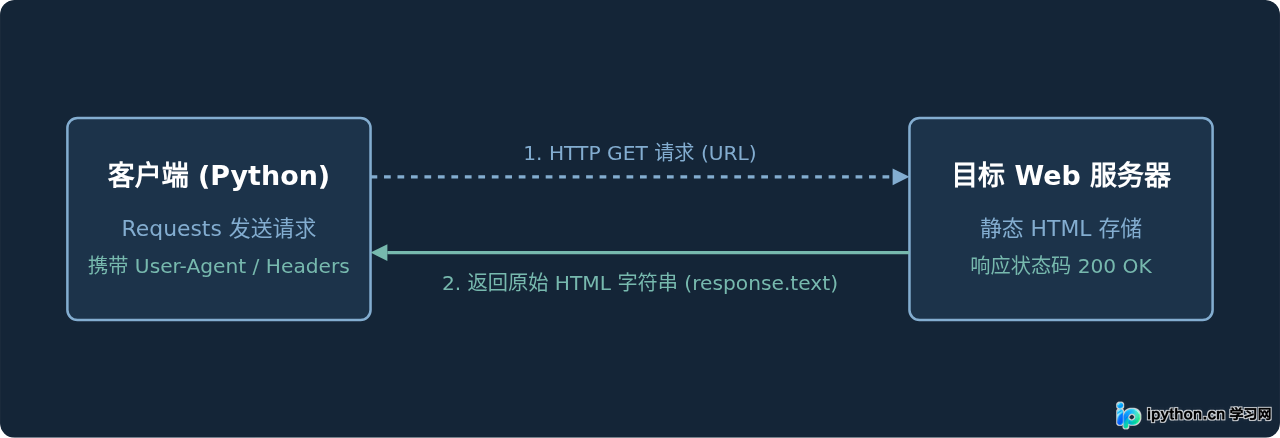
面向初学者的Python静态网页爬虫教程,系统讲解Requests网络请求与BeautifulSoup解析库的配合使用,包含环境安装、选择器提取、完整实战代码与常见问题排查。
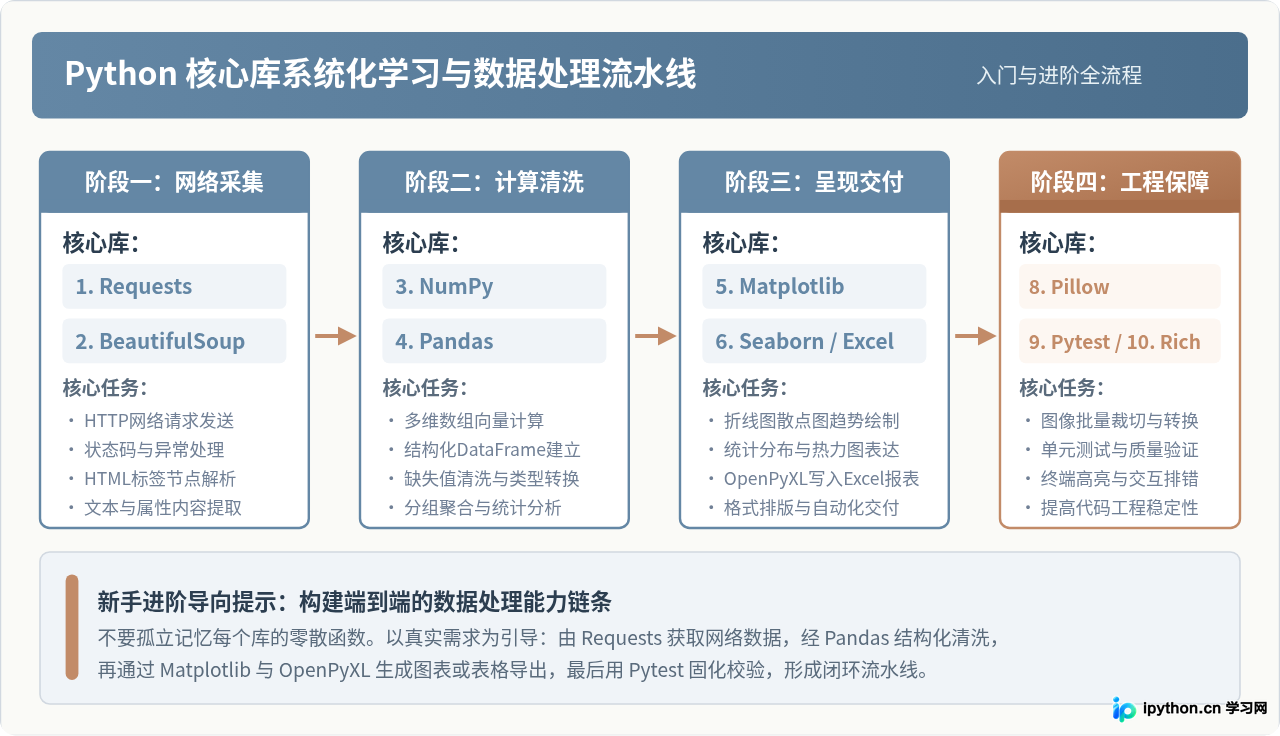
专为Python初学者梳理的10个核心第三方库入门指南,涵盖Requests、Pandas、NumPy、BeautifulSoup等高频库的适用场景、核心用法、示例代码与避坑要点。
本文详细讲解如何使用Python爬虫获取基金基本信息。针对XPath定位失效的情况,文章演示了如何利用BeautifulSoup库解析HTML页面,通过定位table和td标签提取基金公司、经理、成立时间等关键数据,并展示最终代码实现与结果输出。
本文详解Python中BeautifulSoup库的基本用法,重点介绍如何通过html.parser读取本地HTML文件。内容涵盖使用select方法结合标签名与class属性(如div下的span)进行元素定位,以及利用find方法提取特定属性值。文章通过具体代码示例展示了如何获取ResultSet类型结果,帮助开发者快速掌握网页数据抓取的核心技巧。
本文介绍如何使用Python脚本绕过上学吧网站的验证码限制,自动获取题目详情与答案。通过构造随机X-Forwarded-For头信息规避IP检测,结合requests和BeautifulSoup库下载并解析验证码图片,用户只需手动输入计算结果即可实现免验证跳转查看内容。
本文介绍使用Python获取网页源码的两种方法。首先演示利用requests库直接获取指定页面的HTML文本,并处理编码问题;其次展示结合urllib2与BeautifulSoup进行全站链接扫描的复杂示例,包括遍历页面、解析锚点、检查链接状态码及计算耗时。
本文演示如何使用Python的BeautifulSoup库解析京东网页源码。通过构造包含keyword参数的搜索URL,利用urllib.quote进行编码,并解析HTML标签树提取商品名称、链接、图片及价格。文中特别指出处理空图片链接时使用get方法的技巧,对比正则表达式展示了BeautifulSoup的便捷性。
本文介绍如何使用 Python3 结合 requests 和 BeautifulSoup 库,通过递归方式爬取指定网站下的所有 URL 链接。文章详细解析了从首页提取初始链接、遍历子页面获取新链接,以及利用递归函数处理深层页面的完整流程,并提供了完整的可运行代码示例,帮助开发者快速实现网站链接抓取功能。
本文详细解析Python中解析HTML网页的四种主流方式:正则表达式、requests-html、BeautifulSoup及lxml XPath。通过豆瓣小组页面抓取实例,对比各库在代码复杂度、执行效率及适用场景上的差异,帮助开发者根据实际需求选择最高效的数据提取工具。
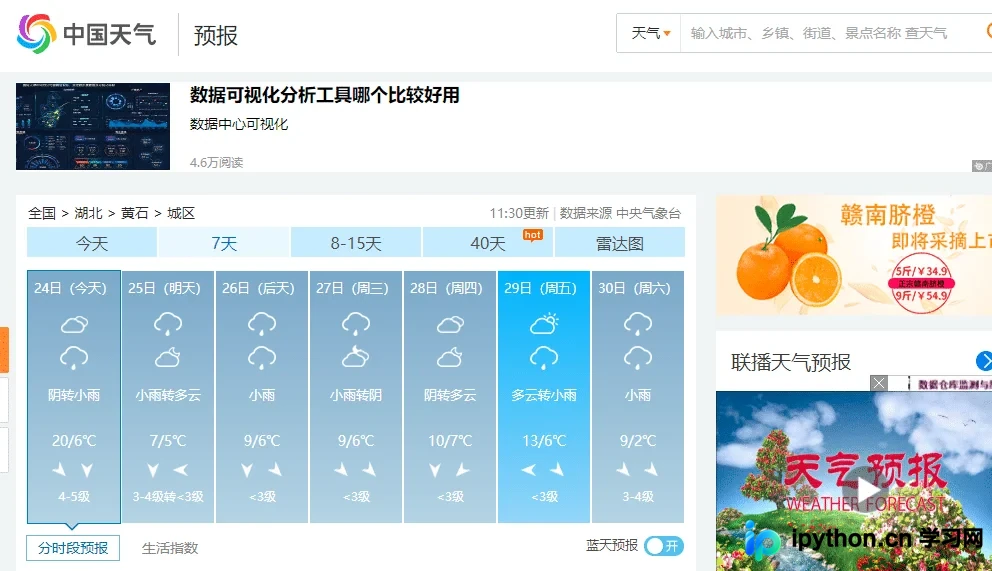
本文介绍使用Python抓取中国天气网城市近7天天气预报的完整流程。通过F12开发者工具分析HTML结构,定位日期、温度、风向等关键标签,编写Requests请求与BeautifulSoup解析代码,实现数据提取与格式化输出,并提供完整示例供参考。