

不用框架也能做:Python requests+BeautifulSoup批量保存所有网页

面对一个包含多级目录的技术文档站点、静态博客或企业官网时,许多开发者会下意识考虑使用大型抓取框架。但如果目标站点的页面由静态 HTML 构成,直接使用标准库的集合结构,配合 requests 发起网络请求并用 BeautifulSoup 解析链接,仅需数十行代码就能实现稳定、可控的全站网页批量保存。本文将详细演示如何构建这一任务执行流程,并解决相对路径拼接、同域名过滤及本地文件名映射等关键细节。
核心架构:为什么不需要重量级框架
大型爬虫框架(如 Scrapy)的优势在于分布式任务调度、多线程并发管理以及内置的中间件管道。然而,当目标仅是下载中小型文档站(数十到上千页)供离线查阅或备份归档时,框架自带的工程化配置反而增加了部署和调试成本。
批量保存全站页面的本质,是一个典型的图遍历(Graph Traversal)过程。网站中的超链接如同有向图的边,网页即是节点。我们只需要维护两个核心容器:一个用于存放待抓取 URL 的队列(To-Visit Queue),以及一个用于记录已抓取 URL 的集合(Visited Set)。
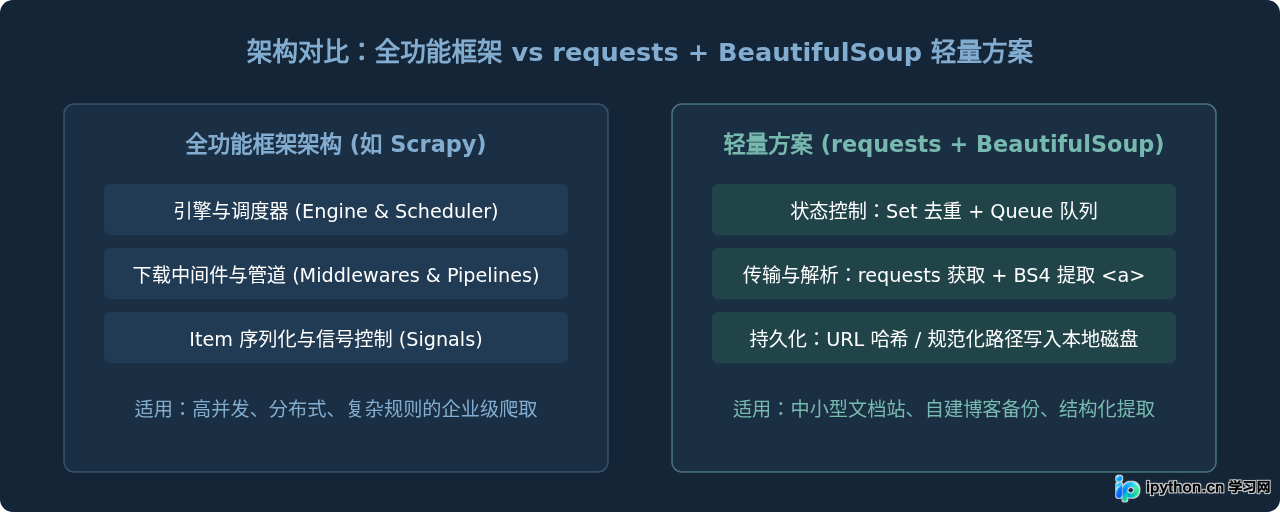
环境依赖与核心模块分配
在编写逻辑代码之前,需要准备好 Python 执行环境。本项目仅依赖两个外部库:requests(用于发送 HTTP 请求获取 HTML 内容)和 beautifulsoup4(用于解析 HTML 树结构并提取所有内嵌链接)。
pip install requests beautifulsoup4在标准库方面,我们利用 urllib.parse 中的 urljoin 与 urlparse 进行统一的 URL 拼接与域名边界判断,使用 pathlib 统一管理本地目录创建与文件写入,使用 collections.deque 作为先进先出的任务队列。
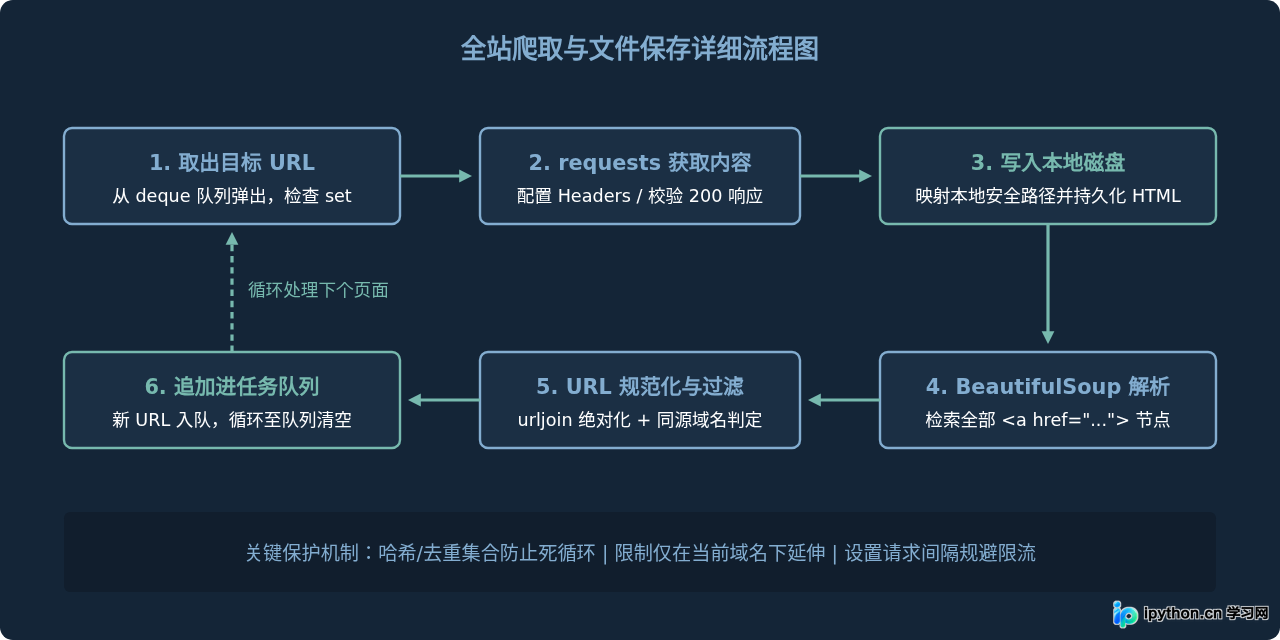
核心执行流程与阶段推演
爬取程序通过广度优先策略(BFS)运行。从初始种子页面(Seed URL)启动,经过网络拉取、文本写入、标签解析、URL 规范化、作用域过滤后,将有效子链接追加至队列末尾。此闭环不断进行,直到待访问队列被清空。
关键技术细节处理
在编写实际请求代码前,有三个逻辑细节必须提前处理妥当:
1. 相对路径与绝对路径的统一
网页源代码中的 <a href="..."> 经常出现相对地址,例如 href="/docs/setup.html" 或 href="../guide"。如果不进行转换,程序无法直接拿相对路径发起 HTTP 请求。必须使用 urllib.parse.urljoin(current_url, href),它能根据当前页面的完整 URL 计算出目标资源的绝对路径,同时自动去除 #section 这类锚点对 URL 唯一性的干扰。
2. 域名边界限定
如果不做域名检测,程序一旦抓取到外部友情链接、外链社交媒体或统计分析平台,爬取范围就会迅速失控扩散。因此,在将新提取的 URL 加入队列前,必须校验其 netloc(主机名)是否与初始站点的 netloc 完全一致。
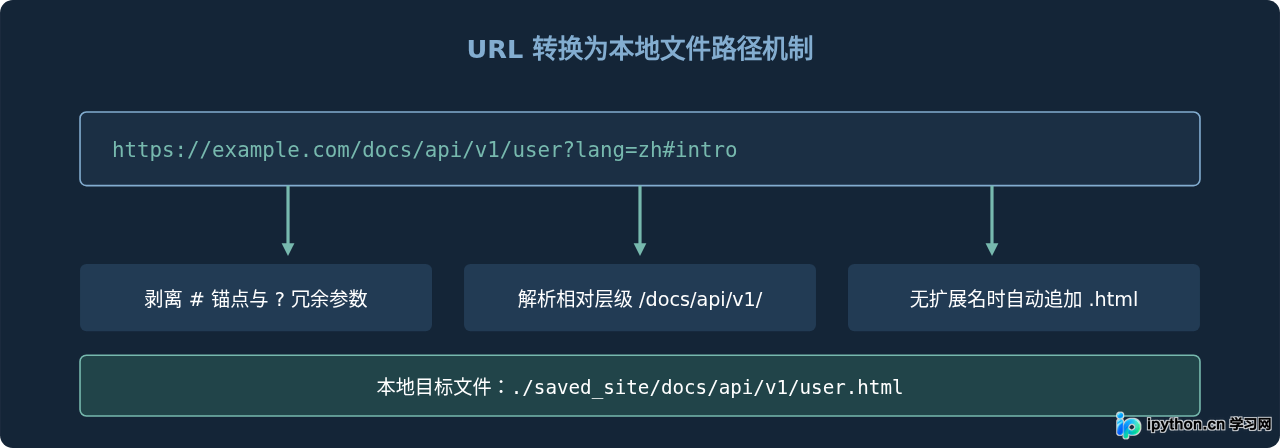
3. 本地存储路径安全映射
不同系统的操作系统对文件名有不同字符限制,且路径中包含的查询参数(Query String)可能携带 ?、&、: 等非法字符。一种高可靠的做法是将 URL 进行 SHA256 哈希作为文件名;另一种便于查看的做法是将 URL 路径拆解为本地目录层级。为了兼顾可读性与防错,本文代码采用“安全路径规范化”策略:如果 URL 以目录结尾,则自动落盘为 index.html。
完整实现代码
以下是开箱即用的完整脚本。我们将所有逻辑封装在清晰的函数与执行流中,并增加了友好的终端进度打印与防封延迟。
import os
import time
import requests
from collections import deque
from urllib.parse import urlparse, urljoin, urldefrag
from bs4 import BeautifulSoup
from pathlib import Path

def url_to_local_path(url: str, base_dir: Path) -> Path:
    """
    将 URL 路径映射为规范的本地磁盘文件路径
    """
    parsed = urlparse(url)
    path = parsed.path.strip("/")

    # 首页或以斜杠结尾的情况
    if not path or path.endswith("/"):
        sub_path = Path(path) / "index.html"
    elif not os.path.splitext(path)[1]:
        # 如果 URL 末尾没有扩展名,如 /about,映射为 /about.html
        sub_path = Path(f"{path}.html")
    else:
        # 已有扩展名,如 /style.css、/intro.html
        sub_path = Path(path)

    full_path = base_dir / sub_path
    return full_path

def crawl_and_save_site(start_url: str, output_directory: str = "downloaded_site", delay: float = 0.5):
    """
    无框架批量保存站点网页主函数
    :param start_url: 抓取入口 URL (例如 https://example.com)
    :param output_directory: 本地存储的根目录名
    :param delay: 每个请求之间的休眠时间(秒),防止对服务器造成压力
    """
    # 规范化入口 URL
    start_url, _ = urldefrag(start_url)
    parsed_start = urlparse(start_url)
    target_domain = parsed_start.netloc

    if not target_domain:
        print("[错误] 请提供包含协议前缀的完整 URL,如: http:// 或 https://")
        return

    base_dir = Path(output_directory)
    base_dir.mkdir(parents=True, exist_ok=True)

    # 队列与已访问集合
    queue = deque([start_url])
    visited = set([start_url])

    # 配置统一的请求会话
    session = requests.Session()
    session.headers.update({
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/118.0.0.0 Safari/537.36"
    })

    success_count = 0
    fail_count = 0

    print(f"[*] 开始抓取目标站点: {start_url}")
    print(f"[*] 限定目标域名: {target_domain}")
    print(f"[*] 输出存储路径: {base_dir.resolve()}\n")

    while queue:
        current_url = queue.popleft()
        print(f"[FETCH] 正在获取: {current_url}")

        try:
            response = session.get(current_url, timeout=10)

            # 仅处理成功响应且内容为 HTML 的网页
            content_type = response.headers.get("Content-Type", "").lower()
            if response.status_code != 200:
                print(f"  [-] 状态码非 200 ({response.status_code}),跳过")
                fail_count += 1
                continue

            if "text/html" not in content_type:
                print(f"  [-] 非 HTML 文本资源 ({content_type}),跳过")
                continue

            # 1. 保存当前网页源码至本地
            local_file_path = url_to_local_path(current_url, base_dir)
            local_file_path.parent.mkdir(parents=True, exist_ok=True)

            # 确保使用 UTF-8 编码写入文件
            with open(local_file_path, "w", encoding="utf-8") as f:
                f.write(response.text)

            success_count += 1
            print(f"  [SAVED] 成功保存到 -> {local_file_path.relative_to(base_dir)}")

            # 2. 用 BeautifulSoup 提取页面所有子链接
            soup = BeautifulSoup(response.text, "html.parser")
            links_found = 0

            for a_tag in soup.find_all("a", href=True):
                raw_href = a_tag["href"].strip()

                # 忽略 javascript:伪协议、邮件链接和空链接
                if not raw_href or raw_href.startswith(("javascript:", "mailto:", "tel:")):
                    continue

                # 转换相对路径并去除 # 锚点
                absolute_url = urljoin(current_url, raw_href)
                clean_url, _ = urldefrag(absolute_url)

                parsed_link = urlparse(clean_url)

                # 仅保留相同域名且为 http/https 协议的链接
                if parsed_link.netloc == target_domain and parsed_link.scheme in ("http", "https"):
                    if clean_url not in visited:
                        visited.add(clean_url)
                        queue.append(clean_url)
                        links_found += 1

            print(f"  [QUEUE] 本页发现新有效链接: {links_found} 条,当前排队待抓取: {len(queue)}")

        except requests.RequestException as e:
            print(f"  [ERROR] 网络请求失败: {e}")
            fail_count += 1
        except IOError as e:
            print(f"  [ERROR] 本地写入失败: {e}")
            fail_count += 1

        # 友善的延迟,避免过快访问被封禁
        if queue:
            time.sleep(delay)

    print("\n" + "=" * 40)
    print(f"抓取任务结束!")
    print(f"成功保存: {success_count} 个页面")
    print(f"失败跳过: {fail_count} 个页面")
    print(f"已遍历总链接数: {len(visited)}")
    print(f"本地文件保存在: {base_dir.resolve()}")
    print("=" * 40)

if __name__ == "__main__":
    # 使用时替换为需要备份或离线保存的目标站点首页
    TARGET_SITE = "http://books.toscrape.com/"
    crawl_and_save_site(start_url=TARGET_SITE, output_directory="my_offline_site", delay=0.3)
time.sleep(delay)。在抓取实际站点时,请务必根据目标站点的承载能力设置合理的抓取间隔(建议 0.5 秒以上),切勿发起恶意高并发请求。
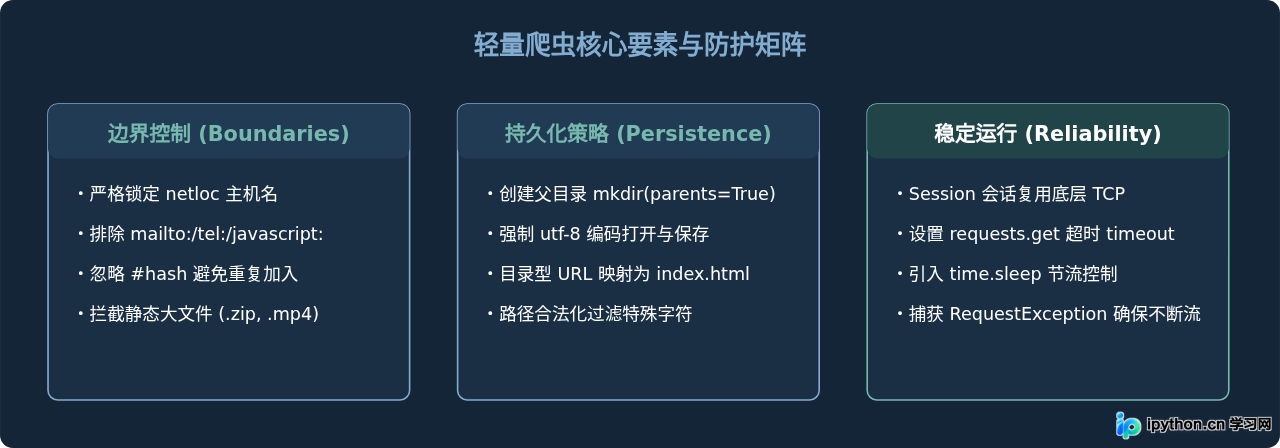
核心运行状态与防御细节总结
在编写自定义抓取脚本时,读者通常会遇到诸如链接成环、动态资源丢失、乱码等问题。以下将针对最核心的防御逻辑进行梳理总结:
局限性与适用边界
虽然通过 requests + BeautifulSoup 能以极低成本快速下载全站,但读者在实际使用中需明确本方案的适用范围:
- 单页应用(SPA)与客户端渲染:本方案直接读取服务端返回的初始 HTML 文本。如果目标网站依赖 Vue、React 等前端框架通过 Ajax 异步拉取数据并渲染 DOM,
requests获取到的源码中可能仅包含骨架容器,无法获取动态生成的链接。此场景需要考虑具备浏览器驱动能力的方案。 - 内联静态资源离线化:上述脚本只保存了 HTML 页面本身。打开本地 HTML 时,CSS、JavaScript 和图片依然指向线上远程地址。若需要实现 100% 离线可用,还需在 BeautifulSoup 解析时额外查找
<img src>、<link rel="stylesheet">与<script src>,并将静态资产一同下载,同时将 HTML 中的链接替换为本地相对路径。 - 站点规模上限:由于本方案在单进程内维护内存集合,且采用单线程线性抓取,适合抓取几百至上千个页面的中小型站点。对于数十万级页面的大型门户,框架的多线程与持久化队列机制才具有明显优势。
掌握这套基于 requests 和 BeautifulSoup 的轻量实现,不仅能满足绝大多数日常文档与文章的本地归档需求,也能帮助开发者深入理解网页链接的网状拓扑关系与爬虫底层的数据流动本质。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









