

Python爬虫实战:利用BeautifulSoup进行数据解析与持久化

发布时间:2026-10-11| 2人浏览过
本文详解Python爬虫中BeautifulSoup库的数据解析流程。从环境安装、对象实例化到标签定位(find/select)、文本提取及属性获取,结合三国演义小说爬取案例,演示如何解析列表页与详情页,实现指定内容的持久化存储。
数据解析基础与流程
在爬虫开发中,聚焦爬虫旨在获取页面中特定的内容。其标准执行流程包含五个环节:指定目标URL、发起网络请求、获取服务器响应、进行数据解析以及将结果持久化存储。数据解析的核心原理在于定位局部文本,这些文本通常存储在HTML标签内部或其属性中。
常见的解析技术包括正则表达式、XPath以及BeautifulSoup(bs4)。其中,bs4通过实例化对象并加载源码,利用对象属性或方法定位标签并提取数据,具有代码可读性强的特点。
环境配置与对象加载
使用前需安装依赖库。推荐使用清华源加速安装:
pip install bs4 -i https://pypi.tuna.tsinghua.edu.cn/simple
pip install lxml -i https://pypi.tuna.tsinghua.edu.cn/simple
BeautifulSoup对象加载源码主要有两种方式:
- 本地文件加载:打开HTML文件并指定编码,传入解析器。
fp = open('./test.html', 'r', encoding='utf-8')
soup = BeautifulSoup(fp, 'lxml')- 网页源码加载:获取响应文本后直接加载。
page_text = response.text
soup = BeautifulSoup(page_text, 'lxml')
标签定位与数据提取
实例化对象后,可通过以下方法提取数据:
- 基本定位:
soup.tagName返回文档中第一次出现的对应标签;soup.find('tagName')功能等同,但支持更多参数。 - 属性过滤:通过指定属性值进一步定位,例如
soup.find('div', class_='song')。 - 批量获取:
soup.find_all('tagName')返回符合要求的标签列表。 - CSS选择器:
soup.select('选择器')返回匹配的选择器列表。其中>表示直接子节点(一个层级),空格表示后代节点(多个层级)。
文本与属性获取
获取标签内容时需注意区别:soup.a.text 或 get_text() 获取标签内所有文本;soup.a.string 仅获取直系文本。获取属性值使用字典语法,如 soup.a['href']。
实战:三国演义章节爬取
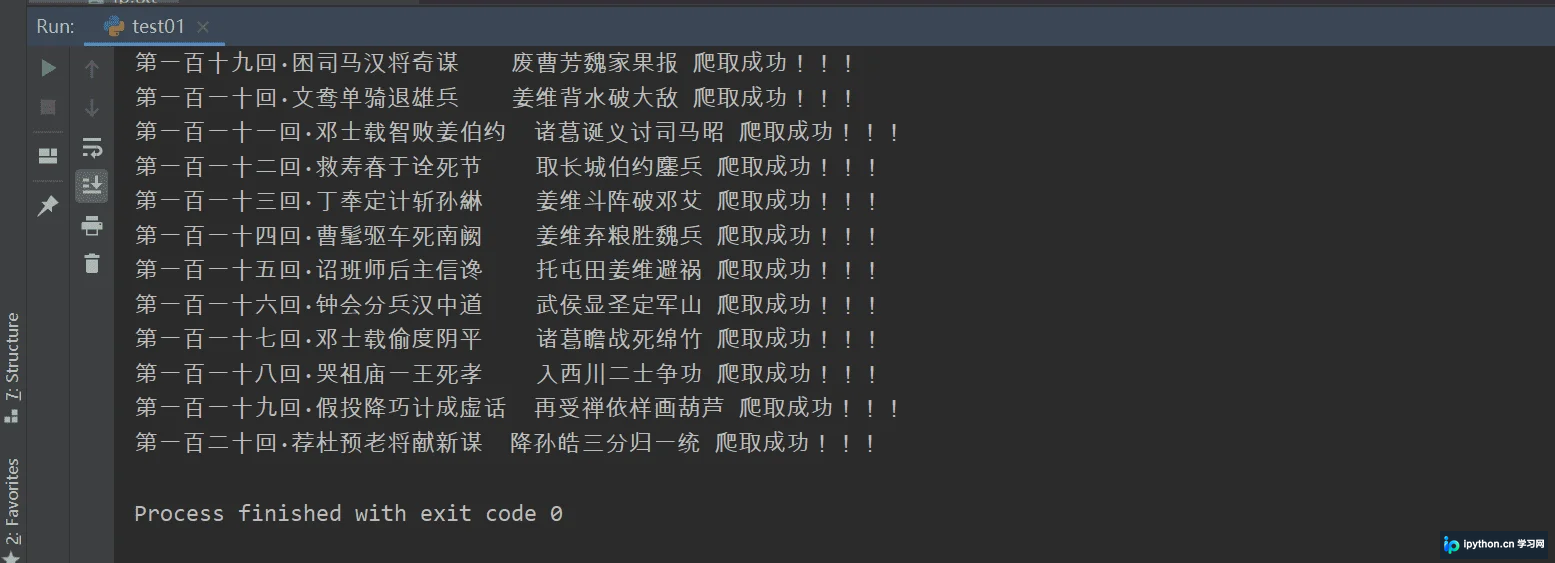
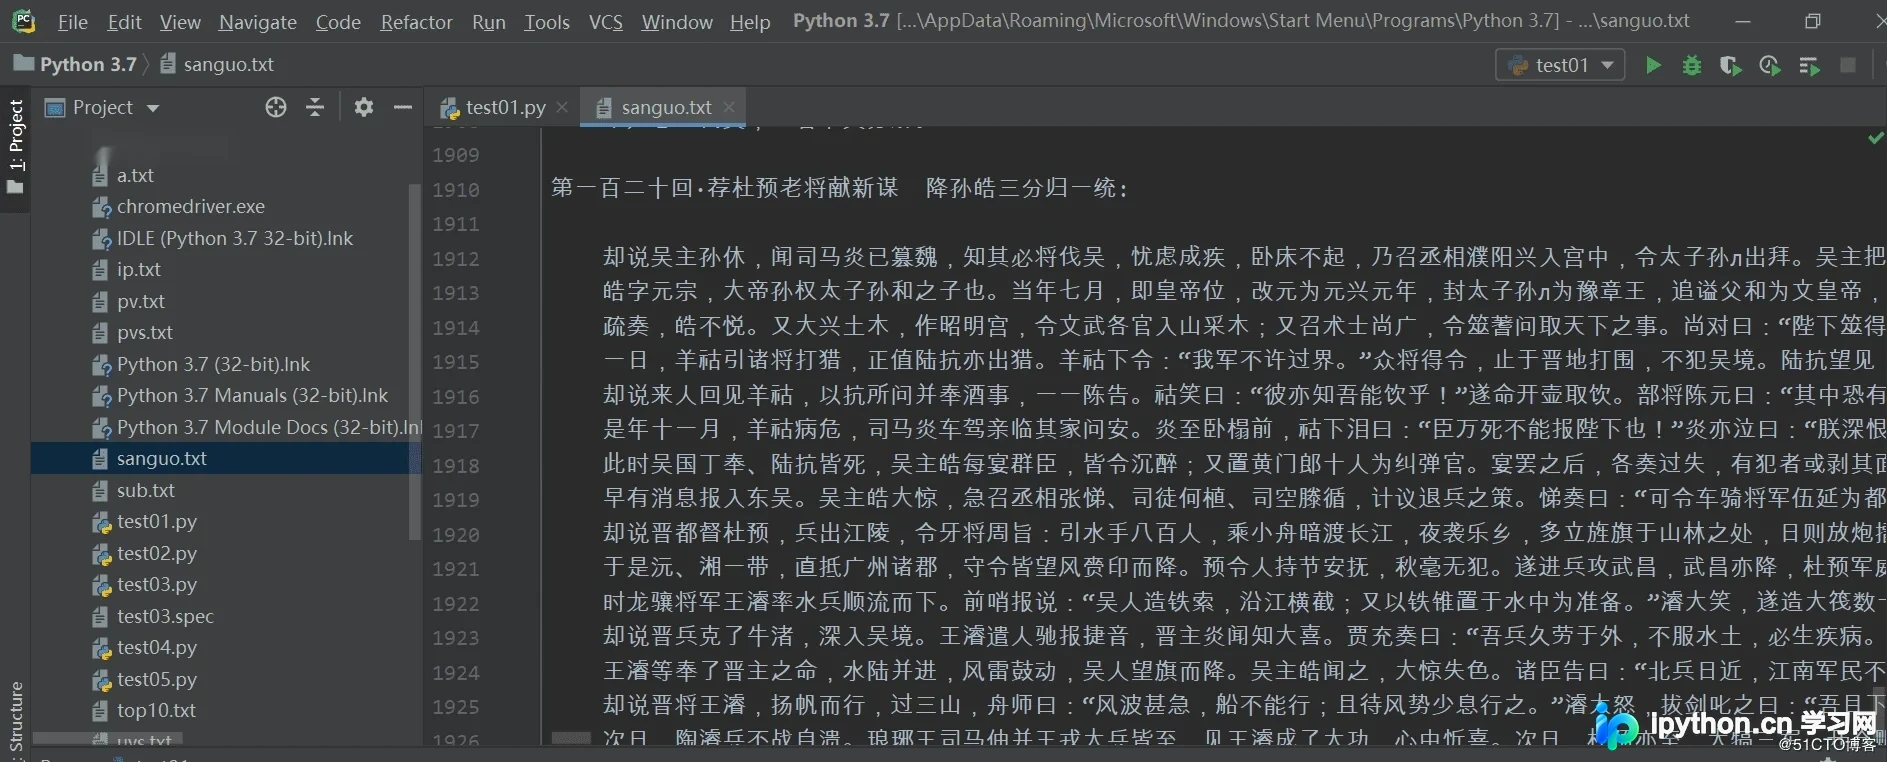
以下代码演示如何解析列表页获取章节标题与链接,并进一步请求详情页提取正文内容,最终保存为文本文件。
import requests
from bs4 import BeautifulSoup

if __name__ == "__main__":
    # 1. 设置请求头模拟浏览器
    headers = {
        'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_0) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.121 Safari/537.36'
    }
    url = 'http://www.shicimingju.com/book/sanguoyanyi.html'

    # 2. 获取首页源码
    page_text = requests.get(url=url, headers=headers).text

    # 3. 实例化对象并解析列表
    soup = BeautifulSoup(page_text, 'lxml')
    # 使用CSS选择器定位章节列表
    li_list = soup.select('.book-mulu > ul > li')

    # 4. 持久化存储
    with open('./sanguo.txt', 'w', encoding='utf-8') as fp:
        for li in li_list:
            title = li.a.string
            detail_url = 'http://www.shicimingju.com' + li.a['href']

            # 5. 请求详情页并解析内容
            detail_page_text = requests.get(url=detail_url, headers=headers).text
            detail_soup = BeautifulSoup(detail_page_text, 'lxml')

            # 定位内容区域并提取文本
            div_tag = detail_soup.find('div', class_='chapter_content')
            content = div_tag.text

            # 写入文件
            fp.write(title + ':' + content + '\n')
            print(title, '爬取成功!!!')
该示例展示了从列表页解析链接到详情页提取正文的完整闭环。注意在写入文件时使用 with 语句可自动管理资源关闭,比手动 open 更安全。
以上就是Python爬虫使用BeautifulSoup进行数据解析的详细内容,更多关于Python爬虫技术与实战的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









