

Python爬虫选Scrapy还是requests+BS4?初学者框架选型建议

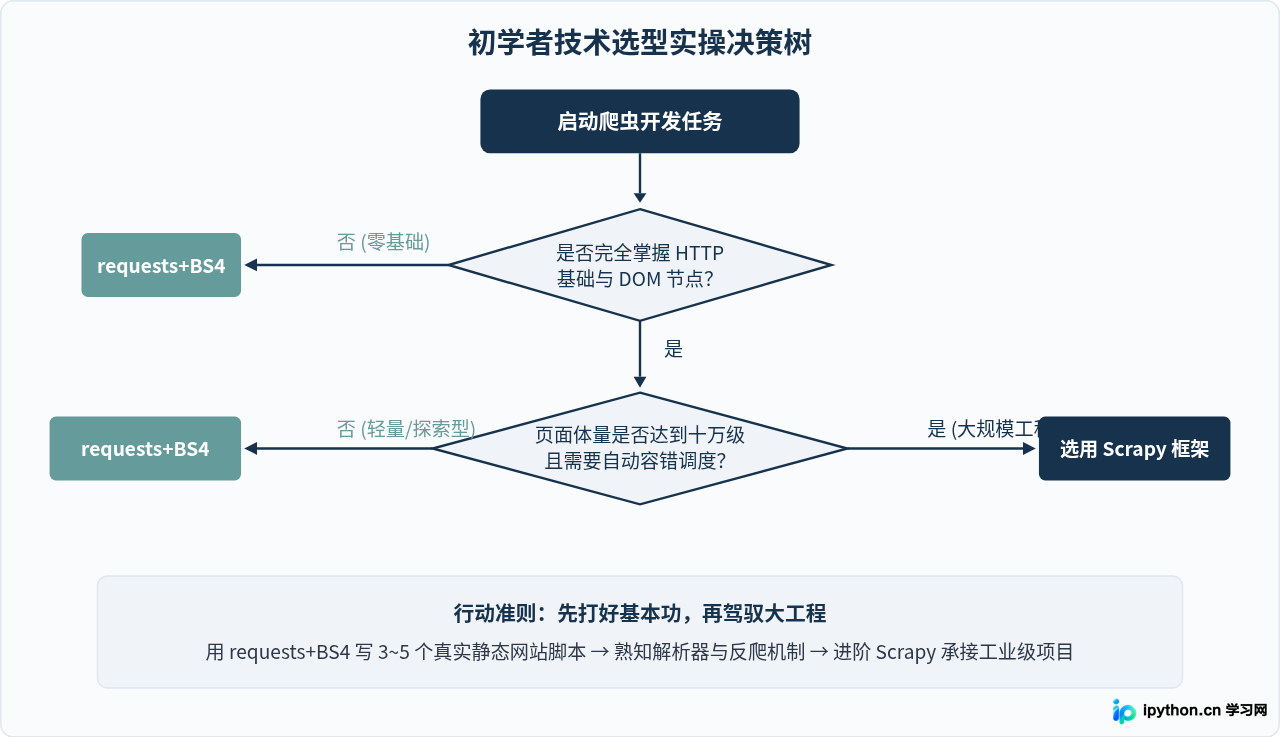
对于刚刚接触 Python 爬虫的初学者,直接给出的明确建议是:优先选择 requests + BeautifulSoup4(简称 BS4)作为入门起步方案;当面对数十万级大规模抓取、需要自动化并发调度与断点续爬,或者构建企业级规范数据管道时,再转向学习 Scrapy。 爬虫技术的核心并不在于直接操作庞大复杂的集成框架,而在于扎实掌握网络协议、HTML 节点解析与反爬对抗机制。循序渐进的技术路线不仅能显著降低挫败感,还能让后续的框架进阶更为自然。
一、为什么初学者容易面临选型困惑?
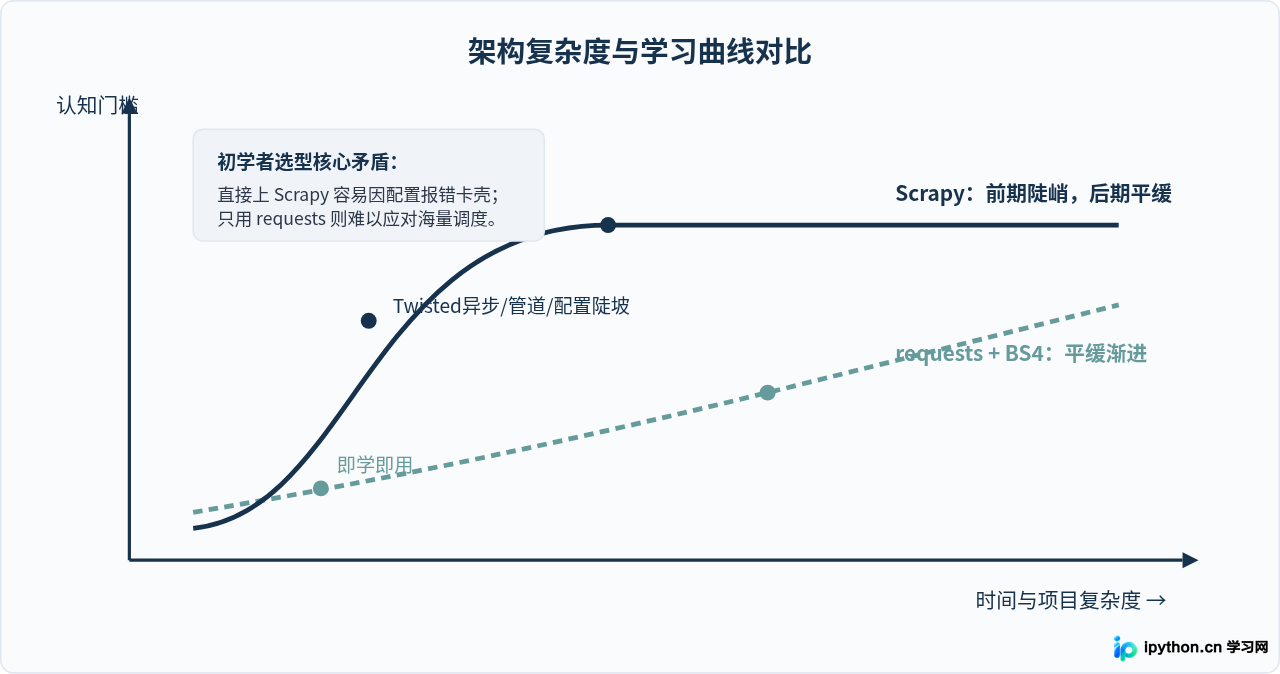
很多初学者在搜索“Python 爬虫教程”时,常会看到两种截然不同的声音:一种强调 requests 和 BS4 代码简单、几行就能抓取网页;另一种则极力推崇 Scrapy 的强大、异步高并发与工程化架构。初学者容易误以为必须一次性选对“终极工具”,甚至担心学习轻量级库会浪费时间。
实际上,这两个方案并非水火不容的替代品,而是处于爬虫技术栈不同阶段的工具组合。requests 负责底层的 HTTP 通信,BS4 负责网页文本的结构化解析,两者组合提供的是精简直观的“请求-解析”体验;而 Scrapy 则是一个全功能的爬虫引擎,内置了调度器、下载器、管道及中间件机制。理清两者的根本定位差异,是做出明智选择的第一步。
二、核心方案深度拆解与工作机制
1. requests + BeautifulSoup4:轻量级组合拳
requests 是 Python 最受欢迎的 HTTP 客户端库,设计极其贴合人类直觉;BeautifulSoup4 则专门用于从 HTML 或 XML 文件中提取数据。这个组合将“网络通信”与“文档解析”清晰解耦:
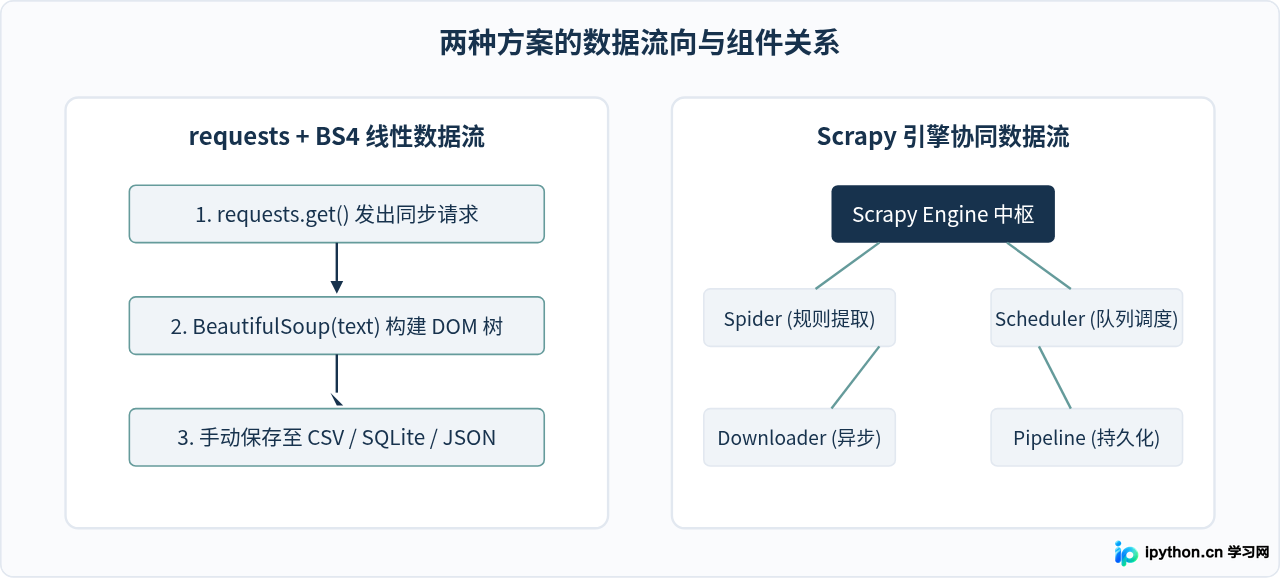
- 职责单一明晰: requests 负责建立 TCP 连接、发送请求头、携带 Cookie 及接收响应;BS4 负责构建 DOM 树,通过 CSS 选择器或标签查找提取所需字段。
- 极佳的调试体验: 遇到问题时,可以随时在终端打印
response.text或在交互式环境中逐行测试提取规则,无需处理后台引擎或异步回调。
# requests + BS4 典型示例代码
import requests
from bs4 import BeautifulSoup

url = "https://example.com/books"
headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}

# 步骤 1:发送网络请求
response = requests.get(url, headers=headers)

if response.status_code == 200:
    # 步骤 2:解析 HTML 树结构
    soup = BeautifulSoup(response.text, "html.parser")
    # 步骤 3:提取目标元素
    titles = [item.get_text(strip=True) for item in soup.select("h2.book-title")]
    print(f"成功抓取图书标题: {titles}")
else:
    print(f"请求失败,状态码: {response.status_code}")
2. Scrapy:工业级异步爬虫框架
Scrapy 并不是一个单纯的工具库,而是一套完整的工程框架。它基于 Twisted 异步网络引擎构建,为大规模爬取提供了完整的标准化流程支持:
- 内置组件体系: 包含 Spider(页面抓取逻辑)、Engine(控制流中枢)、Scheduler(请求队列与去重)、Downloader(高速异步下载器)、Item Pipeline(数据清洗与存储)、Downloader/Spider Middlewares(请求与响应拦截钩子)。
- 原生高并发与去重: 原生支持基于请求指纹的 URL 去重机制、自动并发请求控制、自动限速扩展与断点续爬功能。
三、全方位维度对比与技术选型权衡
为了更清晰地对比二者的实际差异,下表从初学者最常关注的核心维度进行了归纳:
| 评估维度 | requests + BeautifulSoup4 | Scrapy 框架 |
|---|---|---|
| 学习曲线 | 非常平缓,只需掌握基础 Python 语法与 HTML 结构。 | 较陡峭,需理解面向对象、异步回调、配置文件与命令行工具。 |
| 代码组织 | 单脚本文件即可执行,自由度高但缺乏强制工程约束。 | 标准工程目录(settings、spiders、items、pipelines)。 |
| 运行效率 | 单线程同步阻塞,处理小规模页面足够;多并发需自建。 | 基于 Twisted 事件循环异步非阻塞,并发性能极强。 |
| 内置功能 | 仅提供基础请求与解析,去重、重试、持久化需手写代码。 | 高度开箱即用,自带去重、请求队列、并发限速、中间件扩展。 |
| 调试排错 | 极其直观,可逐行 print 输出或打断点单步调试。 | 需通过 Scrapy Shell、日志系统或特定挂钩调试,排查相对复杂。 |
| 典型适用规模 | 单页、数十页至数千页的临时、探索型或轻量抓取任务。 | 十万级以上大型数据采集、周期性增量监控与企业级数据项目。 |
scrapy startproject,结果被 items.py、middlewares.py、pipelines.py 等一堆生成文件吓退,甚至因 Twisted 在特定操作系统上的编译问题卡住整整一天。这就是过早引入重型框架造成的阻力。
四、初学者的实操选型建议与演进流程
做选型决策时,不应盲目追求框架的高大上,而应严格依据当前的项目需求与自身技能阶段匹配。以下决策操作流程展示了如何判断何时使用哪个工具:
五、阶段总结与初学者进阶路线图
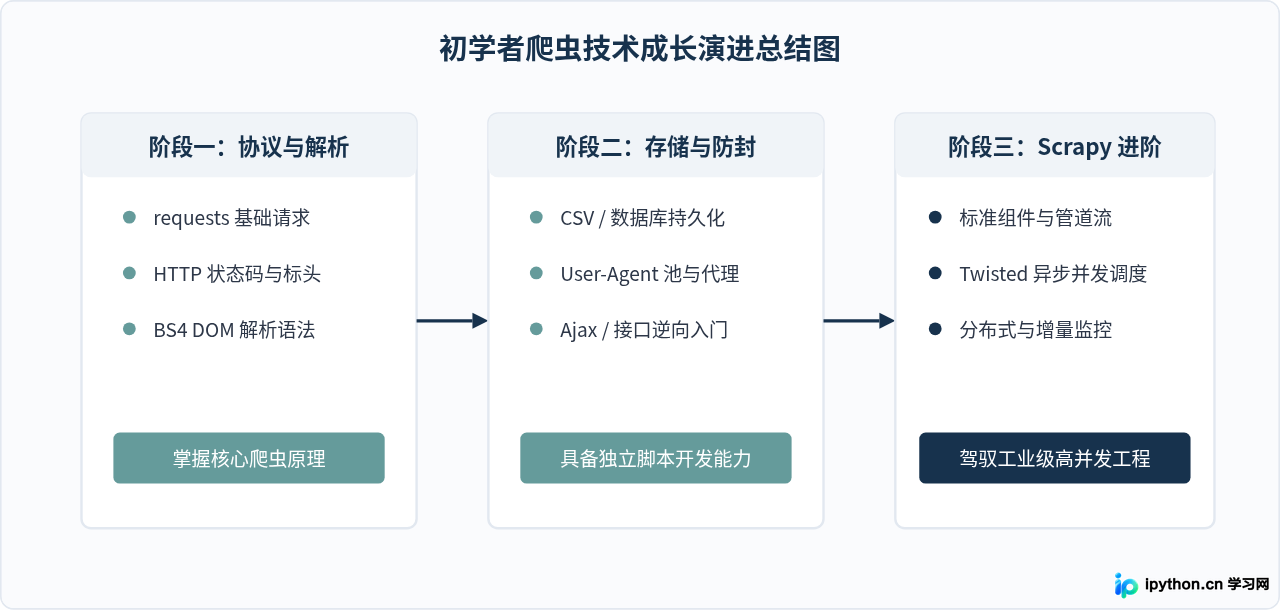
技术选型没有绝对的优劣,只有与当下阶段相匹配的合适工具。作为初学者,建议将爬虫技术的学习分为清晰的三个阶段:
- 阶段一:夯实网络基础与解析能力(1~2 周)
专注于requests发起 GET/POST 请求,理解 Headers、User-Agent、Cookie、Referer 的含义。使用BeautifulSoup4练习使用find()、find_all()与 CSS 选择器提取文本和链接。这一阶段的目标是“能把单页目标数据精准抓取并打印出来”。 - 阶段二:处理数据存储与基础反爬(1~2 周)
为你的 requests 脚本增加数据持久化功能,例如输出为本地 JSON、CSV 文件或存入 SQLite。在此过程中学习处理编码异常、网络超时(timeout)、设置重试逻辑,以及分析现代网页常见的 Ajax 异步 JSON 接口。 - 阶段三:系统性学习 Scrapy 工程化开发
当编写的 requests 脚本开始需要处理多级列表翻页、由于速度慢而考虑引入多线程,或者发现重复抓取 URL 导致逻辑复杂时,正是转入 Scrapy 的最佳时机。此时你已经清楚了解爬虫的各个环节,再看 Scrapy 的架构设计,就会对其内部运作一目了然。
总之,不要在初学阶段为选择 Scrapy 还是 requests+BS4 过度纠结。拿起 requests 和 BeautifulSoup4,找一个公开静态网站写出你的第一行数据抓取代码;当你遇到无法突破的性能瓶颈或工程规模要求时,Scrapy 的强大价值便会水到渠成地呈现在你面前。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









