

Python爬虫入门:用requests和BeautifulSoup写第一个爬虫

发布时间:2026-10-11| 5人浏览过
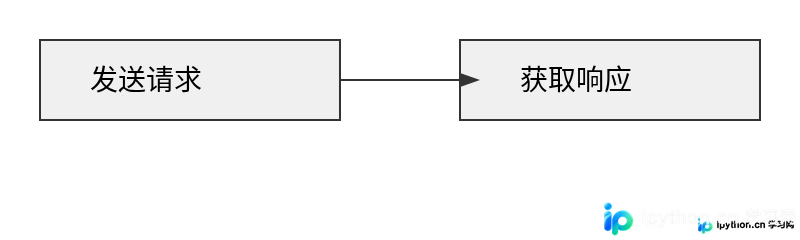
在本教程中,你将学习如何使用 Python 的 requests 库发送 HTTP 请求,结合 BeautifulSoup 解析网页内容,快速实现一个简单的爬虫。
准备工作
确保已安装以下库:
pip install requests beautifulsoup4完整代码示例
import requests
from bs4 import BeautifulSoup

url = 'https://example.com'
response = requests.get(url)
response.raise_for_status()

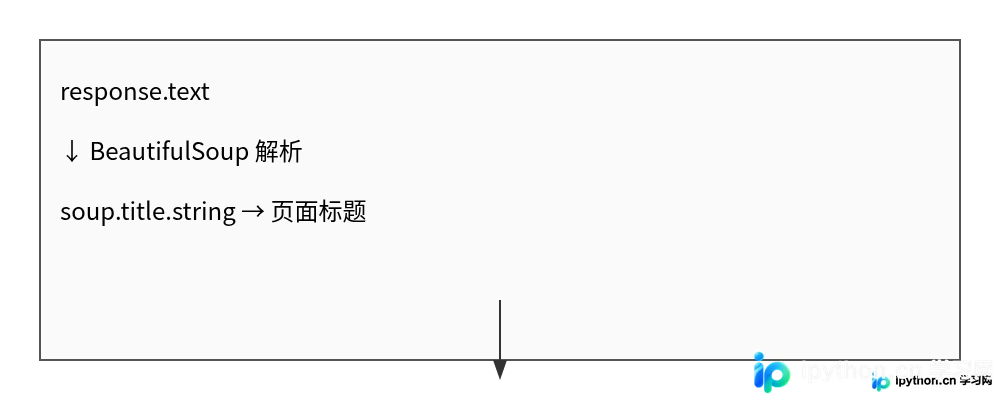
soup = BeautifulSoup(response.text, 'html.parser')
title = soup.title.string
print(f'页面标题:{title}')
解析页面内容
使用 BeautifulSoup 可以方便地获取页面中的元素,例如标题、链接等。
常见问题
- 如何处理分页?使用循环请求不同的 URL。
- 如何规避反爬虫机制?加入适当的请求头和延时。
总结
通过上述步骤,你已经成功编写了一个基本的爬虫,能够获取网页标题并打印出来。后续可以根据需求扩展爬取更多内容、处理分页或保存数据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









