
Python使用BeautifulSoup和Requests爬取网页表格数据实战
本文详细介绍如何利用Python的Requests库获取网页源码,并结合BeautifulSoup解析HTML结构以提取表格数据。通过定义检查链接、获取内容及保存文件三个核心函数,实现将网页中的表格信息清洗后写入本地CSV文件的完整流程,适合初学者参考学习。
2026-10-13
3


本文详细介绍如何利用Python的Requests库获取网页源码,并结合BeautifulSoup解析HTML结构以提取表格数据。通过定义检查链接、获取内容及保存文件三个核心函数,实现将网页中的表格信息清洗后写入本地CSV文件的完整流程,适合初学者参考学习。
本文介绍使用Python爬取最好大学网大学排名的具体代码。通过requests获取HTML,利用BeautifulSoup解析表格数据,并将排名、学校名称及总分等信息格式化输出,供学习者参考。
本文介绍使用Python抓取多页天涯论坛帖子的实战技巧。重点解析BeautifulSoup中find_all与select的选择器差异,演示如何利用zip函数合并作者与内容数据,并构建双层URL结构实现分页抓取,同时探讨多属性筛选的可行性。
本文分享使用Python抓取网络小说的完整代码与思路。针对网页编码(如GBK与gb18030)导致的解码错误提供解决方案,利用BeautifulSoup提取标题、正文及下一章链接,实现自动循环抓取。代码包含主函数、URL解析及文件写入逻辑,最终生成适合Kindle导入的TXT文本,并建议配合epubBuilder进行二次排版以优化阅读体验。
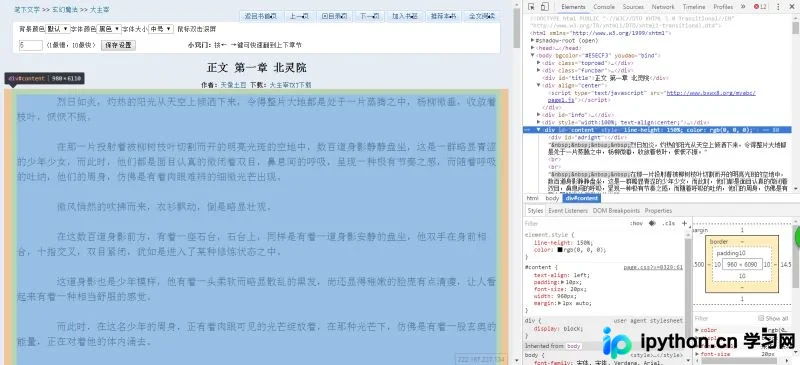
本文提供使用Python抓取网页中静态图片的完整代码示例。通过BeautifulSoup解析HTML结构,利用urllib库发起网络请求,筛选特定class的图片标签并批量下载保存。代码包含图片地址提取、文件写入及简单的延时控制,适合Python初学者参考学习网页数据抓取技术。
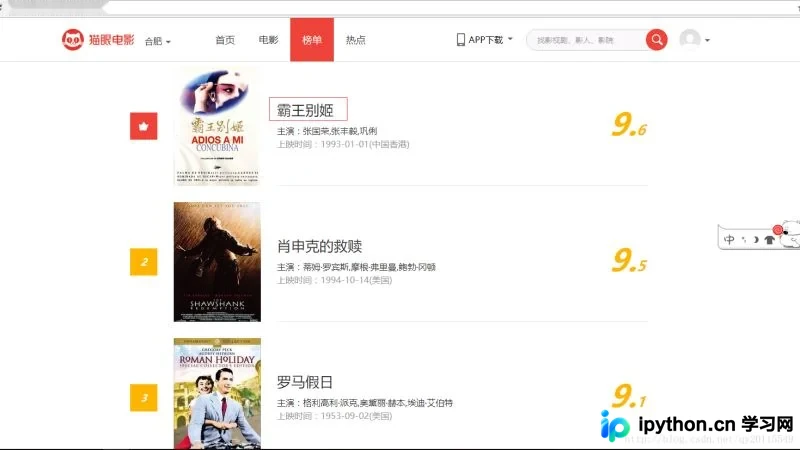
本文详细介绍如何使用Python的requests模块发起HTTP请求获取HTML源码,并结合BeautifulSoup库解析网页结构。通过抓取猫眼电影Top100榜单的具体案例,演示安装依赖、构造请求及提取电影标题与链接的完整流程,提供可直接运行的代码示例。
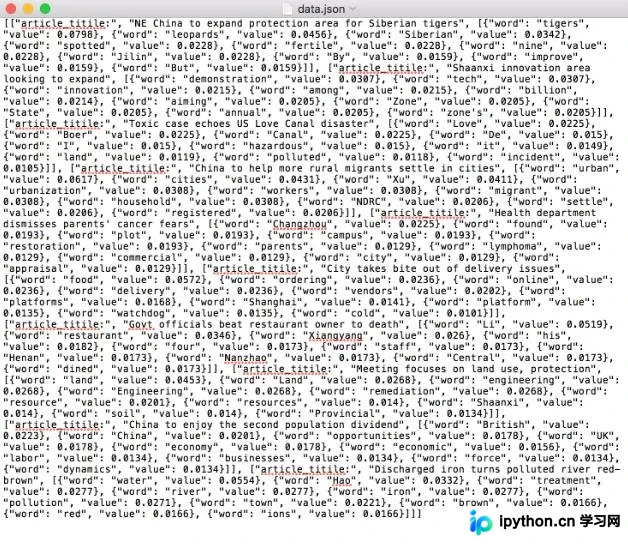
本文介绍如何使用Python编写爬虫程序,从ChinaDaily抓取十篇新闻文章。通过BeautifulSoup解析HTML获取标题与正文,结合TF-IDF算法计算每篇文章的高频关键词。最终将结果以JSON格式保存,并提供在线查看工具及GitHub源码链接,适合初学者学习网络抓取与文本分析基础。
本文详解使用Python标准库urllib和第三方库BeautifulSoup4构建简易Web爬虫的方法。文章涵盖爬虫核心流程、URL管理器、HTML下载器与解析器、索引构建及主程序逻辑,通过具体代码示例展示如何抓取网页标题并建立关键词索引,适合Python初学者理解爬虫原理。
本文基于Python2环境,详细演示如何利用urllib库下载指定URL的单张图片,并结合BeautifulSoup解析HTML结构,批量获取网页中所有图片链接并保存至本地。教程涵盖环境配置、代码实现及结果验证,适合Python初学者快速掌握网络爬虫基础技能。
本文详细演示了使用Python进行数据抓取与分析的完整流程。通过requests获取页面,利用BeautifulSoup和XPath解析HTML及JS动态数据,并将结果存入MongoDB。文章涵盖分类网址获取、产品详情页抓取、数据清洗入库及异常处理等核心步骤,提供具体代码实现供参考。
本文介绍如何利用Python编写网络爬虫程序,自动抓取万维网上的电商售卖信息。通过示例代码展示如何使用Requests发起HTTP请求,并结合BeautifulSoup解析HTML页面结构,提取商品标题、价格、发布时间及地区等关键字段。该示例以58同城电脑售卖信息为对象,演示了URL列表获取与详情页数据提取的基本流程,旨在帮助开发者掌握基础的数据爬取技巧。
本文详细介绍利用Python进行数据抓取的完整流程,涵盖分类网址获取、产品链接识别及详情解析。通过requests发起请求,结合BeautifulSoup与XPath处理HTML及JS动态数据,最终将结构化信息存入MongoDB数据库。文中提供了关键代码逻辑与异常处理机制,帮助开发者实现高效的数据采集与持久化存储。