

Python实现网页抓取与jieba分词处理

本文介绍如何使用Python的requests和BeautifulSoup库抓取指定网页的正文内容,并利用jieba库对提取的文本进行分词处理。通过具体代码示例,展示了从获取HTML、解析DOM、提取文本到写入文件及分词输出的完整流程,适用于简单的网页内容分析与预处理场景。
实现原理与步骤
该功能主要依赖三个核心组件:网络请求库 requests、HTML解析库 BeautifulSoup 以及中文分词工具 jieba。整体流程分为网页内容获取、正文提取、本地存储和分词处理四个阶段。
1. 获取网页内容
首先使用 requests.get() 向目标URL发起GET请求。由于部分网页编码可能不一致,需显式设置 res.encoding = 'utf-8' 以确保后续文本处理正常。获取到的原始HTML字符串存储在 content 变量中。
2. 解析并提取正文
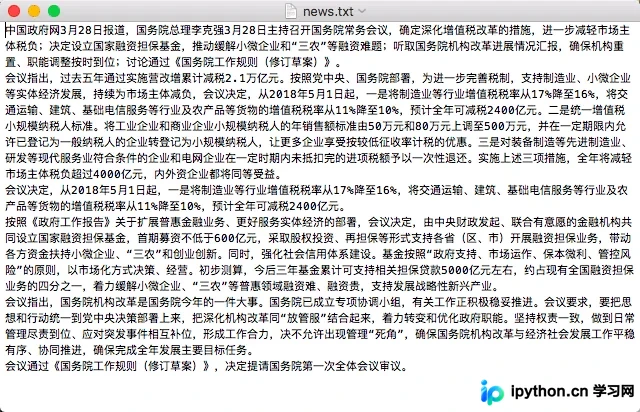
利用 BeautifulSoup 将HTML字符串解析为文档对象模型(DOM)。通过 soup.find(id='main_content') 定位到包含正文的特定 div 节点。遍历该节点下的所有子元素(如 p、h1 等),提取纯文本内容(get_text())并写入本地文件 news.txt。
3. 分词处理
使用 jieba.cut() 对提取的文本进行分词。代码演示了两种模式:
- 全模式(cut_all=True):尝试找出所有可能的词语,速度快但存在冗余。
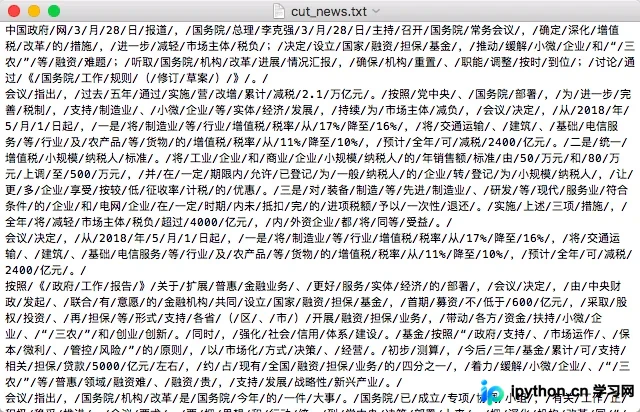
- 精确模式(cut_all=False):将句子最精确地切开,适合文本分析,也是默认模式。
最后,读取 news.txt 中的每一行文本,应用精确模式分词,并将分词结果以 / 分隔写入新文件 cut_news.txt。
代码实现
以下是完整的Python实现代码。请注意,实际使用时需确保已安装 requests、beautifulsoup4 和 jieba 库。
import requests
from bs4 import BeautifulSoup
import jieba

# 1. 获取网页HTML
url = "http://finance.ifeng.com/a/20180328/16049779_0.shtml"
res = requests.get(url)
res.encoding = 'utf-8'
content = res.text

# 2. 使用BeautifulSoup解析并提取正文
soup = BeautifulSoup(content, 'html.parser')
div = soup.find(id='main_content')

# 3. 将提取的文本写入临时文件
filename = 'news.txt'
with open(filename, 'w', encoding='utf-8') as file_object:
    for line in div.findChildren():
        file_object.write(line.get_text() + '\n')

# 4. 演示jieba分词功能(可选测试)
seg_list = jieba.cut("我来到北京清华大学", cut_all=True)
print("Full Mode: " + "/ ".join(seg_list))

seg_list = jieba.cut("他来到了网易杭研大厦")
print(", ".join(seg_list))

# 5. 对提取的正文文件进行分词并保存结果
with open(filename, 'r', encoding='utf-8') as file_object:
    with open('cut_news.txt', 'w', encoding='utf-8') as file_cut_object:
        for line in file_object.readlines():
            seg_list = jieba.cut(line, cut_all=False)
            file_cut_object.write('/'.join(seg_list))
注意事项
- 依赖安装:运行前请通过
pip install requests beautifulsoup4 jieba安装必要库。 - 目标网站结构:代码中硬编码了
id='main_content',若目标网页结构变更,需调整选择器。 - 编码问题:确保文件读写时编码一致(如
utf-8),避免中文乱码。 - 法律合规:抓取网页内容请遵守目标网站的使用条款及相关法律法规,避免高频请求导致服务器压力或法律风险。
以上就是Python实现网页抓取与jieba分词处理的详细内容,更多关于Python网络爬虫与文本处理的技术资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









