数据科学做Python分析用什么工具?Jupyter与Spyder详解
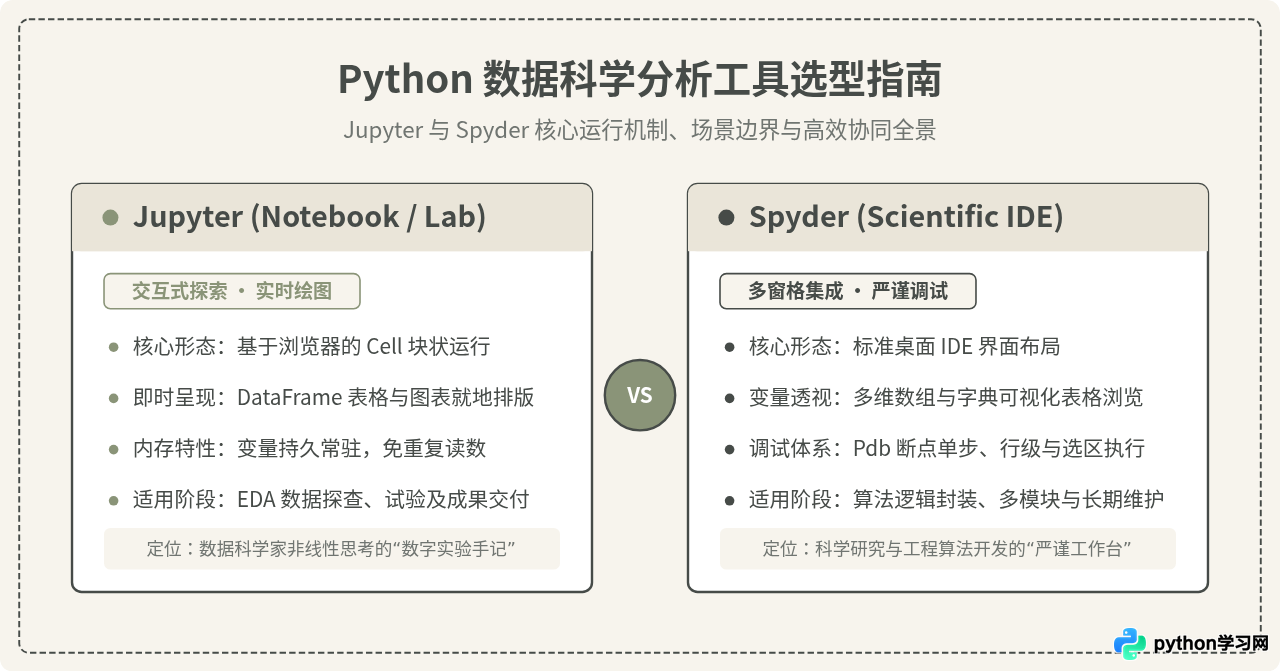
针对数据科学与Python分析中的核心工具选型,深入解析Jupyter(Notebook/Lab)与Spyder的运行机制、核心功能、交互差异与适用场景,提供明确的选型与协同方案。
2026-11-03
41
针对数据科学与Python分析中的核心工具选型,深入解析Jupyter(Notebook/Lab)与Spyder的运行机制、核心功能、交互差异与适用场景,提供明确的选型与协同方案。
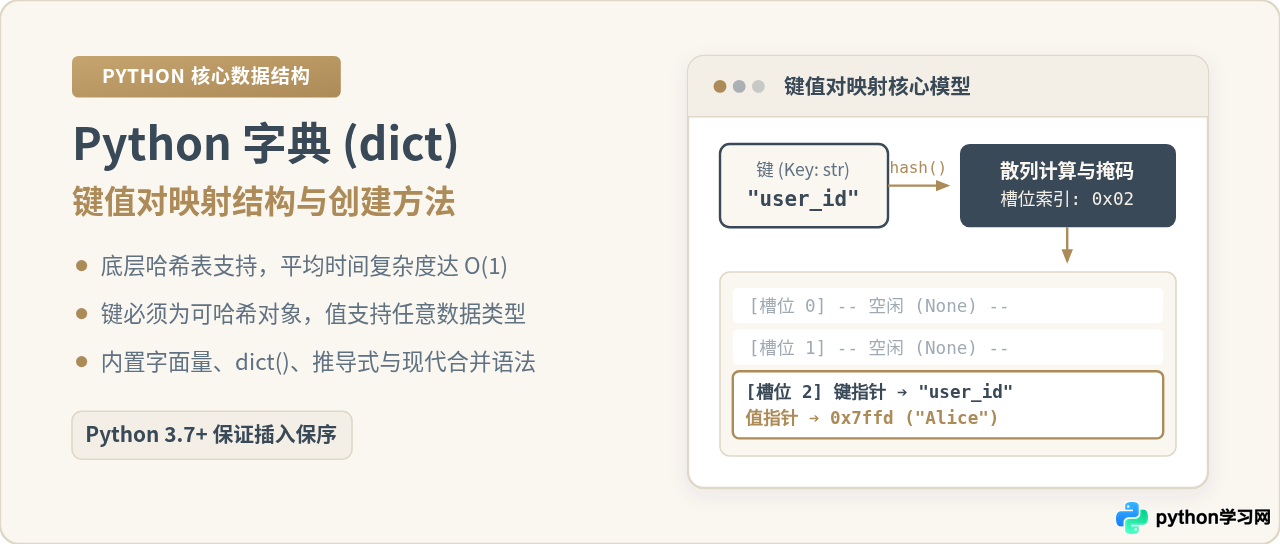
深入解析Python字典(dict)的底层映射结构与哈希原理,系统梳理字面量、构造函数、批量初始化、推导式与现代合并等5大创建方法及实战避坑指南。
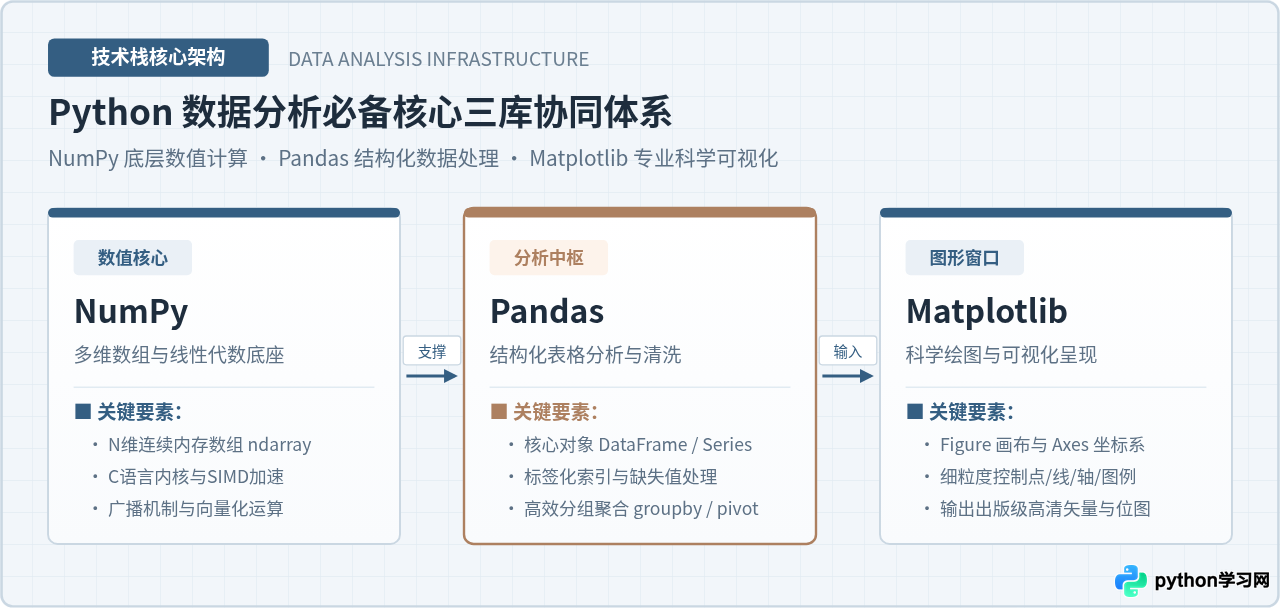
全面详解Python数据分析必备的三大核心库:NumPy底层数值计算、Pandas结构化数据处理与Matplotlib科学绘图。深入解析底层架构、核心API、内存模型及标准协同流水线。
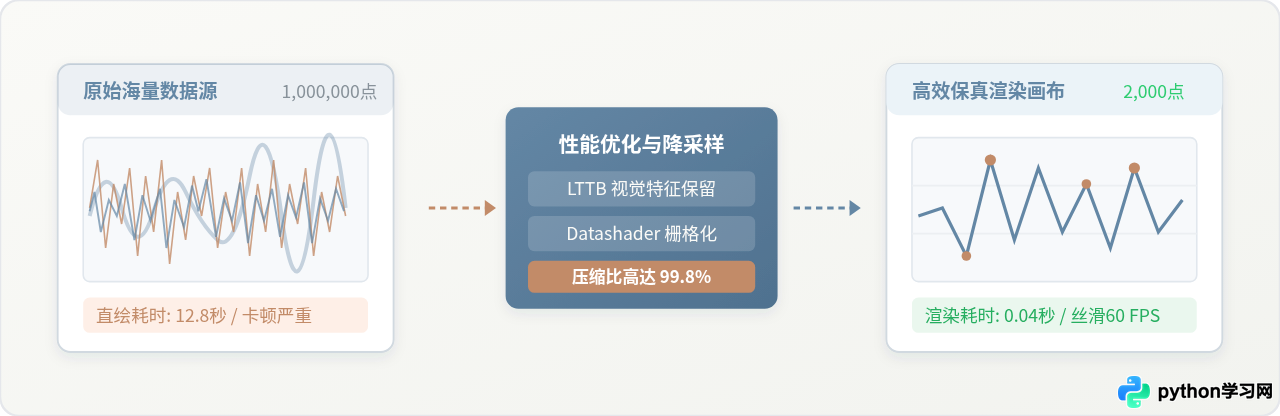
针对Python处理数十万至千万级数据绘图时界面卡死、渲染极其缓慢的问题,本文从渲染底层瓶颈剖析、Matplotlib原生加速配置、LTTB等高保真降采样算法,到千万级Datashader栅格化方案,提供全套可落地的性能优化与工程实践策略。
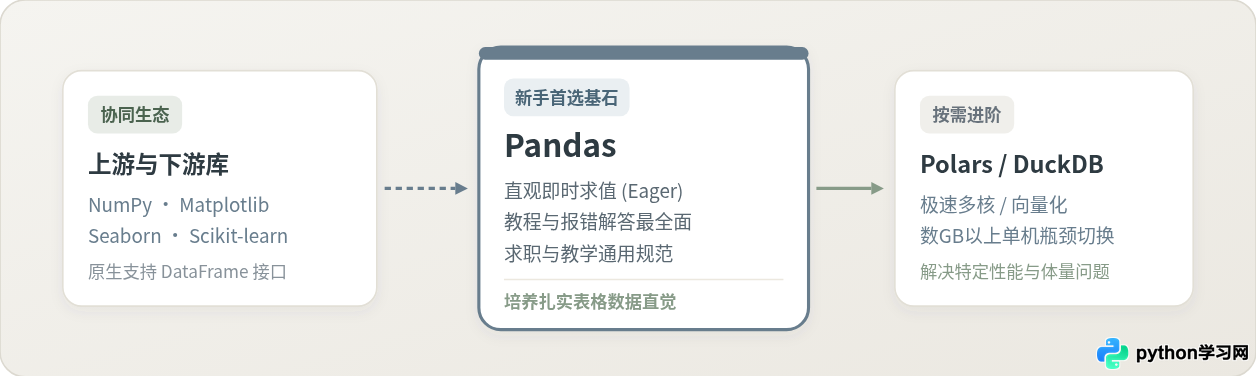
深入探讨Python数据分析新手应优先学习Pandas还是Polars、DuckDB等新兴框架。从学习曲线、生态联动、排错成本、执行机制及业务场景等维度,提供客观清晰的技术选型与成长路径建议。
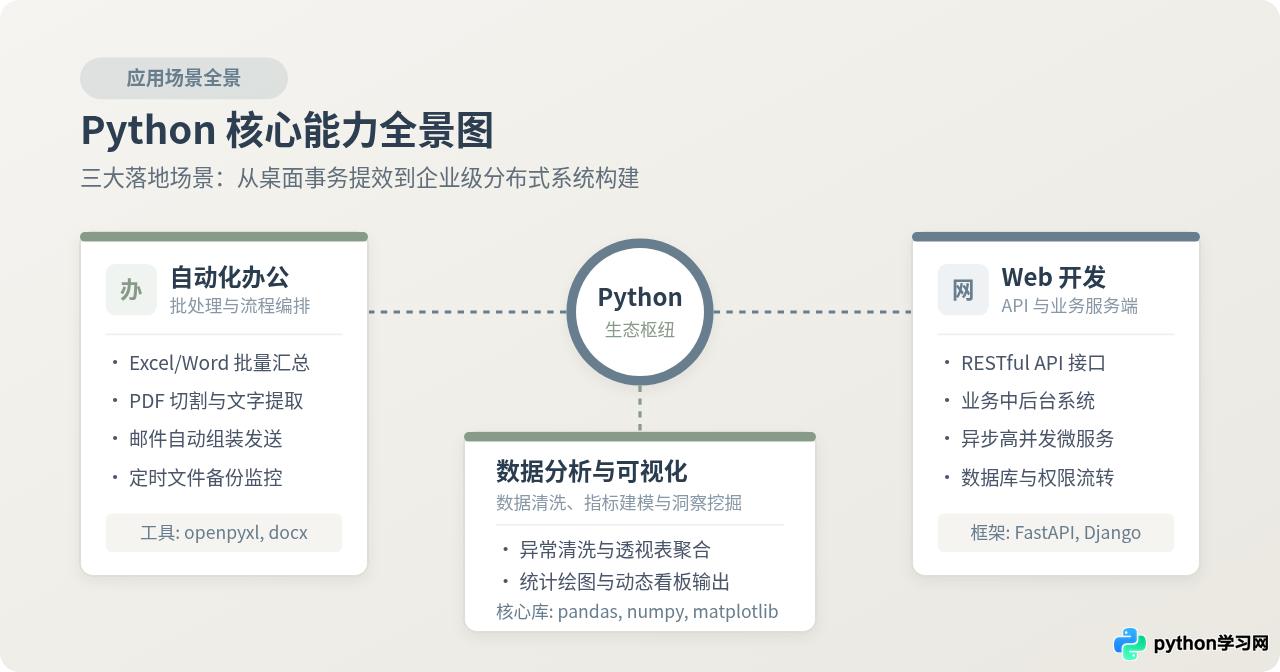
深入解析Python在自动化办公、Web后端开发与数据分析三大核心场景中的实际应用,通过具体操作代码、核心工具链解析、架构流程图与技术选型建议,帮助读者建立清晰的Python实用认知。
针对Python初学者的绘图模块选型指南。直接解答新手首选Matplotlib的核心原因,拆解绘图底层逻辑与核心对象架构,提供标准代码示例与避坑指南,并给出进阶学习路径。
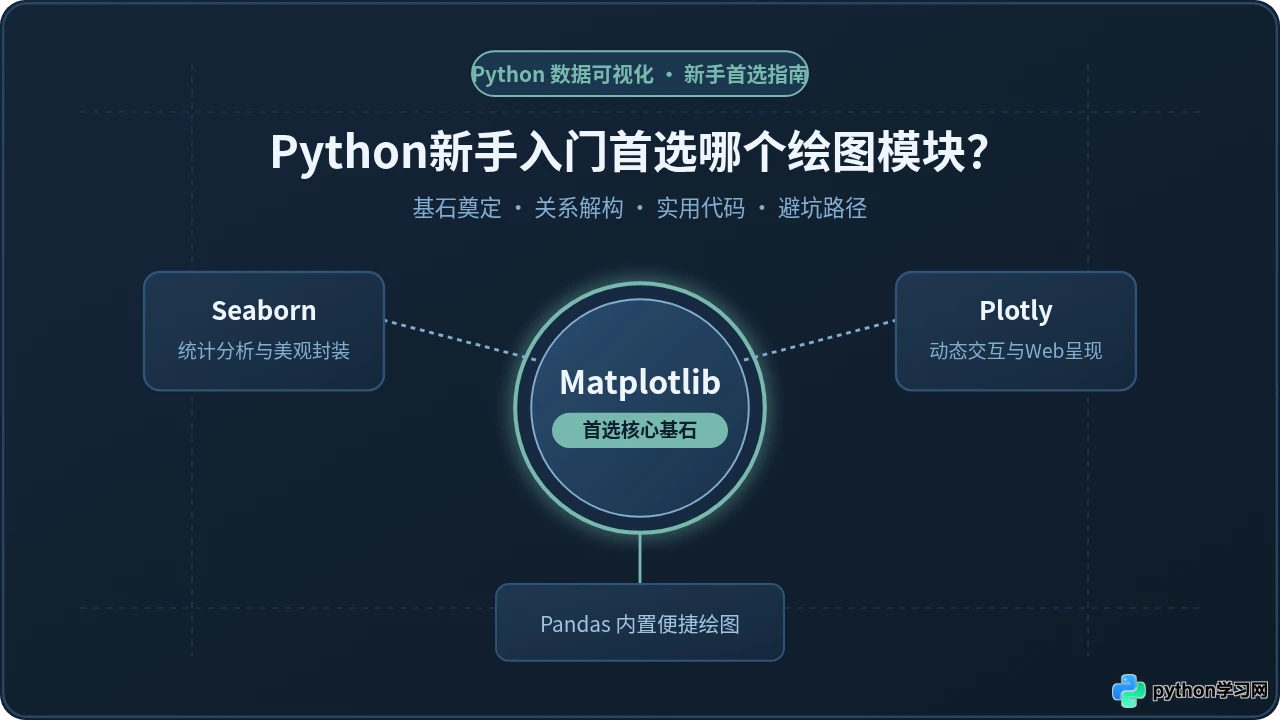
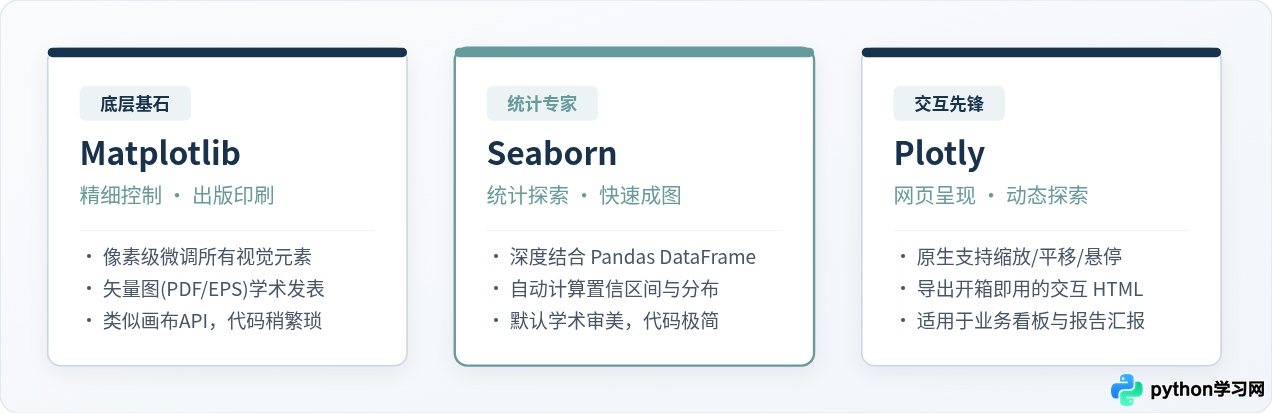
深入对比Python三大核心绘图库Matplotlib、Seaborn与Plotly的架构差异、适用场景、代码实现与选型决策树,帮助开发者和数据分析师根据交付媒介与交互需求快速选出最优工具。
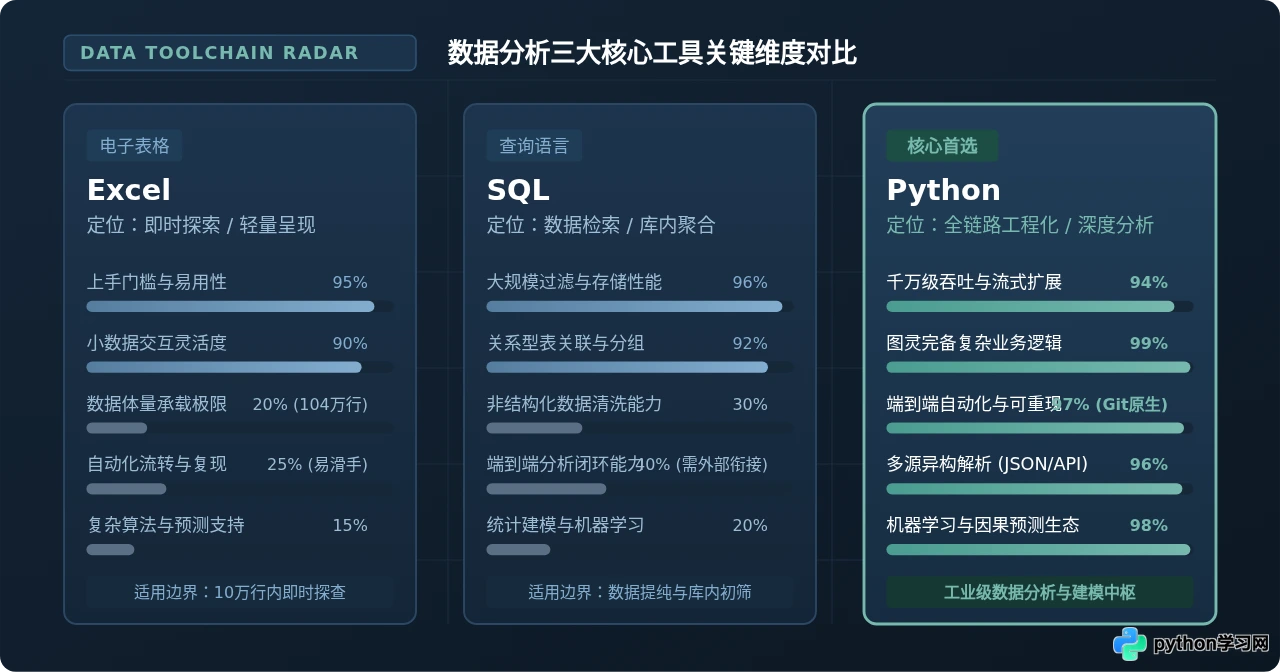
深入对比Python、Excel与SQL在数据量级、处理复杂度、自动化流水线与算法生态上的核心差异,解析为什么现代数据分析首选Python,并给出切实可行的高效协同工具链选型指南。
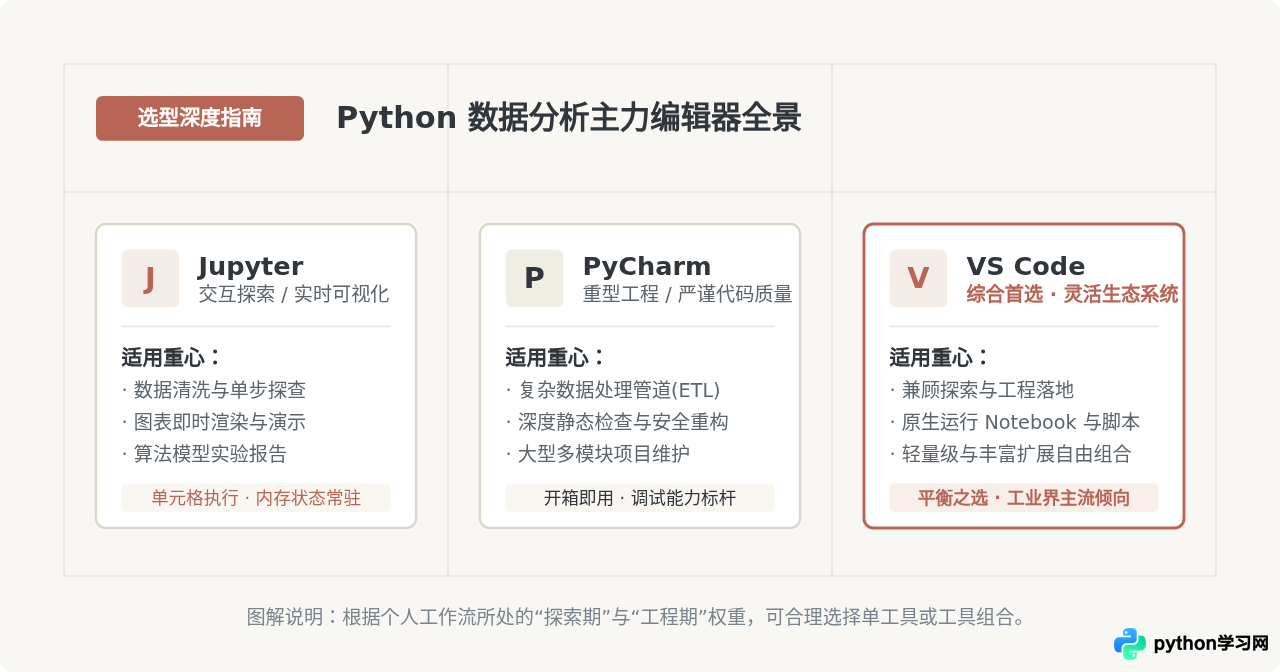
深入对比Jupyter、PyCharm与VS Code在Python数据分析场景下的定位、交互探索、调试能力、工程支持与资源开销,提供明确的选型决策与工作流搭建指南。
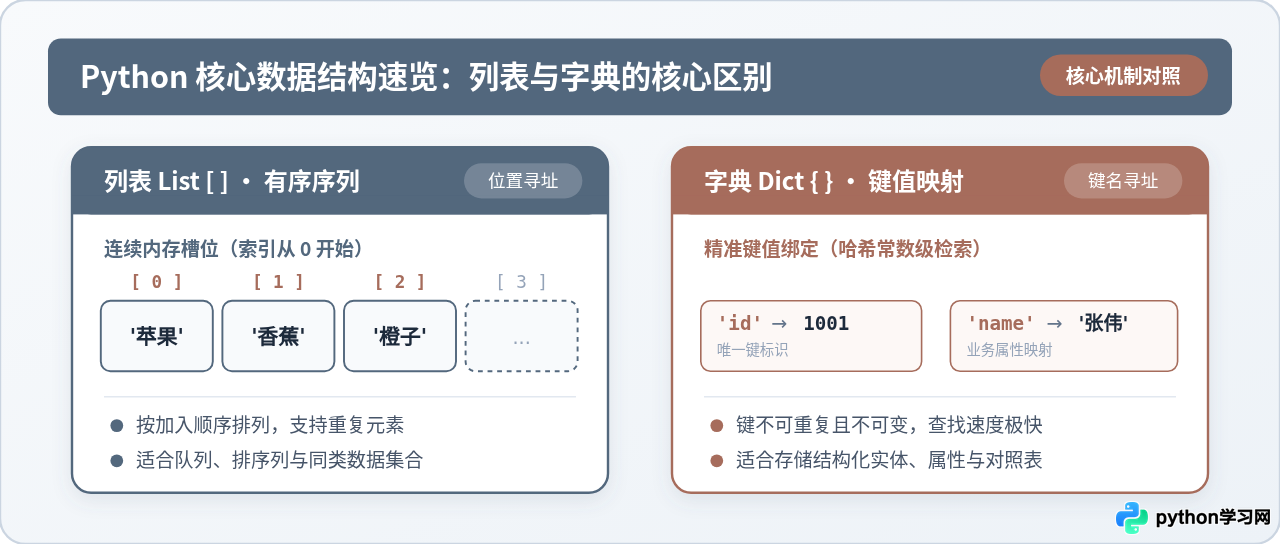
零基础系统掌握Python两大最核心的数据结构:列表(List)与字典(Dictionary)。本文详细解析列表的有序索引、增删改查、切片,以及字典的键值映射、安全查询与常用方法,配有直观架构图、代码示例与防坑指南。
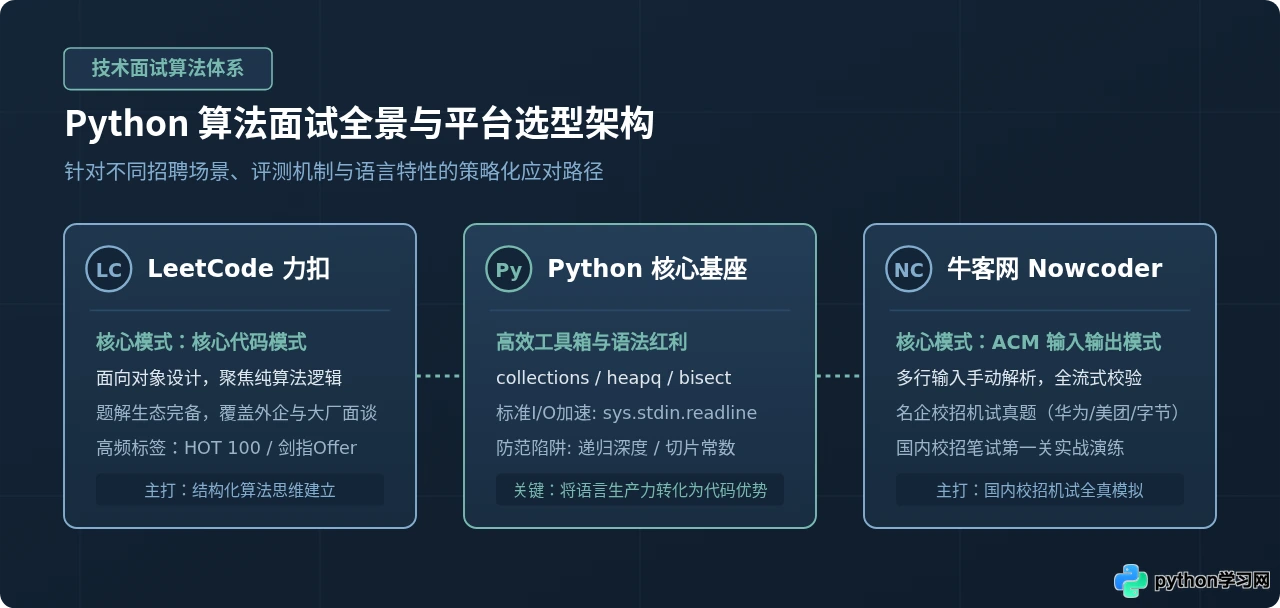
深度对比LeetCode、牛客网、HackerRank等算法练习网站的核心差异,剖析核心代码模式与ACM模式在Python下的具体实现、输入输出性能优化方案与四大避坑军规,提供系统的阶段性备考指南。