

Python数据分析必备库有哪些?Pandas、NumPy与Matplotlib详解
全面详解Python数据分析必备的三大核心库:NumPy底层数值计算、Pandas结构化数据处理与Matplotlib科学绘图。深入解析底层架构、核心API、内存模型及标准协同流水线。
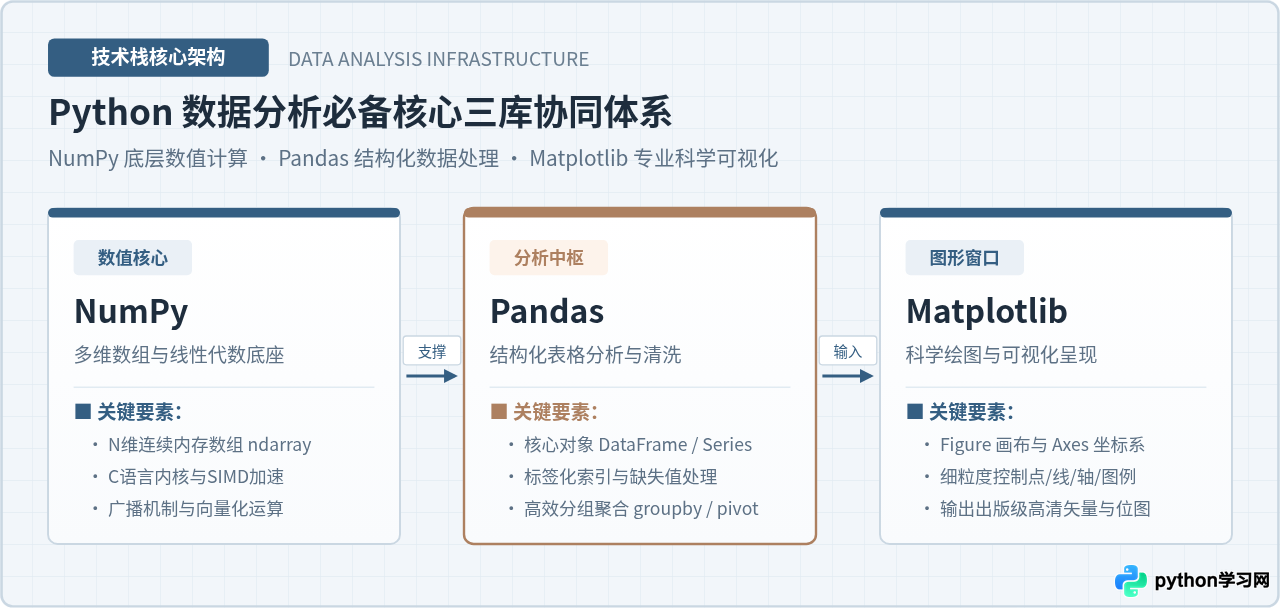
一、三大必备库的核心定位与分工协同
在初学 Python 数据分析时,很多读者常会产生疑惑:既然 Pandas 能够直接读写表格并进行统计,为什么还需要先学习 NumPy?既然 Pandas 自身集成了 .plot() 方法,为什么还要专门学习 Matplotlib?要厘清这些问题,必须从它们在计算架构中的分工说起。
这三个库并不是彼此竞争的并列替代品,而是处于不同技术抽象层次的共生组件:
- NumPy 充当算力底座:提供纯粹的高性能 N 维同质数组(
ndarray),在底层使用 C 语言内存管理与硬件级 SIMD 指令集,解决 Python 原生循环在海量数值计算中性能极慢的致命瓶颈。 - Pandas 充当业务中枢:建立在 NumPy 之上,为底层的数值数组赋予了业务语义标签(行索引 Index 与列名 Columns),专门应对真实场景中充满缺失值、多数据类型混杂、需要多表关联的二维表格数据。
- Matplotlib 充当视觉出口:作为 Python 可视化体系的底层绘图机,负责接收来自 NumPy 或 Pandas 的数据序列,通过画布(Figure)与坐标系(Axes)的精细拆解,将抽象的数据转换为直观的工程级图表。
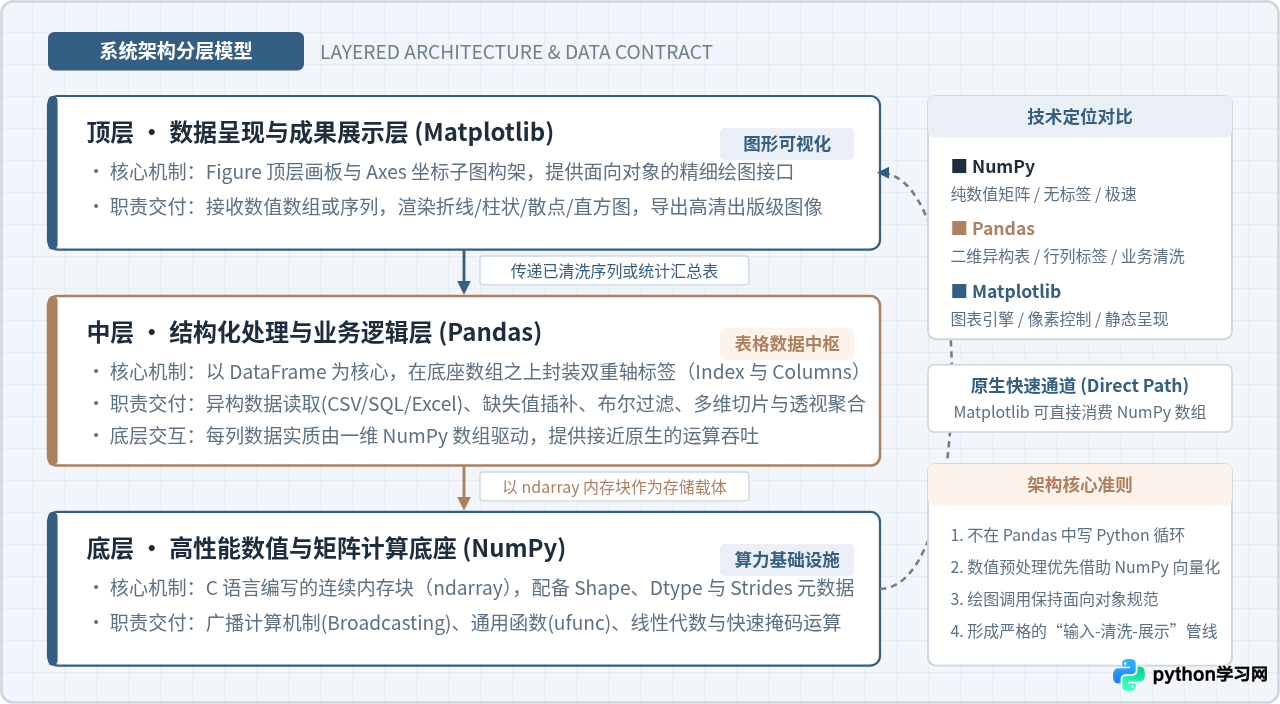
如图 1 所示,数据从底层向上传递:NumPy 的 ndarray 为 Pandas 的 DataFrame 提供物理存储;Pandas 在清洗与聚合完成后,将提炼出的指标列交给 Matplotlib 进行图形绘制。即使像 Seaborn 这样的高级统计绘图库,其底层依然依赖 Matplotlib 渲染,数据载体依然依托 Pandas 与 NumPy。
二、NumPy 详解:高性能数值计算与矩阵底座
NumPy(Numerical Python)是整个 Python 科学计算生态的绝对基石。在数据分析中,当遇到成百上千万行的大规模数据、复杂的数学变换或多维矩阵运算时,原生 Python 的效率往往无法接受,而 NumPy 正是为了突破这一极限而生。
1. 核心数据结构:ndarray 与内存机制
NumPy 最核心的抽象是 ndarray(N-dimensional array,N维数组)。许多读者在刚接触时会将其误认为 Python 原生列表(list),但两者的底层内存组织截然不同:
- Python List 的离散引用:Python 原生列表本质上是一个指针数组。列表中的每个元素都是一个独立的 Python 对象(
PyObject),包含类型标识、引用计数和实际数值,散落在系统的堆内存中。在遍历列表时,CPU 缓存命中率极低,且必须在每次迭代时动态判断数据类型,产生巨大的解释器开销。 - NumPy ndarray 的连续同质块:
ndarray要求数组内所有元素的数据类型完全一致(同质性,如全为int64或float64),并在内存中分配一块严格连续的物理地址空间。数组头部仅维护 Shape(各维度大小)、Dtype(数据类型)和 Strides(跨度步长)等轻量元数据。
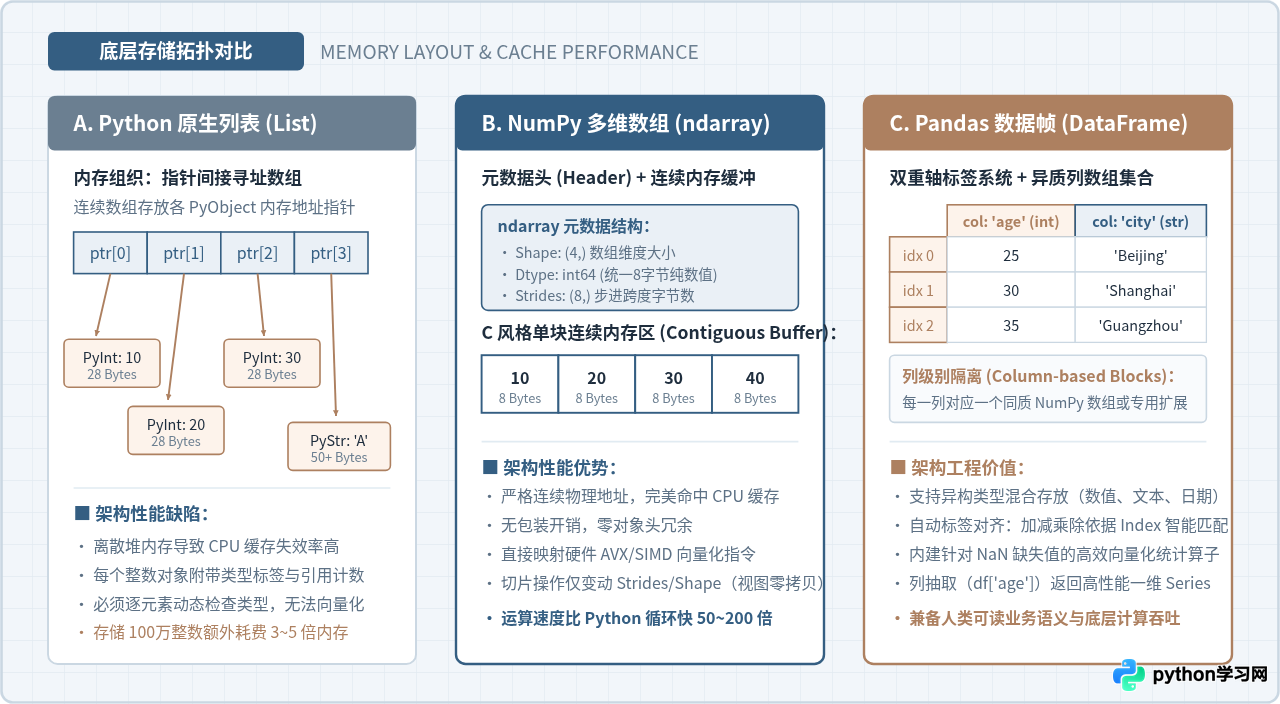
如上图 3 所示,连续内存布局使得 NumPy 能够直接调用现代 CPU 的 L1/L2 缓存与向量化(SIMD)并行指令,计算速度通常比原生 Python 循环快 50 到 200 倍,同时内存消耗大幅缩减。
2. 核心运算特性:向量化运算与广播机制
在数据分析中编写高效代码的第一法则,就是彻底摒弃显式的 for 循环,改用向量化表达式。所谓向量化,即在编写代码时以整个数组为操作单元,而底层的循环则由高度优化的 C 语言代码完成。
当参与运算的两个数组维度不同时,NumPy 会触发广播机制(Broadcasting)。只要满足以下两条规则之一,不同维度的数组就能自动拓展并对齐运算:
- 两数组在该维度上的大小完全相等;
- 其中一个数组在该维度上的大小为 1。
以下示例展示了数组创建、向量化数学运算以及通过 np.where 实现条件快速分支的典型用法:
import numpy as np

# 1. 创建一维与二维数值数组
arr_1d = np.array([10.0, 20.0, 30.0, 40.0, 50.0])
matrix = np.arange(1, 10).reshape(3, 3)  # 生成 1 到 9 并重塑为 3x3 矩阵

# 2. 向量化运算(无需循环,直接对整个数组应用算子)
log_values = np.log(arr_1d)              # 快速对数变换
normalized = (arr_1d - np.mean(arr_1d)) / np.std(arr_1d)  # Z-Score 标准化

# 3. 广播机制示例:3x3 矩阵与 1x3 向量相加(向量自动沿第0轴向下广播)
row_vector = np.array([100, 200, 300])
broadcast_result = matrix + row_vector

# 4. 高效条件过滤与分支替换(替代低效的 if-else 列表推导式)
# 规则:大于 25 的数值加权 1.2 倍,其余保持原样
adjusted_arr = np.where(arr_1d > 25.0, arr_1d * 1.2, arr_1d)

print("原始数组:", arr_1d)
print("条件加权调整后:", adjusted_arr)
sub = arr[1:4])时,返回的仅仅是原数组的视图(View),共享同一块底层内存。如果在 sub 上修改数值,原数组 arr 会同步改变!如果需要独立的数组,必须显式调用 sub = arr[1:4].copy()。
三、Pandas 详解:结构化表格分析与数据清洗中枢
尽管 NumPy 在纯数值矩阵运算上拥有极致性能,但现实世界中的数据分析任务绝大多数是“异构二维表格”——一列是字符串格式的用户名,一列是日期,一列是带空值的浮点型金额。面对这类具有业务语义的数据,NumPy 纯数值、无列名索引的特性就显得捉襟见肘,这正是 Pandas 发挥核心威力的舞台。
1. 核心抽象:Series 与 DataFrame
Pandas(Python Data Analysis Library)主要构建在两大核心数据结构之上:
pd.Series:带标签的一维同质数组。可以将其视作 NumPy 一维数组与 Python 字典的结合体,既能通过整数位置索引,也能通过自定义标签进行高效对齐检索。pd.DataFrame:带行列标签的二维异质表格。在概念上等同于 SQL 数据表或 Excel 工作表。DataFrame 的每一列都是一个独立的 Series,不同列之间可以拥有不同的数据类型(数值、对象、布尔、日期等)。
2. 数据分析标准清洗与处理关键动作
在实际业务分析中,拿到数据后的核心处理通常包含四大关键环节:
- 数据探测与校验:使用
df.info()查看非空计数与字段类型,使用df.describe()查看数值列的均值、标准差与分位数,使用df.isna().sum()掌握缺失分布。 - 缺失值与脏数据治理:根据业务规则选择丢弃(
dropna)或补全(fillna,常用均值、中位数或向前填充ffill)。 - 条件筛选与衍生列创建:利用布尔掩码直接过滤行,基于向量化计算生成新业务指标。
- 分组聚合(Group By)与数据透视:依照业务维度分组,提取关键聚合汇总统计量。
以下代码演示了从零构建订单数据集、处理缺失值并执行分组统计的完整流程:
import pandas as pd
import numpy as np

# 1. 模拟真实业务销售记录(包含缺失值与不同数据类型)
raw_data = {
    'order_id': ['ORD-001', 'ORD-002', 'ORD-003', 'ORD-004', 'ORD-005', 'ORD-006'],
    'region': ['华东', '华南', '华东', '华北', '华南', '华东'],
    'sales_amt': [1200.0, np.nan, 850.0, 2300.0, 1600.0, 3100.0],
    'discount': [0.10, 0.05, 0.00, 0.15, np.nan, 0.20],
    'is_member': [True, False, True, True, False, True]
}

df = pd.DataFrame(raw_data)

# 2. 探查并清洗缺失值
# 对销售额缺失的记录用区域中位数填充,对折扣缺失的用 0.0 兜底
df['sales_amt'] = df['sales_amt'].fillna(df.groupby('region')['sales_amt'].transform('median'))
df['discount'] = df['discount'].fillna(0.0)

# 3. 向量化计算实际实付金额(衍生新字段)
df['net_pay'] = df['sales_amt'] * (1 - df['discount'])

# 4. 多维度分组聚合统计
summary = df.groupby('region').agg(
    order_count=('order_id', 'count'),
    total_sales=('sales_amt', 'sum'),
    avg_net_pay=('net_pay', 'mean'),
    member_ratio=('is_member', 'mean')
).reset_index()

print("清洗并聚合后的区域汇总表:")
print(summary)
df[df['sales_amt'] > 1000]['discount'] = 0.2)时,经常会触发著名的 SettingWithCopyWarning。这是因为链式索引无法保证返回的是原表的切片还是副本。正确的做法是统一使用 .loc 显式定位:df.loc[df['sales_amt'] > 1000, 'discount'] = 0.2。
四、Matplotlib 详解:科学绘图与可视化呈现引擎
数据经过清洗和统计后,必须通过图表形式呈现给决策者。Matplotlib 是 Python 最成熟、功能最完备的绘图库。无论是探索性数据分析(EDA)还是撰写学术论文、制作高管报表,Matplotlib 都提供了对图形每一个细节(线条粗细、刻度方向、坐标轴标签、图例、字体)的精确掌控力。
1. 核心架构:Figure 与 Axes
理解 Matplotlib 的关键,在于分清其层次分明的对象模型:
Figure(画布):指代整个绘图窗口或保存的文件。它是所有绘图元素的顶层容器,可以包含一个或多个子图。Axes(坐标系子图):指代具体的绘图区域,包含 X 轴、Y 轴、刻度线、标签和图例。我们平时画的折线、柱状图,实际上都绘制在具体的Axes对象上。
Matplotlib 提供了两种调用风格:一种是仿照 MATLAB 的 pyplot 状态机风格(如 plt.plot());另一种是面向对象风格(Object-Oriented API)。在专业数据分析工程中,强烈建议始终使用面向对象风格(fig, ax = plt.subplots())。这种写法结构清晰、多子图管理从容,能完全避免状态机隐式切换导致的坐标轴错乱问题。
2. 工程级可视化绘图示例
以下示例演示了使用面向对象接口绘制包含两个独立子图的工程图表,并规范配置中文字体、网格与高分辨率导出:
import matplotlib.pyplot as plt
import numpy as np

# 1. 规范配置字体,防止中文方块与负号乱码
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

# 2. 准备绘图数据
months = np.array(['1月', '2月', '3月', '4月', '5月', '6月'])
sales_2025 = np.array([45, 52, 68, 74, 82, 95])
sales_2026 = np.array([50, 58, 79, 88, 99, 115])

# 3. 创建 1 行 2 列的画布与坐标系
fig, (ax1, ax2) = plt.subplots(nrows=1, ncols=2, figsize=(12, 4.5), dpi=100)

# 子图 1:年度销售额趋势对比(折线图)
ax1.plot(months, sales_2025, marker='o', color='#345E82', linewidth=2, label='2025年')
ax1.plot(months, sales_2026, marker='s', color='#AD8060', linewidth=2, linestyle='--', label='2026年')
ax1.set_title('上半年月度销售额趋势走势', fontsize=13, fontweight='bold', pad=10)
ax1.set_xlabel('月份', fontsize=11)
ax1.set_ylabel('销售额 (万元)', fontsize=11)
ax1.grid(True, linestyle=':', alpha=0.6)
ax1.legend(frameon=True)

# 子图 2:2026 年各月同比增速(柱状图)
growth_rate = ((sales_2026 - sales_2025) / sales_2025) * 100
bars = ax2.bar(months, growth_rate, color='#345E82', alpha=0.85, width=0.5)
ax2.set_title('2026年上半年同比增长率 (%)', fontsize=13, fontweight='bold', pad=10)
ax2.set_xlabel('月份', fontsize=11)
ax2.set_ylabel('增长率 (%)', fontsize=11)
ax2.axhline(0, color='gray', linewidth=0.8, linestyle='--')
ax2.grid(axis='y', linestyle=':', alpha=0.6)

# 为柱状图添加数值标签
for bar in bars:
    yval = bar.get_height()
    ax2.text(bar.get_x() + bar.get_width() / 2.0, yval + 0.8, f'{yval:.1f}%', ha='center', va='bottom', fontsize=9)

# 4. 优化排版并保存
plt.tight_layout()
# 导出出版级高清图像
# fig.savefig('sales_analysis_report.png', dpi=300, bbox_inches='tight')
# 批量渲染后务必关闭画布释放内存
plt.close(fig)
plt.savefig() 而未调用 plt.close(fig),已创建的 Figure 对象会常驻内存不被释放,导致严重的内存泄漏。养成每次保存图表后立即显式 plt.close(fig) 是生产环境的必要习惯。
五、三库联动实战:标准数据分析流水线
在实际工程项目中,数据分析从来不是割裂使用某一个库,而是依照流水线规范层层推进。标准的执行作业规程可总结为四个固定步骤:
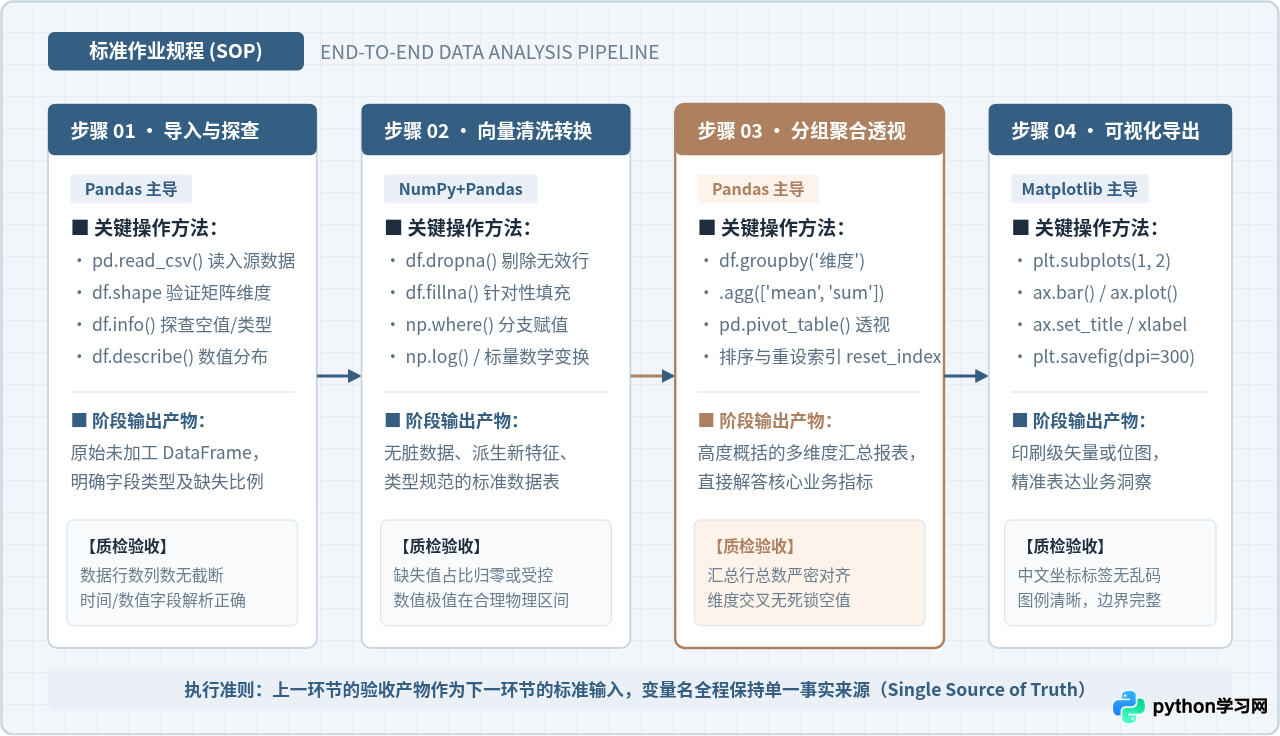
以下完整案例演示了三库如何在一次端到端的数据分析任务中无缝衔接:从构造具有随机分布与脏数据的订单表、应用 NumPy 条件清洗、利用 Pandas 聚合分析,到最终用 Matplotlib 输出可视化报表。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# -------------------------------------------------------------
# 步骤 1:数据生成与导入探查 (NumPy 生成随机数,Pandas 封装)
# -------------------------------------------------------------
np.random.seed(42)
n_samples = 1000

categories = np.random.choice(['电子产品', '家居百货', '服饰鞋帽', '生鲜食品'], size=n_samples)
base_prices = np.random.exponential(scale=150, size=n_samples) + 20
quantities = np.random.poisson(lam=2.5, size=n_samples) + 1

df = pd.DataFrame({
    'category': categories,
    'unit_price': base_prices,
    'quantity': quantities
})

# 人为注入 5% 的异常极值与 3% 的缺失值模拟脏数据
df.loc[df.sample(frac=0.03).index, 'unit_price'] = np.nan
df.loc[df.sample(frac=0.01).index, 'unit_price'] = 99999.0  # 离群脏数据

# -------------------------------------------------------------
# 步骤 2:数据清洗与特征变换 (NumPy 向量化运算 + Pandas 过滤)
# -------------------------------------------------------------
# 2.1 剔除缺失记录
df = df.dropna(subset=['unit_price']).copy()

# 2.2 利用 NumPy 盖帽法(Winsorization)平滑离群极大值(以99分位为界)
p99 = np.percentile(df['unit_price'], 99)
df['clean_price'] = np.where(df['unit_price'] > p99, p99, df['unit_price'])

# 2.3 向量化计算订单总金额与对数金额
df['total_amount'] = df['clean_price'] * df['quantity']
df['log_amount'] = np.log1p(df['total_amount'])

# -------------------------------------------------------------
# 步骤 3:多维业务统计与透视聚合 (Pandas 聚合主导)
# -------------------------------------------------------------
category_report = df.groupby('category').agg(
    order_volume=('quantity', 'sum'),
    gmv=('total_amount', 'sum'),
    avg_order_value=('total_amount', 'mean')
).sort_values(by='gmv', ascending=False).reset_index()

# -------------------------------------------------------------
# 步骤 4:专业成果可视化绘制与导出 (Matplotlib 面向对象绘图)
# -------------------------------------------------------------
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

fig, (ax_bar, ax_box) = plt.subplots(1, 2, figsize=(13, 5), dpi=100)

# 图 A:各品类 GMV 贡献柱状对比
bars = ax_bar.bar(category_report['category'], category_report['gmv'] / 10000,
                  color='#345E82', width=0.45, edgecolor='#223F58')
ax_bar.set_title('各品类成交总额 (GMV) 贡献对比', fontsize=12, fontweight='bold')
ax_bar.set_ylabel('成交额 (万元)', fontsize=11)
ax_bar.grid(axis='y', linestyle='--', alpha=0.5)

for bar in bars:
    h = bar.get_height()
    ax_bar.text(bar.get_x() + bar.get_width()/2, h + 0.1, f'{h:.1f}万', ha='center', va='bottom', fontsize=9)

# 图 B:各品类订单金额分布对比 (箱线图,展示中位数与分布离散度)
data_by_cat = [df[df['category'] == cat]['total_amount'].values for cat in category_report['category']]
box = ax_box.boxplot(data_by_cat, labels=category_report['category'], patch_artist=True,
                     boxprops=dict(facecolor='#EAF0F6', color='#345E82'),
                     medianprops=dict(color='#AD8060', linewidth=2),
                     whiskerprops=dict(color='#345E82'),
                     capprops=dict(color='#345E82'),
                     flierprops=dict(marker='.', color='#AD8060', alpha=0.4))
ax_box.set_title('各品类单笔订单金额分布箱线图', fontsize=12, fontweight='bold')
ax_box.set_ylabel('订单金额 (元)', fontsize=11)
ax_box.grid(axis='y', linestyle='--', alpha=0.5)

plt.tight_layout()
# 导出成果图
fig.savefig('category_performance_report.png', dpi=300, bbox_inches='tight')
plt.close(fig)

print("端到端流水线执行完毕,报表已生成。")
六、总结与技术选型对照矩阵
在日常数据工作中,判断何时使用哪个库并遵守其最佳实践,能够极大提升分析效率并规避潜在隐患。下表与对照矩阵总结了三大核心库的关键选型决策依据:
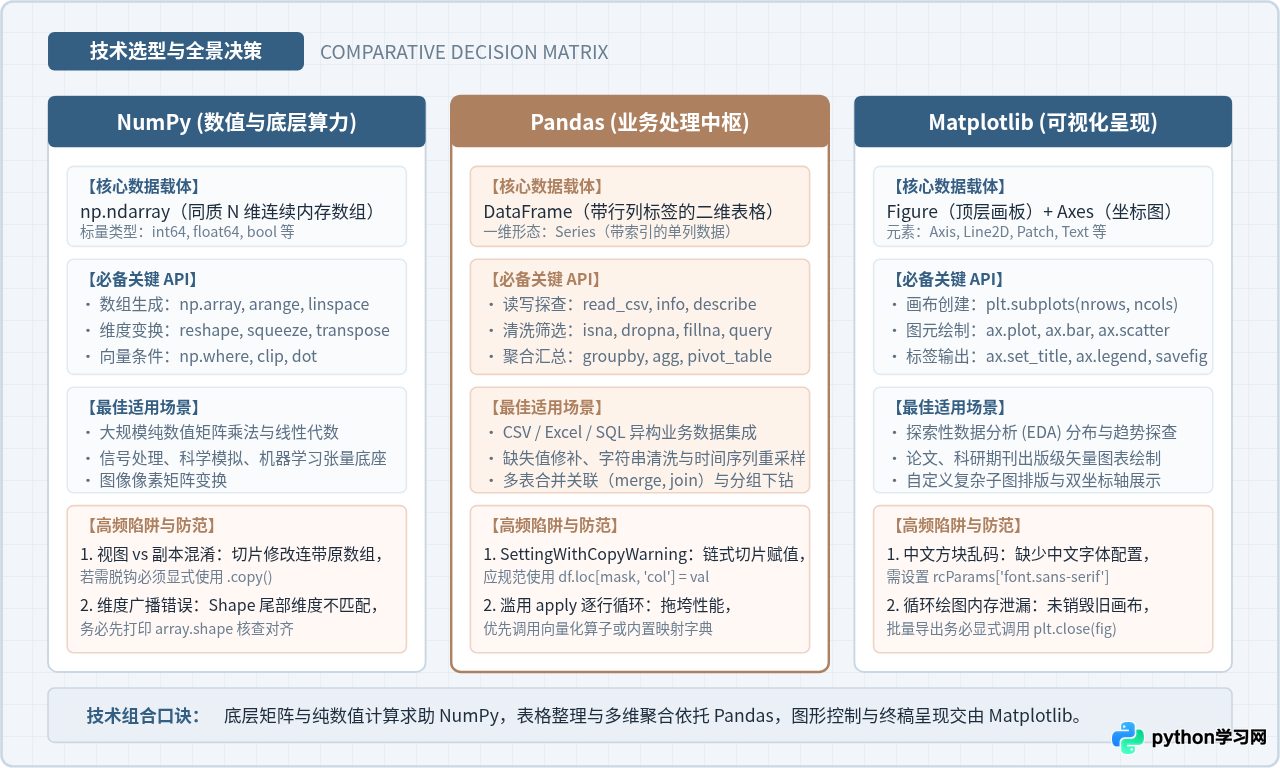
| 对比维度 | NumPy | Pandas | Matplotlib |
|---|---|---|---|
| 核心数据载体 | ndarray (同质、N维、连续内存) |
DataFrame / Series (异质、带索引) |
Figure (画布) / Axes (坐标系) |
| 主要工作任务 | 大规模矩阵相乘、线性代数、快速掩码与广播变换 | CSV/SQL数据读取、缺失值清洗、行列切片、分组透视 | 科学与商业图表绘制、多子图编排、高分辨率排版输出 |
| 最适合的使用场景 | 纯数值密集型计算、底层算法构建、科学仿真建模 | 业务数据表格整理、指标多维挖掘、报表自动化生成 | 数据探索发现(EDA)、业务报告配图、学术论文图表定制 |
| 常见高频陷阱 | 切片修改污染原数组(视图陷阱);广播维度未对齐 | 链式赋值引发 SettingWithCopyWarning;滥用循环 |
循环绘图内存未释放;缺少中文字体配置导致乱码 |
| 推荐代码习惯 | 优先使用 np.where 与向量化函数,显式 .copy() |
统一使用 .loc 索引赋值;善用 groupby().agg() |
坚持使用 plt.subplots() 面向对象接口;用后即 close() |
综上所述,Python 数据分析的精髓在于“各司其职、协同作业”:以 NumPy 作为高性能数值计算与连续内存的底座,以 Pandas 作为面向业务表格与清洗聚合的中枢,以 Matplotlib 作为严谨直观表达成果的图形窗口。牢固掌握这三者的底层逻辑与标准交互流水线,便能从容应对绝大多数实际业务与科学研究中的数据分析挑战。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









