

数据科学做Python分析用什么工具?Jupyter与Spyder详解
针对数据科学与Python分析中的核心工具选型,深入解析Jupyter(Notebook/Lab)与Spyder的运行机制、核心功能、交互差异与适用场景,提供明确的选型与协同方案。
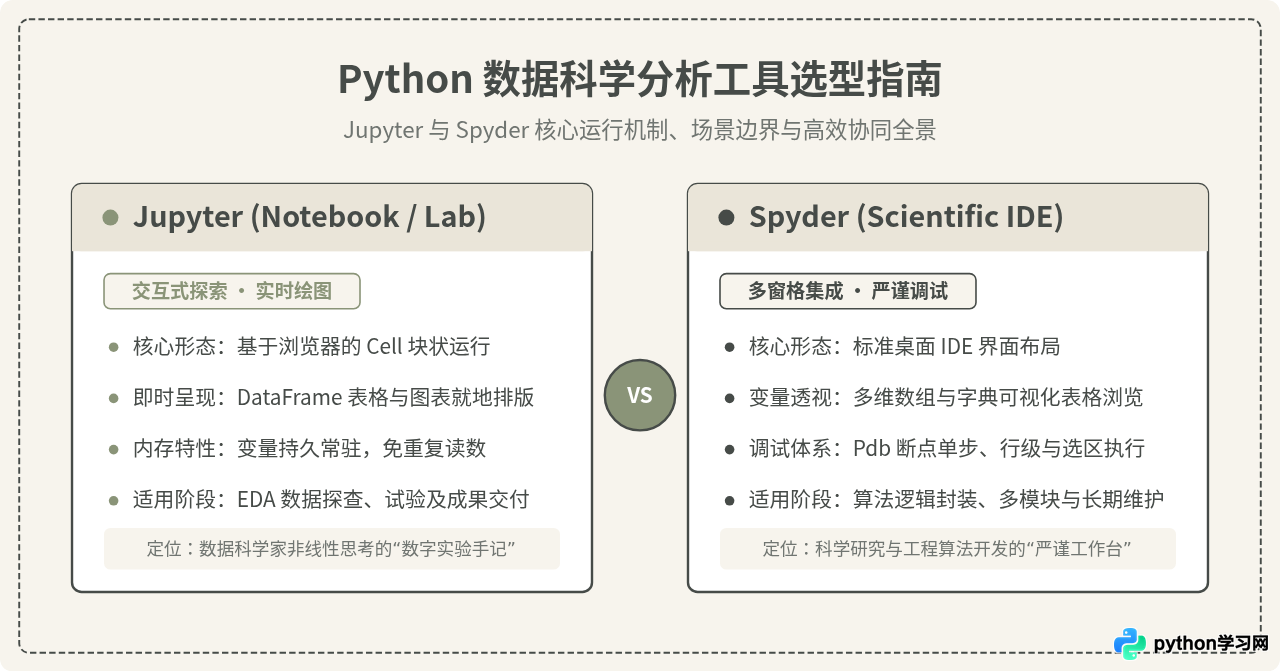
在数据科学与 Python 数据分析领域,选择合适的环境往往直接决定了分析效率与工程质量。核心答案非常明确:Jupyter(含 Jupyter Notebook 与 JupyterLab)与 Spyder 是科学计算生态中定位鲜明且高度互补的两大主流工具。Jupyter 采用基于浏览器的块状交互模式,擅长探索性数据分析(EDA)、即时数据可视化与叙事化分析报告交付;Spyder 则采用传统科学桌面 IDE 的三段式布局,以严谨的多窗格联动、全局变量透视表与单步行级断点调试见长,更适合复杂多模块算法实现与脚本工程化重构。理解二者的机制差异与协作模式,是搭建高效分析工具链的关键。
一、数据科学分析的核心诉求与工具定位
进行传统软件开发时,程序员关注的重点通常是模块解耦、代码复用、单元测试与构建部署,代码执行往往遵循“自顶向下、单次编译/运行”的线性逻辑。但数据科学分析的工作流具有鲜明的特殊性:
- 高度非线性的探索过程: 分析人员在拿到一份原始数据时,通常无法一次性写出成型的处理管道,而是需要不断尝试切片、观察缺失值分布、验证假设并调整特征参数;
- 昂贵的数据加载开销: 动辄几百兆乃至数吉字节的数据集,若每次微调代码都要重新从磁盘读取并解析,会造成极大的时间浪费,因此工具必须支持内存上下文驻留;
- 即时可视化的反馈需求: 数据清洗效果和模型收敛曲线需要频繁以图表或交互式表格呈现,图文混排能够极大降低思维切换成本。
正是由于这些诉求,脱胎于 IPython 生态的 Jupyter 和专为科研打造的 Spyder 逐渐成为数据科学领域的标配。接下来我们深入拆解两者的运行原理与适用边界。
二、Jupyter 详解:探索性数据分析(EDA)的交互利器
Jupyter(涵盖经典 Jupyter Notebook 及下一代工作台 JupyterLab)的核心理念源自“文学化编程”(Literate Programming)。它将代码、运行结果、富文本说明、LaTeX 公式与图表编织在同一个被称为 .ipynb 的 JSON 格式文档中。
1. 块状执行与常驻内核机制
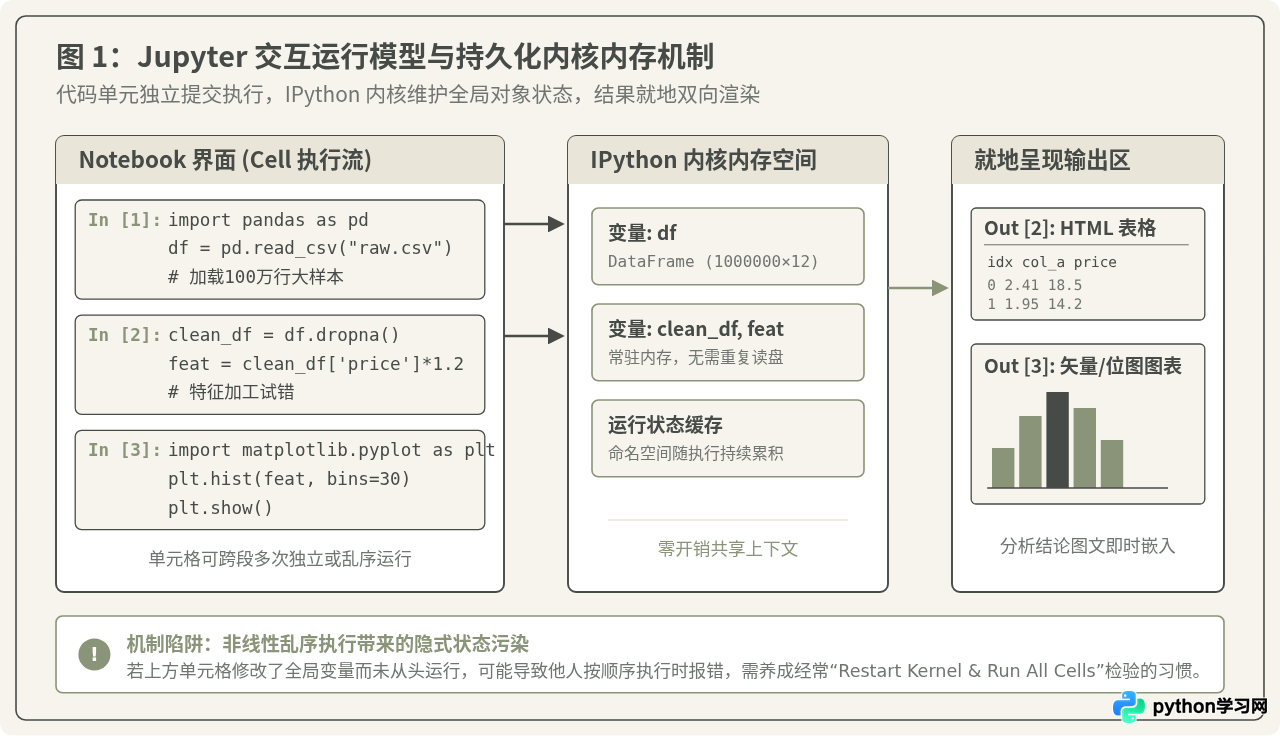
Jupyter 采用客户端与服务端解耦的架构。前端运行在浏览器中,由一个个独立的“单元格”(Cell)组成;后端则由一个独立的 IPython Kernel 进程负责执行代码。
当你在某个单元格中执行 df = pd.read_csv("large_data.csv") 后,该 df 对象将被持久保存在内核进程的全局命名空间内。后续单元格无论执行多少次切片、聚合或绘图计算,均可直接引用内存中的 df,完全无需重复读盘。
2. 核心优势
- 所见即所得的就地排版: 运行包含 Matplotlib、Seaborn 或 Plotly 代码的单元格时,图表直接嵌在代码正下方;输出 Pandas DataFrame 时自动渲染为整洁的 HTML 表格;
- 叙事化报告直接交付: 结合 Markdown 单元格,分析人员可以在数据探查的同时撰写业务推导逻辑、分析假设与阶段性结论,最终可通过
nbconvert一键导出为 HTML 网页、PDF 文档或演示幻灯片; - 轻量级试验与教学演示: 极低的环境门槛让初学者无需配置复杂工程,便能直观感受每一行代码产生的数据变化。
3. 局限性与典型陷阱
虽然 Jupyter 在探索阶段极其敏捷,但在严肃工程中存在明显的机制局限:
- 乱序执行的隐式状态污染: 单元格可以任意跳跃执行。如果先运行了底部的计算代码,再回头修改了顶部的变量,当前内存状态便与代码的文字书写顺序脱节。他人拿到 Notebook 从头运行(Run All)时极易发生
NameError或计算结果不一致; - 版本控制困难:
.ipynb本质是嵌套了 Base64 图片和输出元数据的长 JSON 文件。在 Git 中合并冲突极为繁琐,难以进行清晰的逐行代码 Review; - 重构与大型模块开发乏力: 缺乏跨文件的函数跳转、全局重命名重构与深层类型提示,难以支撑成百上千行的复杂系统。
三、Spyder 详解:专为科学计算打造的集成开发环境
Spyder(Scientific Python Development Environment)是专为科学家、工程师与数据分析师打造的开源桌面 IDE。它的设计界面和操作习惯深度参考了 MATLAB 和 RStudio,力求在一个窗口内整合代码编写、变量观察、图表管理和交互式控制台。
1. 多窗格协同与传统科学工作台
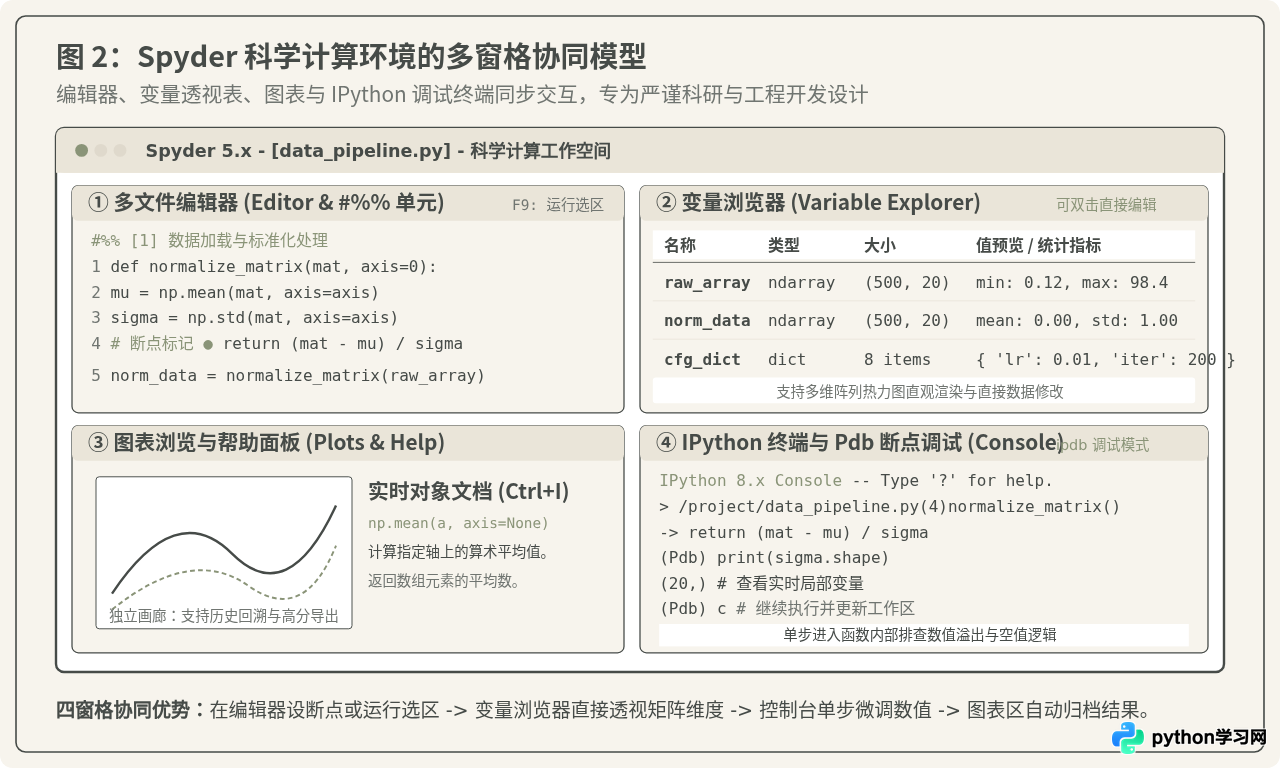
与 Jupyter 的网页单流排版不同,Spyder 打开即呈现典型的“多窗格协同”格局:左侧是多标签代码编辑器,右上是变量浏览器(Variable Explorer),右中是画廊式的图表浏览器与帮助文档查看器,右下则是原生的 IPython 交互终端。
2. 核心优势
- 强大的变量浏览器(Variable Explorer): 运行代码后,工作区内所有变量(DataFrame、Numpy 阵列、字典、标量)都会自动呈现在列表中。双击某个矩阵或表格,可直接弹出类似 Excel 的表格查看器,支持多维数组切片透视、数值热力高亮乃至就地修改数据,免去了在终端反复
print()的繁琐; - 完善的 Pdb 断点单步调试: 在编辑器行号旁点击即可下断点。按
Ctrl+F5启动调试后,程序会在断点处精确暂停,控制台切入ipdb提示符。你可以单步步入(Step Into)复杂函数内部,逐行审查张量维度的变化与极端空值,这是排查数学算法逻辑缺陷的核心利器; - 单行/选区执行(F9)与代码单元(#%%): 既支持常规运行整个
.py脚本,也支持选中几行按F9仅执行选中片段;在代码中写入#%%注释行,可将脚本划分为单元块,按Shift+Enter获得类似 Notebook 的分段执行体验,同时保持标准纯文本源码形式; - 纯正的工程与版本控制友好: 所有代码均为标准的
.py文件,无论是 Git diff、分支合并还是自动化测试,均能完美契合标准软件开发规范。
3. 局限性
Spyder 生成的静态图表通常集中收纳在右上方的 Plots 画廊中,无法像 Jupyter 一样将“图表紧贴在对应业务分析段落下”,因此在撰写对外汇报、数据故事或教学讲义时,直观感与表现力不及 Jupyter。
四、关键维度横向对比:从开发习惯到数据生命周期
1. 常见混淆观念深度辨析
说法辨析一“Jupyter 只是给新手做玩具展示用的,正规数据开发绝不用它?”
这种说法看似有道理,但结论过于偏颇。其合理之处在于:如果将成千上万行的数据清洗流水线、模型训练守护进程直接写在一个膨胀的 .ipynb 文件中,不仅维护困难、无法调试,还会引发前述的隐式状态错乱与代码复用危机。然而,在真实工业界与顶尖研究机构中,没有任何一位数据科学家会在一无所知的前提下直接在 .py 中写完整个数据管道。Jupyter 的核心价值在于低成本假设验证——利用它在几分钟内探明字段分布、筛选缺失特征,验证模型可行性后,再将稳定逻辑抽离封装。否定 Jupyter 就等于否定了数据科学中最核心的探索试错阶段。
说法辨析二“既然有了功能全面的 VS Code 或 PyCharm,Spyder 就完全没有存在必要了?”
这种观点忽视了科学计算领域开箱即用的专业专注性。VS Code 与 PyCharm 固然功能庞大,但它们面向的是通用软件开发。要在其中获得类似 Spyder 的科学计算体验,用户需要手动安装数十个插件、配置复杂的调试内核与变量视图拓展,且对多维数组的高性能表格透视依然不如 Spyder 顺手。Spyder 随着 Anaconda 开箱即用,免去繁杂配置,对于科研人员、金融量化分析师及高校师生而言,其专注科学计算的直觉交互具有不可替代的高效性。
2. 全维度对比分析表
| 对比维度 | Jupyter (Notebook / Lab) | Spyder (Scientific IDE) |
|---|---|---|
| 界面形态 | Web 浏览器端单列流式卡片,图文代码交织 | 经典桌面集成多窗格(编辑器、变量表、控制台) |
| 核心存储格式 | .ipynb(内嵌输出与元数据的 JSON 文档) |
标准 .py 纯 Python 源码文件 |
| 代码执行模式 | Cell 块状独立触发,支持非线性随意执行 | 整篇脚本运行、选区单行运行(F9)或 #%% 块运行 |
| 变量观测方式 | 通过代码显式打印 df.head() 或调用对象展示 |
右侧独立变量浏览器全局实时列出,双击弹出表格透视 |
| 调试能力 | 以 print() 打印为主,深层单步调试交互相对繁琐 |
原生集成 Pdb,直观支持图形断点、单步步入与调用栈追踪 |
| 版本管理(Git) | 冲突排查困难,需借助 nbdime 等专门工具 |
标准纯文本代码,Git diff/merge 顺畅优雅 |
| 典型交付物 | 业务分析报告、图文教案、EDA 探查汇报、HTML/PDF | 生产处理脚本、特征工程算法模块、自动化运维任务 |
五、从数据探索到工程落地的协同操作四步法
在成熟的数据分析项目中,最高效的策略决不是“非 Jupyter 即 Spyder”的二元对立,而是顺应数据处理的生命周期,将二者有机串联成标准化操作流程:
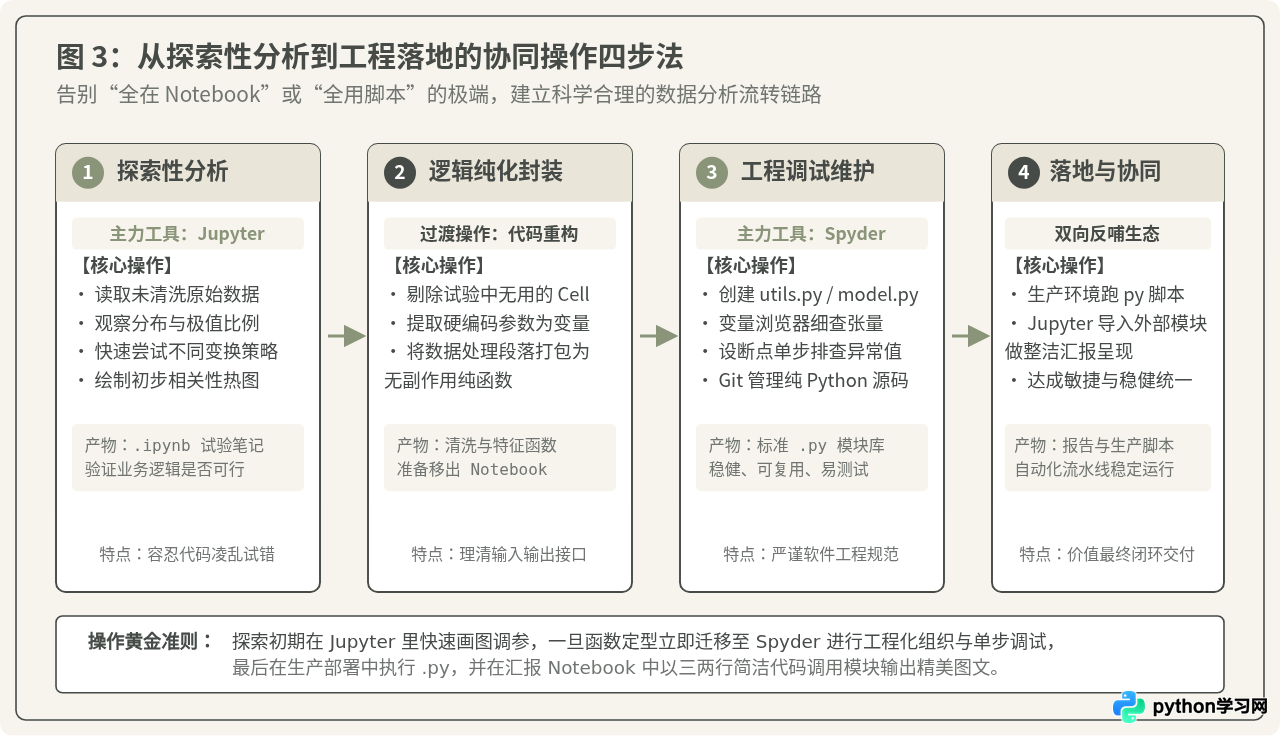
具体实操步骤与代码演进示例:
第一步:在 Jupyter 中进行轻量试探(EDA)
新建 exploration.ipynb,快速读取数据并画图,观察数据分布与异常:
# Jupyter Notebook 中快速试验
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("sales_data.csv")
# 快速剔除异常值并观察价格直方图
clean_df = df[df["price"] > 0].copy()
clean_df["log_price"] = clean_df["price"].apply(lambda x: pd.np.log(x))
plt.hist(clean_df["log_price"], bins=20)
plt.show()
第二步:抽离核心函数,消除隐式依赖
当特征变换逻辑在 Notebook 中验证有效后,梳理出纯粹的输入和输出,切断对 Notebook 全局变量的隐式依赖,整理出无副作用的独立函数。
第三步:在 Spyder 中建立模块工程并进行严谨断点调试
打开 Spyder,新建 data_pipeline.py,将清洗逻辑正规化,利用断点与变量浏览器验证边界条件:
# data_pipeline.py - 在 Spyder 中编写与单步调试
import numpy as np
import pandas as pd

def transform_sales_data(filepath: str) -> pd.DataFrame:
    """标准数据清洗与特征构建流水线"""
    raw = pd.read_csv(filepath)
    # 在此行左侧设置红色断点,审查异常负值
    valid_mask = raw["price"] > 0
    filtered = raw.loc[valid_mask].copy()
    filtered["log_price"] = np.log(filtered["price"])
    return filtered

if __name__ == "__main__":
    # 在 Spyder 控制台按 F5 运行测试
    result = transform_sales_data("sales_data.csv")
    print("处理完成,矩阵形状:", result.shape)
在 Spyder 的变量浏览器中双击 result,可立刻核实各列字段类型(dtype)与数值分布,排查潜在的 NaN 遗留。
第四步:在生产与汇报中双向反哺
调试稳健的 data_pipeline.py 既可直接作为生产环境的定时批处理脚本,也可以在最终面向业务汇报的 report.ipynb 中被干净导入:
# 在精简整洁的汇报 Notebook 中调用
%load_ext autoreload
%autoreload 2

from data_pipeline import transform_sales_data
df_clean = transform_sales_data("sales_data.csv")
# 仅保留核心图表与业务洞察结论,代码极为精炼
六、选型决策指南与高阶使用建议
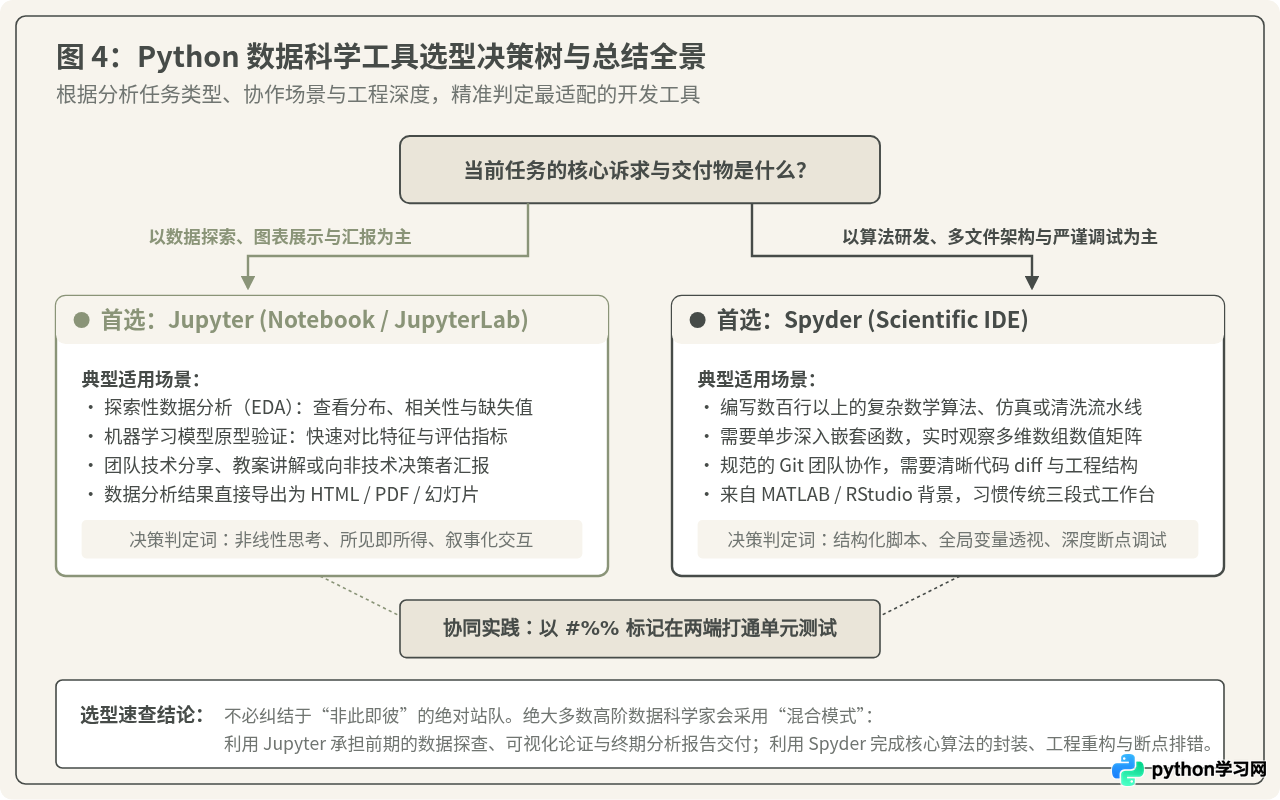
1. 选型决策准则
- 果断选择 Jupyter 的场景:
- 任务处于初始探索期,需要边写代码边看图表分布;
- 最终成果需要向非技术人员(产品经理、业务领导、客户)进行图文并茂的汇报;
- 进行机器学习 Baseline 快速打榜验证,需频繁尝试不同的特征工程小点子。
- 果断选择 Spyder 的场景:
- 算法涉及多维矩阵计算(如图像处理、物理模拟、金融因子工程),需要实时观察多维数组;
- 代码包含嵌套较深的循环或多层函数调用,需要进入内部单步排查
IndexError或溢出问题; - 项目以多个
.py模块组织,依赖严格的 Git 规范和持续集成; - 习惯于 MATLAB 或 RStudio 工作流,偏好在一个视窗内掌控一切系统状态。
2. 常见问题与避坑提醒
- 内存膨胀与释放: Jupyter 长时间运行大矩阵计算时,即使删除了单元格,被内核引用的变量也不会立即释放。若系统内存吃紧,应及时点击菜单栏的
Kernel -> Restart Kernel;在 Spyder 中,可随时在控制台输入%reset清空所有当前变量; - 避免 Notebook 乱序隐患: 在把
.ipynb分享给他人或归档前,务必执行一次Restart Kernel & Run All Cells,确认从第一行到最后一行能够无缝、顺次、报错为零地执行完毕; - Spyder 变量浏览器防卡顿: 当 DataFrame 包含数千万行数据时,双击展开可能造成界面短暂无响应。建议在 Spyder 首选项的
Variable Explorer中限制每次加载的最大行数(如默认的前 10000 行),或仅在控制台中使用切片查看。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









