

Python自定义函数常见报错:TypeError与NameError排查指南
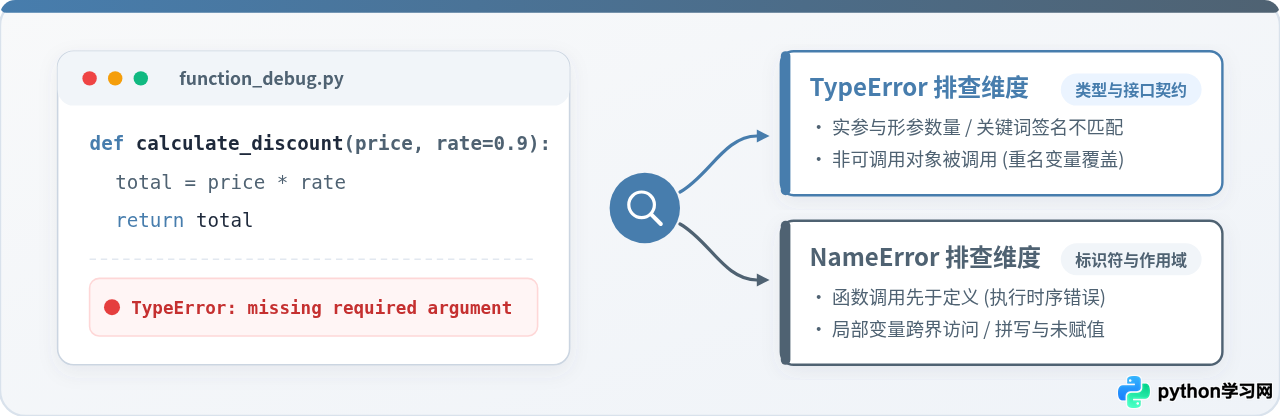
针对Python自定义函数中最常见的TypeError与NameError两类报错,本文系统讲解Traceback回溯阅读、形参实参绑定、LEGB作用域机制、常见代码陷阱与工程化防错自检清单。
TypeError(类型错误)与 NameError(名称错误)是控制台回溯信息(Traceback)中出现频次最高的两类运行时异常。简而言之,TypeError 意味着“解释器找到了对应的对象,但传入的参数规格、调用方式或内部运算类型与该对象的能力不匹配”;而 NameError 则代表“解释器在当前的局部、闭包、全局或内置作用域中,完全找不到该名称的任何定义”。掌握从 Traceback 逆向定位源头、核验实参与形参签名绑定、理解 LEGB 作用域检索机制,是快速排查并根除这两类故障的核心路径。
一、标准排查流:如何从 Traceback 精准锁定故障源头
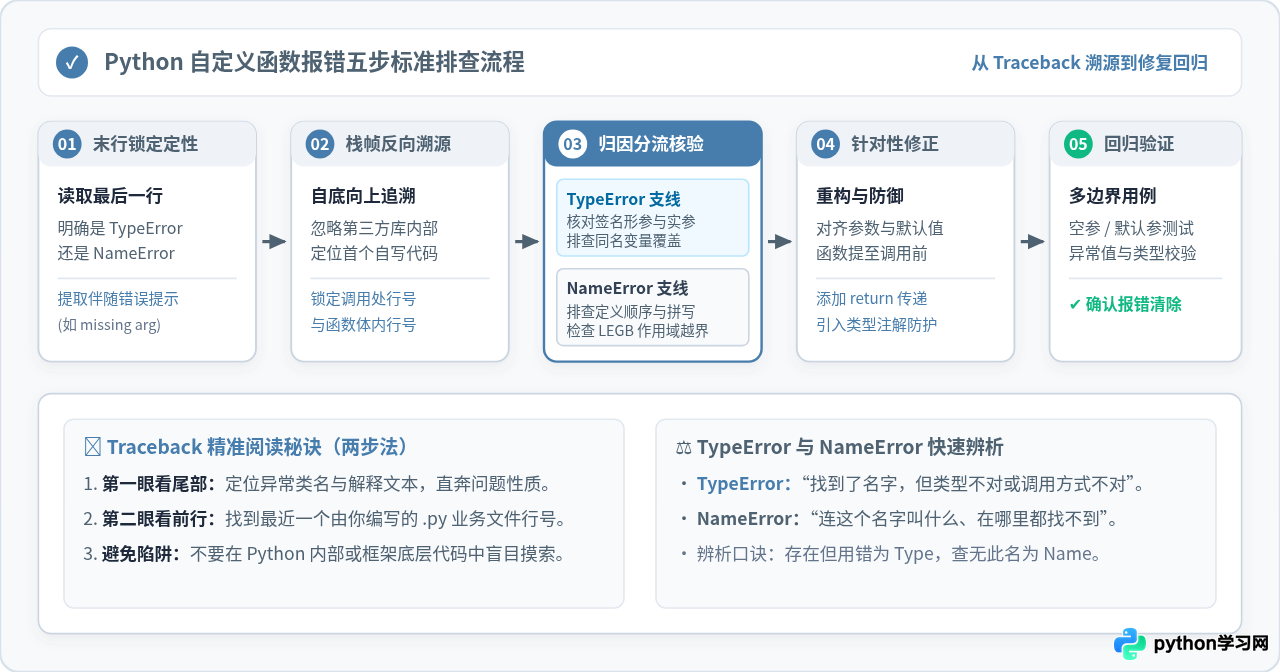
当 Python 脚本执行自定义函数崩溃时,终端会打印出一段完整的调用回溯(Traceback)。许多初学者容易被冗长繁杂的错误堆栈扰乱视线,甚至误入标准库源码中寻找原因。高效排查的第一原则是:从底部往顶部看(Bottom-Up)。
Traceback (most recent call last):
  File "app/main.py", line 42, in <module>
    render_report(user_id=101, format_type="pdf")
  File "app/services/report.py", line 18, in render_report
    content = format_content(template, user_id)
  File "app/services/formatter.py", line 7, in format_content
    return template + ": " + user_id
TypeError: can only concatenate str (not "int") to str
完整的诊断包含三个关键动作:
- 定性异常类型(最后一行):直接看 Traceback 的最后一行。在上述示例中,最后一行明确指出了
TypeError: can only concatenate str (not "int") to str,说明问题出在字符串与整数的直接加法操作上。 - 定位首个自写代码位置(由底向上倒查):倒数第二块指出行号在
formatter.py的第 7 行。如果是第三方库或标准库内部报错,请继续向上寻找最靠近底部的自写业务代码,因为根因往往是你在调用库函数时传递了错误的参数。 - 检查行内执行点:结合报错行中参与计算或调用的变量,检查传入该函数的实际参数值与期望的数据结构。
二、TypeError 深度排查:签名失配、不可调用与类型计算冲突
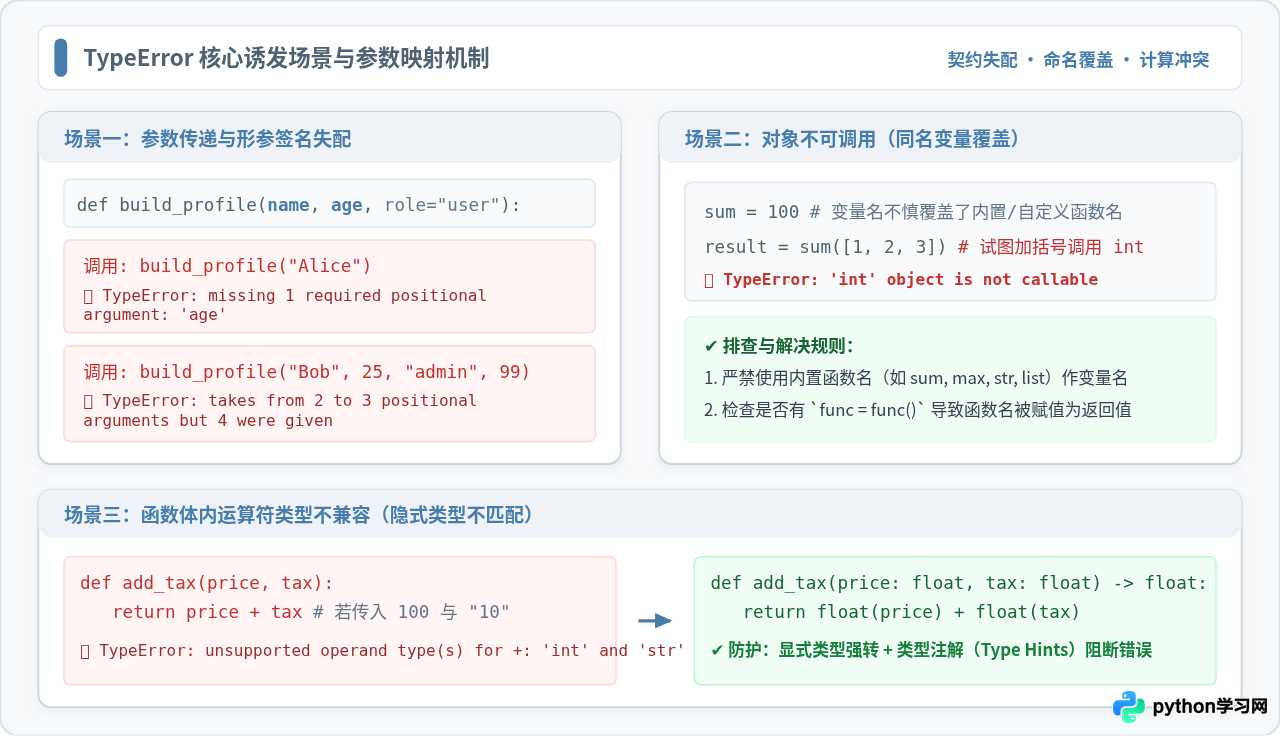
在自定义函数中,TypeError 通常集中在三个具体的代码场景中:传参与形参定义不匹配、函数名被覆盖导致对象不可调用,以及函数体内不同类型的数据发生了不支持的操作。
1. 参数数量与关键字匹配失配
Python 函数严格校验传入的参数与形参签名的对应关系。缺失必填的位置参数,或者传入了未在形参中声明的额外参数,都会抛出 TypeError。
def calculate_pay(hourly_rate, hours_worked):
    return hourly_rate * hours_worked

# 错误调用 1:缺少必需的位置参数
calculate_pay(50)
# 抛出: TypeError: calculate_pay() missing 1 required positional argument: 'hours_worked'

# 错误调用 2:传递了过多未知位置参数
calculate_pay(50, 40, 1.5)
# 抛出: TypeError: calculate_pay() takes 2 positional arguments but 3 were givendef calculate_pay(hourly_rate, hours_worked, overtime_multiplier=1.0);如果需要接收动态长度的参数,应在定义中加入 *args 或 **kwargs。
2. 对象不可调用:'xxx' object is not callable
当你在一个标识符后面加上圆括号 () 尝试发起函数调用时,Python 期望该对象具有 __call__ 方法。如果这个标识符被赋值为了整数、字符串或列表,就会抛出该错误。最常见的根因是:局部变量名与函数名同名,导致函数被同名变量覆盖,或者是覆盖了 Python 内置函数。
def get_total_score(scores):
    sum = 0  # 危险!局部变量名与内置函数 sum 冲突
    for s in scores:
        sum += s

    # 试图再次使用内置 sum 计算均值
    avg = sum(scores) / len(scores)  # 此时 sum 是 int 类型的 150,并非函数!
return avgTypeError: 'int' object is not callable。因为在当前局部作用域中,sum 已经是一个整数,圆括号调用触发了异常。
sum、max、min、list、str、type 等内置名字作为变量;同时检查代码中是否误写了 func = func(),导致函数对象被其返回值替换。
3. 函数体内的隐式类型运算冲突
Python 是强类型动态语言,不会对不相容的数据类型进行隐式强制转换。例如,当从网络接口、前端表单或命令行参数接收到字符串 "20" 并直接传入期望数值的函数中时,字符串与数值相加便会抛出 TypeError。
def compute_discount(price: float, discount_percent: float) -> float:
    # 防御性转换,确保参与算术运算的变量类型确凿
    p = float(price)
    d = float(discount_percent)
    if not (0.0 <= d <= 1.0):
        raise ValueError("折扣率必须在 0 到 1 之间")
    return round(p * (1.0 - d), 2)
三、NameError 深度排查:执行时序、作用域越界与未绑定局部变量
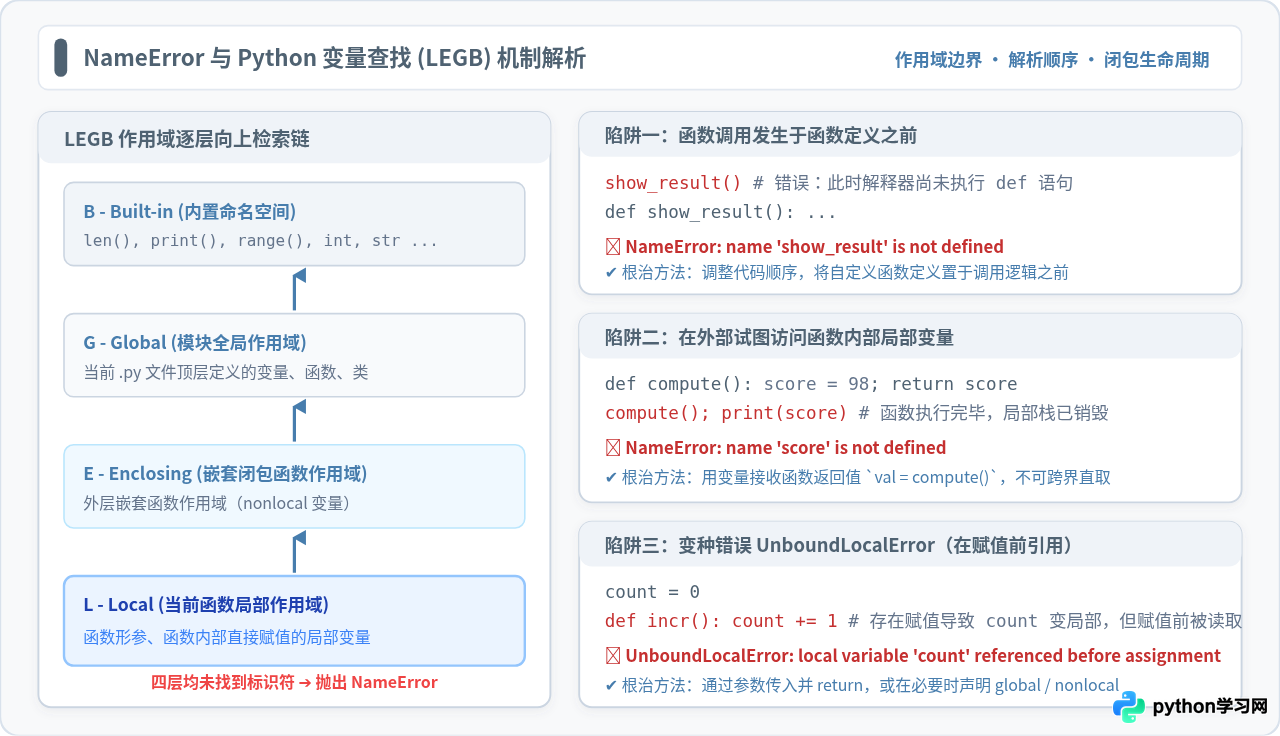
NameError 的本质是作用域检索失败。Python 按照 LEGB 规则(Local 局部 → Enclosing 闭包外层 → Global 全局模块 → Built-in 内置)自内向外逐层寻找标识符。如果查找完 Built-in 仍无该变量,便会立即抛出 NameError。
1. 函数调用发生于定义之前(解释执行时序)
与 C++ 或 Java 等经过完整编译再执行的语言不同,Python 脚本由解释器自上而下逐行解释。如果在 def 语句被解释器执行之前就调用了该函数,解释器在全局命名空间中尚未记录该函数名称。
# ❌ 错误做法:在定义之前调用
run_pipeline()  # NameError: name 'run_pipeline' is not defined

def run_pipeline():
    print("Pipeline executed.")

# -------------------------------------------------------------
# ✔ 规范做法:将执行逻辑收拢到模块入口保护块中
def run_pipeline():
    print("Pipeline executed.")

if __name__ == "__main__":
    run_pipeline()  # 此时 run_pipeline 已经由 def 成功注册
2. 局部变量越界:在函数外访问函数内部变量
在函数内部赋值创建的变量属于局部作用域(Local Scope)。当函数执行结束返回时,对应的函数调用栈帧(Frame)被销毁,其内部局部变量的生命周期随之结束。在函数外部直接引用该变量名必然引发 NameError。
def process_order(items):
    summary_count = len(items)  # 局部变量
    return summary_count > 0

process_order(["apple", "banana"])
print(summary_count) # ❌ NameError: name 'summary_count' is not definedreturn 返回给调用者,并在外部使用新的变量接收,例如 count = process_order(...);切勿依赖在外部直接读取函数内部的局部状态。
3. 经典陷阱:UnboundLocalError(在局部赋值前引用)
UnboundLocalError 是 NameError 的一个专门子类。许多开发者会困惑:为什么模块全局已经定义了该变量,函数内部仅仅读取一次就会报错?
retry_count = 3  # 全局变量

def try_request():
    if retry_count > 0:  # 报错发生在这行!
        print("Retrying...")
    retry_count = 0     # 关键原因:函数体内存在赋值语句!

try_request()UnboundLocalError: local variable 'retry_count' referenced before assignment。
底层机制:Python 在解析函数字节码时,只要发现函数体内任何地方存在对
retry_count 的赋值语句(retry_count = ...),就会在编译期将 retry_count 静态标记为该函数的局部变量。因此,在第一行 if retry_count > 0 执行时,解释器只在局部命名空间查找它,但此时尚未执行到赋值语句,因而抛出“赋值前引用”异常。
- 推荐方案(纯函数设计):将变量作为参数传入,计算后用
return传出,保持函数独立可测; - 次选方案(明确全局修改):如果确实需要就地修改全局状态,在函数第一行显式声明
global retry_count(若为嵌套函数则声明nonlocal)。
四、综合排查实战:一段典型混合报错代码的重构演练
以下提供一个模拟真实业务中处理用户订单运费计算的函数。该函数在初始运行时连续抛出 TypeError 与 NameError。我们将按照前文的标准流程对其进行分步排查与重构。
# 业务文件: shipping.py

# 初始调用(尝试计算重 5kg、VIP 用户、目标城市上海的运费)
fee = calculate_shipping(5, "VIP", city="Shanghai")

def calculate_shipping(weight, user_level, base_rate=15):
    if user_level == "VIP":
        discount = 0.8
    total_fee = base_rate + (weight * 2) * discount  # 普通用户会漏定义 discount
    return total_fee
第 1 次运行排查:解决 NameError 时序问题
直接执行上述脚本,终端抛出:NameError: name 'calculate_shipping' is not defined。
排查:Traceback 指向第一行 fee = calculate_shipping(...)。原因是调用发生在函数定义 def 之前。
修正:将函数定义移动到顶部,或将调用放入执行入口中。
第 2 次运行排查:解决 TypeError 签名冲突
调整顺序后再次执行,终端抛出:TypeError: calculate_shipping() got an unexpected keyword argument 'city'。
排查:函数签名只定义了 (weight, user_level, base_rate=15),调用方却传入了 city="Shanghai"。
修正:在形参中明确增加 city: str = "",或在末尾追加 **kwargs 吸收扩展关键字参数。
第 3 次运行排查:消除分支漏洞导致的 NameError
如果传入 user_level="Normal",代码不进入 if 分支,导致 discount 变量从未被赋值,在计算 total_fee 时抛出:UnboundLocalError: local variable 'discount' referenced before assignment。
修正:在分支前显式提供默认折扣率 discount = 1.0。
from typing import Optional

def calculate_shipping(
    weight: float,
    user_level: str = "Normal",
    base_rate: float = 15.0,
    city: Optional[str] = None,
    **extra_attrs
) -> float:
    """计算订单运费,具备严格的参数校验与类型安全保障。"""
    w = float(weight)
    b = float(base_rate)

    # 初始化局部默认值,杜绝分支漏赋引发的 NameError
    discount = 1.0
    if user_level.upper() == "VIP":
        discount = 0.8
    elif user_level.upper() == "SVIP":
        discount = 0.6

    final_fee = (b + (w * 2.0)) * discount
    return round(final_fee, 2)

if __name__ == "__main__":
    # 验证测试用例
    print("VIP 运费:", calculate_shipping(5, "VIP", city="Shanghai"))    # 20.0
    print("普通运费:", calculate_shipping(5, "Normal", city="Beijing")) # 25.0
五、排查自检备忘录与工程化防范
排查报错是事后补救,建立工程化的编码规范则是从源头杜绝 TypeError 与 NameError 的长效机制。下表与自检图总结了日常开发的核心排查对照法则:
| 报错类型 | 典型错误文案 | 排查着手点 | 标准修复动作 |
|---|---|---|---|
| TypeError | missing X required positional argument | 调用处实参数量 < 函数必填形参数量 | 补齐实参,或在定义中为形参提供默认值 |
| TypeError | takes X positional arguments but Y were given | 调用处实参数量 > 函数允许的形参数量 | 精简多余实参,或形参中追加 *args |
| TypeError | 'xxx' object is not callable | 函数名被同名变量覆盖,或多写了括号 | 重命名覆盖变量,避免使用内置函数同名 |
| NameError | name 'xxx' is not defined | 调用在定义前 / 标识符拼写错误 | 调整 def 顺序至调用前,核对变量名拼写 |
| NameError | name 'xxx' is not defined (跨界) | 试图在函数外读取内部局部变量 | 函数使用 return 传出,外部变量接收 |
| UnboundLocal | local variable referenced before assignment | 函数内部存在赋值,但在赋值语句前读取 | 通过形参传值并 return,或声明 global |
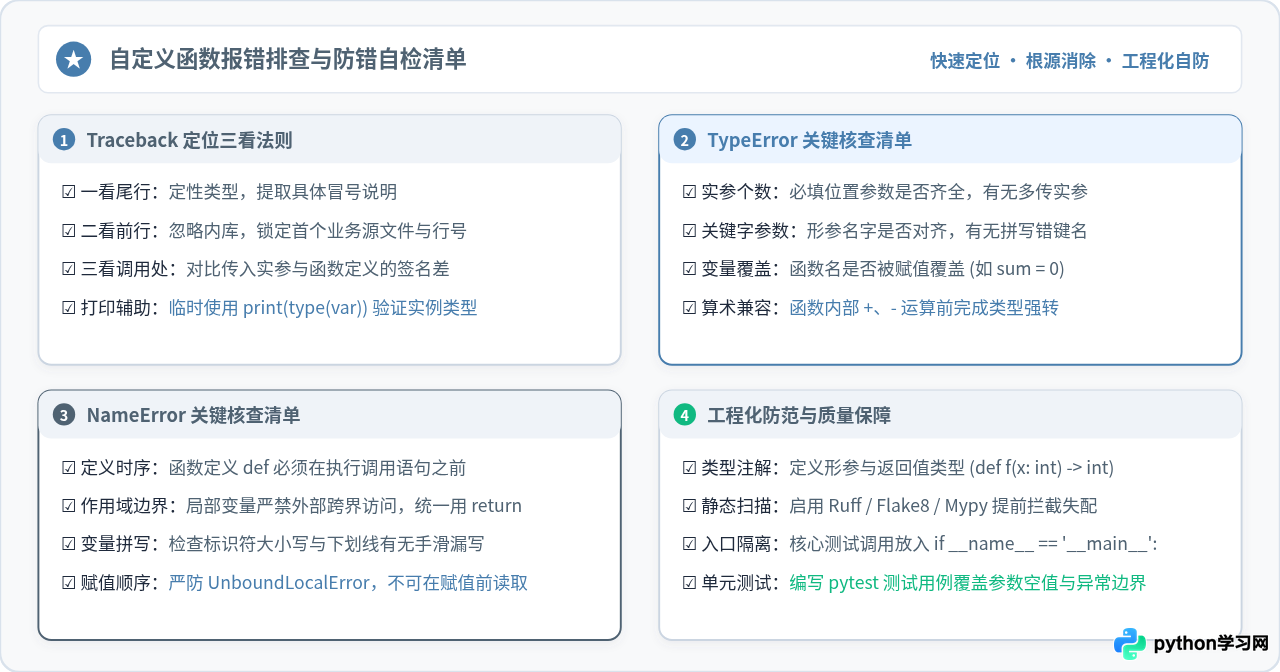
在日常开发工具链中,建议落实以下三项工程化措施:
- 善用静态类型检查(Type Hints & Mypy):为所有自定义函数添加形参和返回值类型注解,在编写阶段即可通过 IDE 发现参数不匹配问题。
- 配置 Linter 实时语法检查(Ruff / Flake8):现代代码检查工具能够在保存代码时自动标红未定义的变量(捕捉 NameError)以及同名覆盖内置函数的行为。
- 编写单元测试(Pytest):针对每个自定义函数编写包含零参数、边界值、非法类型参数的测试用例,将报错拦截在上线运行之前。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









