

Python字典是什么:dict键值对结构与创建方法
深入解析Python字典(dict)的底层映射结构与哈希原理,系统梳理字面量、构造函数、批量初始化、推导式与现代合并等5大创建方法及实战避坑指南。
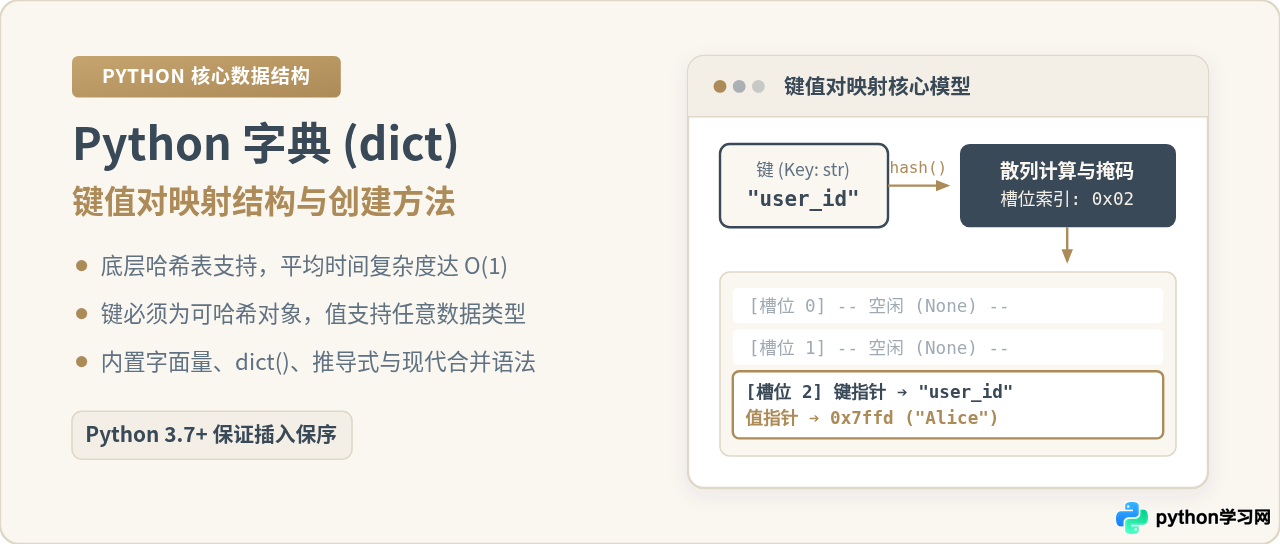
dict)是 Python 内置的可变映射型数据结构,它通过成对的“键-值”(Key-Value)形式组织与管理数据。与依赖连续递增整数索引的列表不同,字典以具有业务含义的“键”作为定位锚点,在底层依托哈希表(Hash Table)实现,提供平均 O(1) 时间复杂度的快速检索、新增与删除性能;自 Python 3.7 起,字典在语言规范层面严格保证键值对的插入顺序。
一、字典的核心结构与工作逻辑
在日常开发中,若使用列表存储一组用户信息(如 ["Alice", 28, "Engineer"]),程序必须硬编码记住“下标 0 是姓名、下标 1 是年龄、下标 2 是岗位”。这种对位置强依赖的存储方式不仅可读性差,而且在列表项增减时极易发生位置偏移错误。字典正是为了解决这一痛点而设计的映射容器。
1. 键值对映射的本质
字典的每一个元素都由一对用冒号分隔的数据构成,左侧为键(Key),右侧为值(Value)。访问字典数据时,直接通过键名访问对应的值,建立起明确的关联映射:
# 定义用户信息字典
user_profile = {
    "username": "Alice",
    "age": 28,
    "role": "Engineer"
}

# 按键检索值
print(user_profile["username"])  # 不需要关心内部存储位置
print(user_profile["role"])Engineer
2. 键的硬性约束:必须是可哈希(Hashable)对象
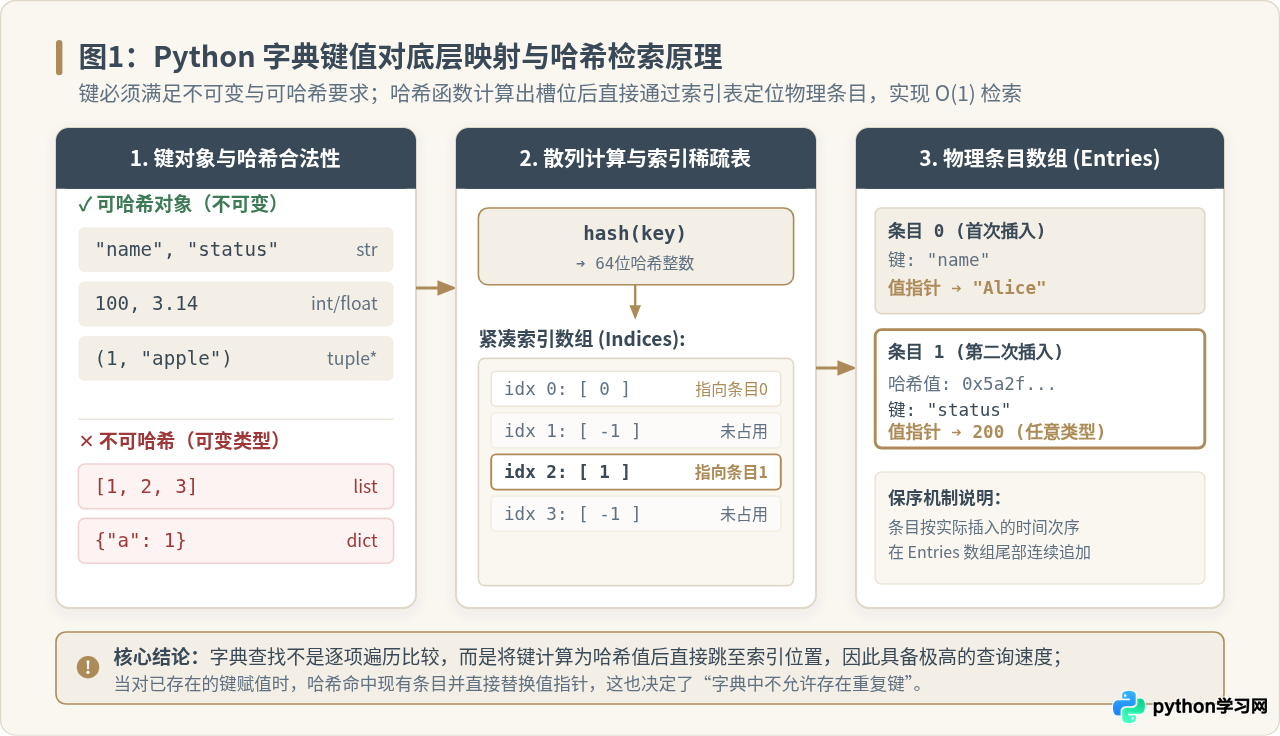
字典能在海量数据中实现瞬间定位,核心在于其底层的散列机制。这给字典的“键”带来了一条绝对的规则:字典的键必须是可哈希的对象。在 Python 中,一个对象如果是可哈希的,必须满足两个前提:
- 在其整个生命周期中,该对象的哈希值(由内置函数
hash(obj)计算)必须保持恒定不可变; - 该对象支持通过
__eq__()方法与其它对象比较等值性。
因此,Python 中的所有不可变数据类型(如字符串 str、整型与浮点型 int / float、布尔型 bool、仅包含不可变元素的元组 tuple、冻结集合 frozenset)都可以作为合法的键;而所有可变数据类型(如列表 list、字典 dict、集合 set)均不可作为键,若强行使用将抛出 TypeError: unhashable type 异常。
假设允许使用列表 k = [1, 2] 作为键存入字典,此时字典根据 hash([1, 2]) 计算出槽位并将数据放入;若随后执行 k.append(3),键的内容发生改变,再计算 hash(k) 时将得到一个完全不同的槽位编号。此时字典在原来的槽位找不到它,在新的槽位也没有记录,整个哈希寻址体系将彻底混乱。
3. 值的完全自由度
与键的严苛约束形成鲜明对比,字典的值(Value)没有任何限制。值可以是任意类型的 Python 对象:标量数值、长文本、列表、嵌套字典、函数、类实例乃至 None;同时,不同键对应的值完全允许重复。
4. 现代紧凑哈希表与保序特性
自 Python 3.6 引入并在 Python 3.7 成为语言正式标准的实现中,CPython 对字典底层进行了重大重构(Compact Dict 架构):
- 将原本稀疏的哈希槽表拆分为两部分:一个紧凑稀疏的索引数组(Indices Table),和一个连续分配的条目数组(Entries Array);
- 新加入的键值对依次连续追加到
Entries数组末尾,内存占用相比旧版降低约 20%~25%; - 由于
Entries数组是按时间次序连续追加的,遍历字典时按Entries数组顺序进行,因而自然保证了插入顺序(Insertion-Ordered)。
二、从零开始:字典的基础创建方式
在 Python 中,根据数据来源的不同(静态定义、动态参数、平行序列转换等),开发者可以选择多种清晰且语义明确的创建方式。
1. 方式一:花括号 {} 字面量声明(最常用、执行最快)
这是最符合 Python 习惯且执行效率最高的方式。在源码解析时,Python 字节码直接发射 BUILD_MAP 指令快速构建字典,不需要经过额外的函数查找与调用栈开销。
# 1. 创建空字典
empty_dict = {}

# 2. 声明带初始数据的字典(推荐在冒号后留空格,多行书写时在末尾保留逗号)
server_config = {
    "host": "127.0.0.1",
    "port": 8080,
    "enable_ssl": True,
    "max_workers": 4,
}
2. 方式二:dict() 构造函数传参
内置的 dict() 构造器提供了极高的灵活性,适用于动态传参和不同数据形态的转换:
形态 A:关键字参数(Keyword Arguments)
当键均为符合 Python 变量命名规则的普通字符串时,可以直接通过函数传参的方式定义:
user = dict(name="Bob", age=25, country="CN")
print(user)
# 注意:键名不能写成带有连字符或空格的形式,例如 dict(user-id=101) 会报语法错误形态 B:映射二元元组序列(Key-Value 2-tuples)
当数据来源于数据库查询结果、CSV 读取或文件解析出的元组列表时,可直接传入 dict():
raw_records = [("id", 1001), ("status", "success"), ("latency", 42)]
result_dict = dict(raw_records)
print(result_dict)形态 C:结合 zip() 组合两个平行列表
在数据清洗与批处理中,常见“表头列表”与“数据值列表”相互分离的情形,利用 zip() 可以将其缝合为字典:
headers = ["uid", "score", "grade"]
row_data = [2048, 98.5, "A+"]

student_record = dict(zip(headers, row_data))
print(student_record)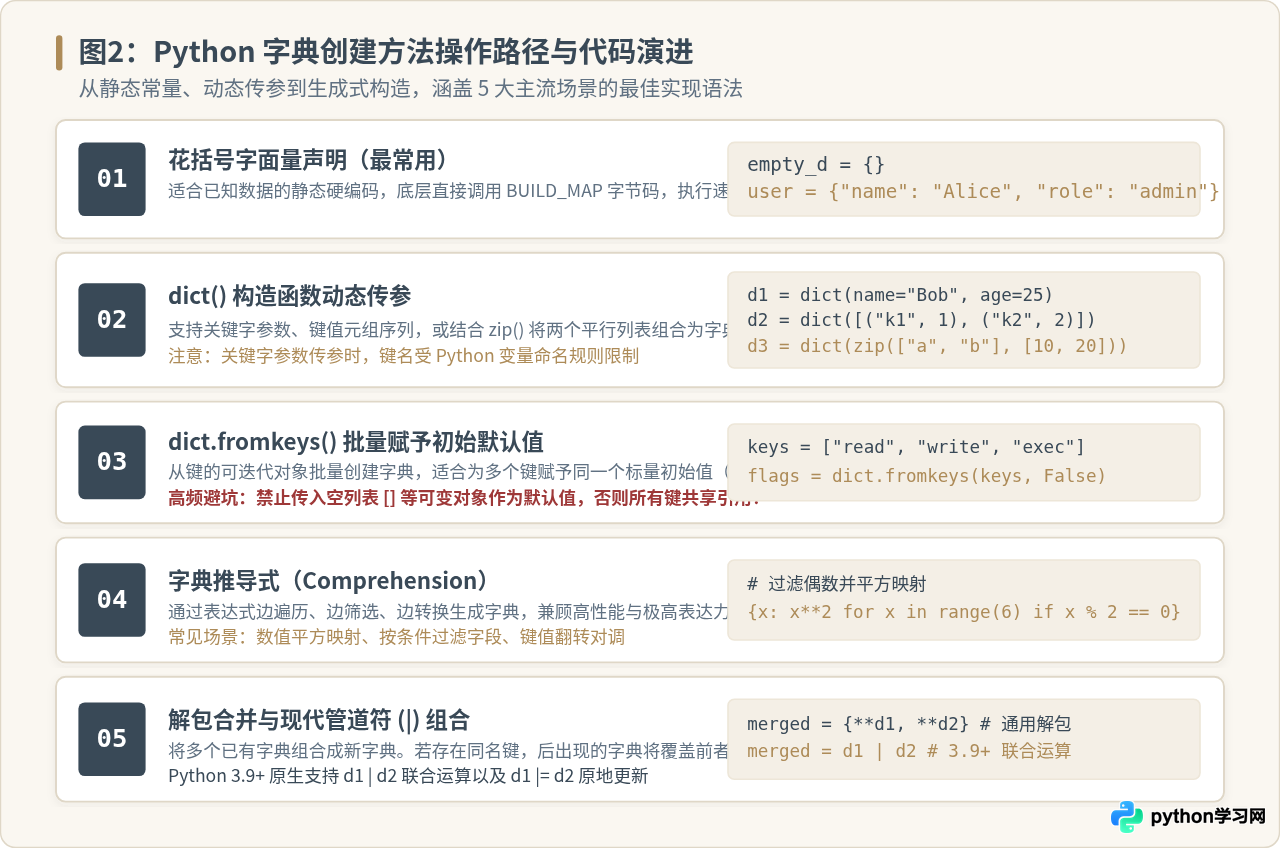
三、高效进阶:批量初始化、推导式与现代合并
掌握基础创建之后,在复杂工程与数据转换场景中,以下进阶创建技术能够让代码兼具优雅度与执行效率。
1. 方式三:dict.fromkeys() 批量初始化默认值
当需要为一组已知键赋予统一的初始占位值(如状态计数清零、重置标志位)时,dict.fromkeys() 能够一次性生成:
permission_keys = ["can_read", "can_write", "can_delete"]

# 为所有键赋予默认布尔值 False
user_perms = dict.fromkeys(permission_keys, False)
print(user_perms)dict.fromkeys(keys, default) 会将同一个 default 对象的引用赋给所有键。如果 default 是像 [](空列表)或 {}(空字典)这样的可变对象,所有键将共享同一块物理内存:
# 错误做法:共享同一列表
bad_dict = dict.fromkeys(["class_A", "class_B"], [])
bad_dict["class_A"].append("Tom")
print(bad_dict)  # class_B 里面居然也出现了 "Tom"!

# 正确做法:使用字典推导式每次实例化新列表
safe_dict = {k: [] for k in ["class_A", "class_B"]}
safe_dict["class_A"].append("Tom")
print(safe_dict) # 仅 class_A 包含 "Tom",class_B 依旧为空safe_dict: {'class_A': ['Tom'], 'class_B': []}
2. 方式四:字典推导式(Dictionary Comprehension)
字典推导式是 Python 中最具生产力的高级特性之一。它允许在遍历可迭代对象的过程中,同步完成条件过滤、键值计算或结构重塑:
# 模式 1:数值计算与条件筛选(仅针对偶数计算立方)
cubes = {x: x**3 for x in range(1, 7) if x % 2 == 0}
print("偶数立方:", cubes)

# 模式 2:清洗字符串字典(键转小写、去除首尾空格)
raw_payload = {" USER_NAME ": " Alice ", " STATUS ": " ACTIVE "}
cleaned = {k.strip().lower(): v.strip() for k, v in raw_payload.items()}
print("清洗后数据:", cleaned)

# 模式 3:键值对反转(要求原字典的值必须唯一且可哈希)
id_to_name = {101: "Alice", 102: "Bob", 103: "Charlie"}
name_to_id = {name: uid for uid, name in id_to_name.items()}
print("反向查找字典:", name_to_id)清洗后数据: {'user_name': 'Alice', 'status': 'ACTIVE'}
反向查找字典: {'Alice': 101, 'Bob': 102, 'Charlie': 103}
3. 方式五:解包合并与管道符运算符(Python 3.9+)
在工程项目中,配置继承、默认参数覆盖是高频需求。现代 Python 提供了极为自然的合并语法:
default_cfg = {"timeout": 30, "retry": 3, "debug": False}
custom_cfg = {"debug": True, "ip": "10.0.0.1"}

# 语法 A:通用双星号解包语法(Python 3.5+)
merged_a = {**default_cfg, **custom_cfg}

# 语法 B:管道符联合运算符(Python 3.9+ 推荐做法)
merged_b = default_cfg | custom_cfg
print("合并结果:", merged_b)

# 语法 C:就地合并更新(等价于 default_cfg.update(custom_cfg))
default_cfg |= custom_cfg
四、关键规则与使用避坑指南
深入理解字典的工作机制不仅有助于正确编写创建语句,更能有效规避线上常见的异常陷阱。
1. 键重复的静默覆盖行为
字典的键具有全局唯一性。如果在创建或连续赋值时出现了相同的键,Python 不会报错,而是由后出现的键值无声覆盖先出现的旧值:
# 重复键赋值:后者覆盖前者
d = {"a": 1, "b": 2, "a": 99}
print(d)  # 结果中只保留 "a": 99

# 隐蔽陷阱:1 与 True、1.0 在 Python 中哈希值相等且等值比较成立!
weird_dict = {1: "整数一", 1.0: "浮点一", True: "布尔真"}
print(weird_dict) # 仅剩一个键,值被最后的赋值覆盖{1: '布尔真'}
2. 避免 KeyError:安全取值与兜底机制
使用方括号下标访问字典(如 d[key])时,一旦键不存在,解释器会立即中断并抛出 KeyError。在生产代码中,应针对不确定存在的键采用安全防护措施:
dict.get(key, default):键存在则返回值;键缺失则返回预设的default(若未指定则返回None),不会引发程序崩溃;dict.setdefault(key, default):键存在则返回值;若不存在,则将default写入字典作为该键的值并返回,常用于数据分组;- 前置成员判断
in:通过if key in d:进行判断(其底层时间复杂度同样是 $O(1)$,切忌书写成低效的if key in d.keys():)。
3. 遍历时修改字典尺寸引发的 RuntimeError
一个经典的新手陷阱是在 for 循环遍历字典的同时,在循环体中执行 del d[k] 或 d.pop(k) 删除元素:
scores = {"math": 95, "pe": 40, "art": 82}

# 错误演示(引发 RuntimeError: dictionary changed size during iteration)
# for subject, score in scores.items():
#     if score < 60:
#         del scores[subject]

# 规范解法 A:使用静态列表快照隔离开迭代器与字典
for subject in list(scores.keys()):
    if scores[subject] < 60:
        del scores[subject]
print("解法A清理后:", scores)

# 规范解法 B:使用推导式直接构建符合条件的新字典
filtered_scores = {k: v for k, v in scores.items() if v >= 60}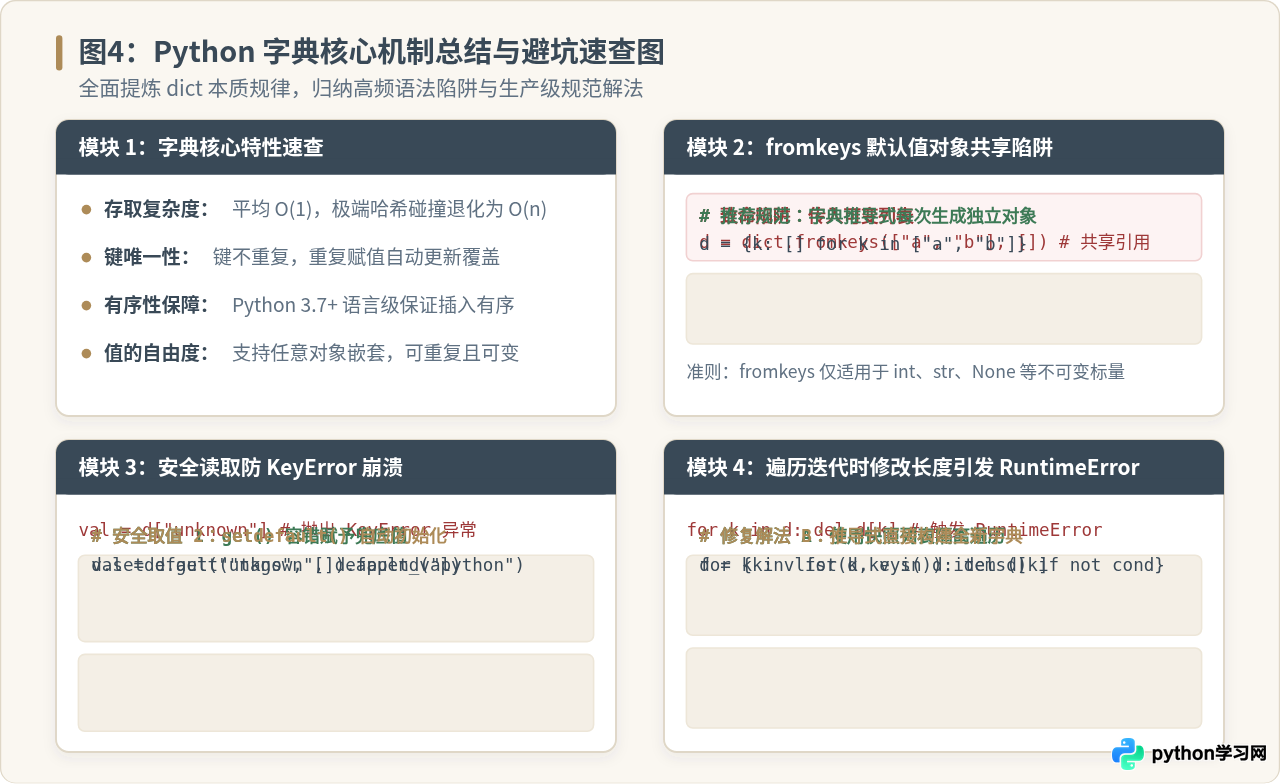
总结:常用创建方式快速选型对比
| 创建方式 | 典型语法形式 | 适用场景 | 关键注意事项 |
|---|---|---|---|
| 花括号字面量 | {"k": "v"} |
静态已知少量键值对 | 推荐 执行性能最优(底层发射 BUILD_MAP) |
| dict() 关键字 | dict(a=1, b=2) |
参数化动态传值 | 注意 键名必须为合法 Python 变量标识符 |
| dict(zip()) | dict(zip(keys, vals)) |
对齐的平行列表合并 | 高效 快速将表头和行数据拼合为键值对 |
| dict.fromkeys() | dict.fromkeys(keys, 0) |
批量初始化同一默认值 | 避坑 绝不能传入可变对象(如 [])作为默认值 |
| 字典推导式 | {k: v for ... in ...} |
转换、清洗、过滤现有序列 | 强大 兼具极高可读性与原生执行性能 |
| 现代合并 (|) | d1 | d2 (Python 3.9+) |
多个字典合流或覆盖默认配置 | 现代 右操作数拥有更高优先级,同名键被覆盖 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









