

Python @符号怎么用:手写一个简单的修饰器教程
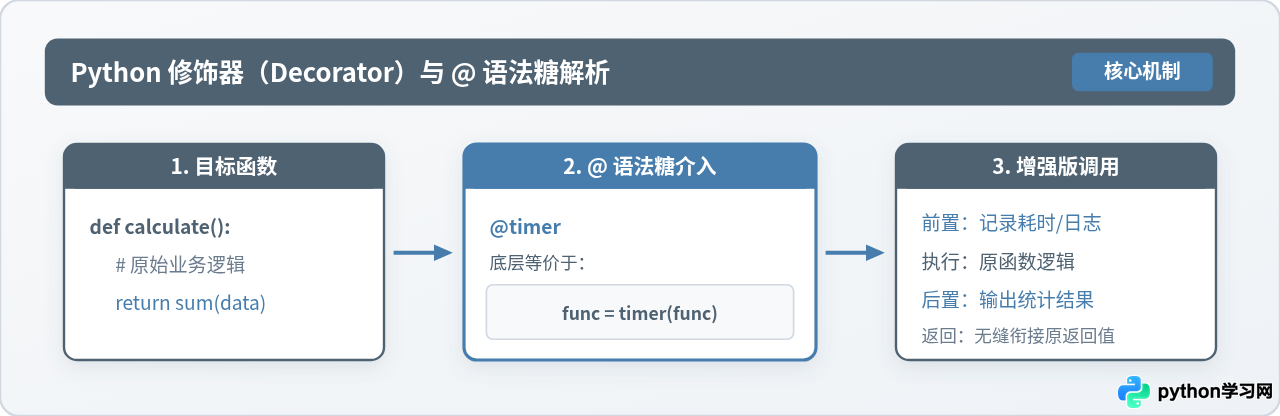
本教程深入讲解Python中@符号的语法糖本质与底层运行机制,通过手写一个完整的函数执行耗时统计修饰器,一步步演示包装函数、参数透传、返回值保留与元数据保护的具体写法。
@ 符号被称为“修饰器”(Decorator)语法糖。它的核心本质是一个以函数作为输入并返回新函数的对象。本文将直接带你了解 @ 的底层代换逻辑,并通过手写一个用于统计执行耗时的简单修饰器,一步步解决入参支持、返回值穿透以及元数据保留等核心问题。
一、理解 @ 符号的本质:它只是一种语法糖
很多初学者看到 @ 符号会觉得它带有一种“黑魔法”色彩,以为它改变了 Python 函数的编译机制。事实上,@ 没有任何神秘之处,它完全是一种为了提升代码可读性而设计的语法糖(Syntactic Sugar)。
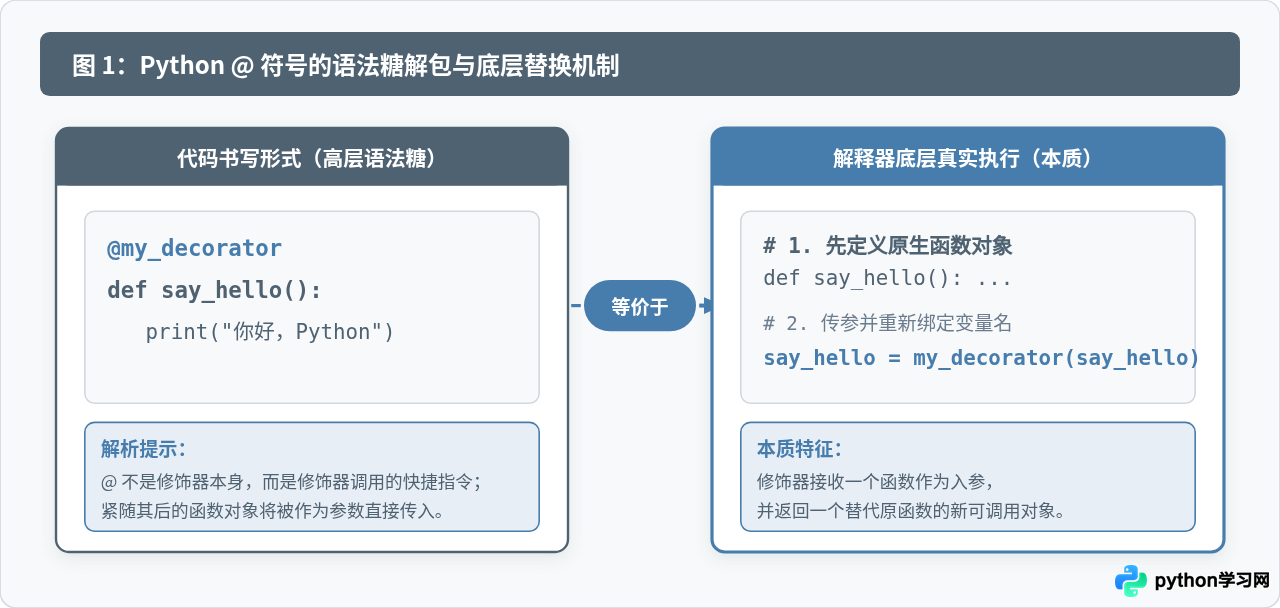
当你在一个函数定义上方写下 @my_decorator 时,Python 解释器在加载该函数时,会且仅会执行一行等价替换:
# 当你写下:
@my_decorator
def target_function():
    pass

# Python 解释器在底层自动执行的操作:
target_function = my_decorator(target_function)
从等价式可以看出,修饰器必须满足两个基本条件:
- 它是一个可调用对象(最常见的就是普通函数),能够接收一个函数对象作为参数。
- 它执行后必须返回一个可调用对象,用来替换原来的函数名引用。
二、从零手写一个计时修饰器(4 个核心步骤)
为了直观掌握修饰器的编写模式,我们以开发一个实用的“代码运行耗时统计工具”为例。我们的目标是:在不修改原业务函数任何内部代码的情况下,每次调用该函数都能自动计算并打印其执行耗时。
本示例基于标准 Python 3 环境(Python 3.6+ 均可),仅需导入标准库内置的 time 模块,无需安装任何第三方库。
第 1 步:定义外层修饰器函数
外层函数负责接收需要被增强的目标函数对象。我们将其命名为 timer,形参通常命名为 func:
import time

def timer(func):
    # func 是传入的原函数对象引用
    pass
第 2 步:在内部嵌套定义包装函数 wrapper
外层函数内部需要定义一个新函数(通常习惯命名为 wrapper,意为“包装纸”)。这个函数将成为后续用户调用时真正执行的实体:
def timer(func):
    def wrapper():
        # 将在这里执行附加操作和原函数
        pass
    return wrapper  # 注意:返回函数对象本身,不要加括号!
第 3 步:在 wrapper 内部植入增强行为与原函数调用
在 wrapper 内部,我们记录执行前时间戳,调用 func() 执行原逻辑,再记录执行后时间戳,最后输出耗时差值:
def timer(func):
    def wrapper():
        start_time = time.time()       # 1. 前置动作:记录起始时间
        func()                         # 2. 执行原函数
        end_time = time.time()         # 3. 后置动作:记录结束时间
        print(f"[耗时统计] {func.__name__} 执行耗时: {end_time - start_time:.4f} 秒")
    return wrapper
第 4 步:使用 @ 符号应用修饰器并测试
编写一个模拟耗时计算的简单函数,并在其上方加上 @timer:
@timer
def do_heavy_work():
    print("正在执行数据密集型计算...")
    time.sleep(1.2)
    print("计算完成。")

# 正常调用函数
do_heavy_work()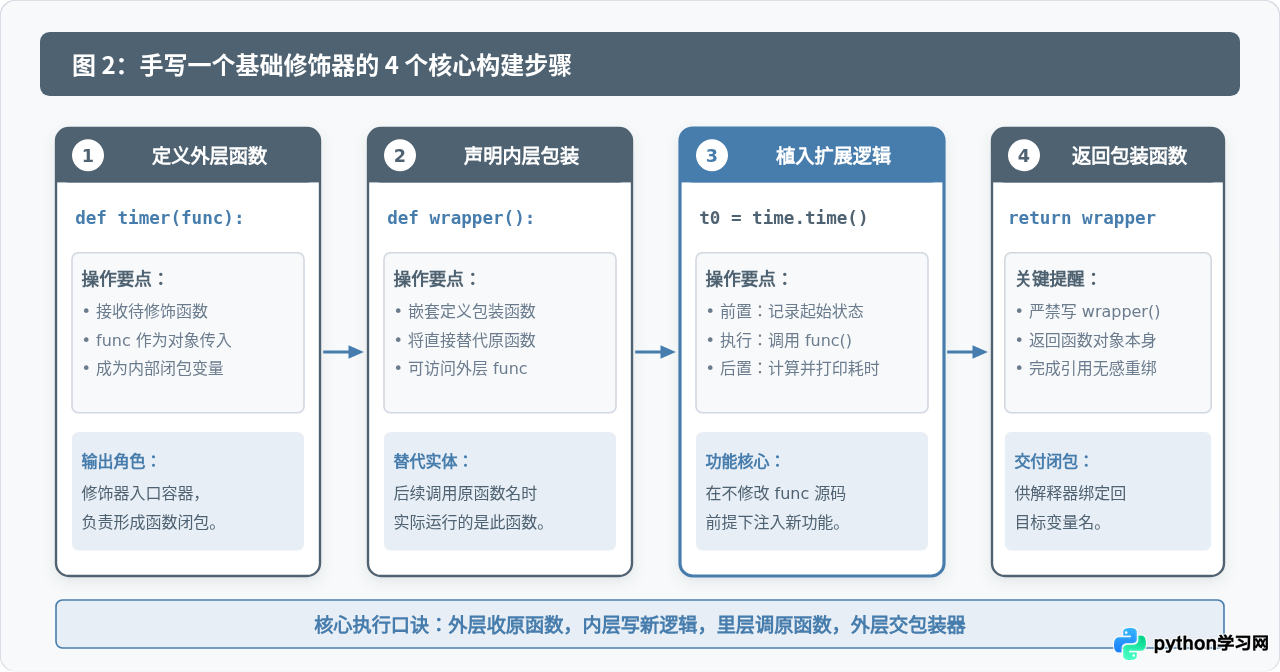
三、关键进阶:支持任意参数与保证返回值完整
上一节实现的 timer 存在两个显著局限:
- 不能传参:若原函数需要入参(例如
add(a, b)),直接调用会触发TypeError: timer.<locals>.wrapper() takes 0 positional arguments but 2 were given。 - 丢失返回值:若原函数有
return结果,wrapper没有接收并返回它,调用方将始终得到None。
1. 使用 *args 与 **kwargs 透传任意参数
为了让修饰器具有通用性,wrapper 函数必须能够接纳任何形式的参数输入。在 Python 中,通过在形参中声明 *args(接收任意数量的位置参数)与 **kwargs(接收任意数量的关键字参数),并在内部调用 func(*args, **kwargs) 进行原样解包,即可实现完美的参数穿透。
2. 捕获并原样返回结果
执行 result = func(*args, **kwargs) 后,在打印完耗时日志的最末尾,显式执行 return result。
升级后的通用工业级修饰器完整代码如下:
import time

def timer(func):
    def wrapper(*args, **kwargs):
        start_time = time.time()
        # 1. 显式接收原函数返回值
        result = func(*args, **kwargs)
        end_time = time.time()
        print(f"[耗时统计] {func.__name__} 执行耗时: {end_time - start_time:.4f} 秒")
        # 2. 将结果原封不动返回给外部调用者
        return result
    return wrapper
我们用带参数和返回值的函数进行验证:
@timer
def calculate_sum(limit):
    print(f"正在计算 0 到 {limit} 的累加和...")
    total = sum(range(limit))
    return total

val = calculate_sum(5000000)
print(f"最终计算结果: {val}")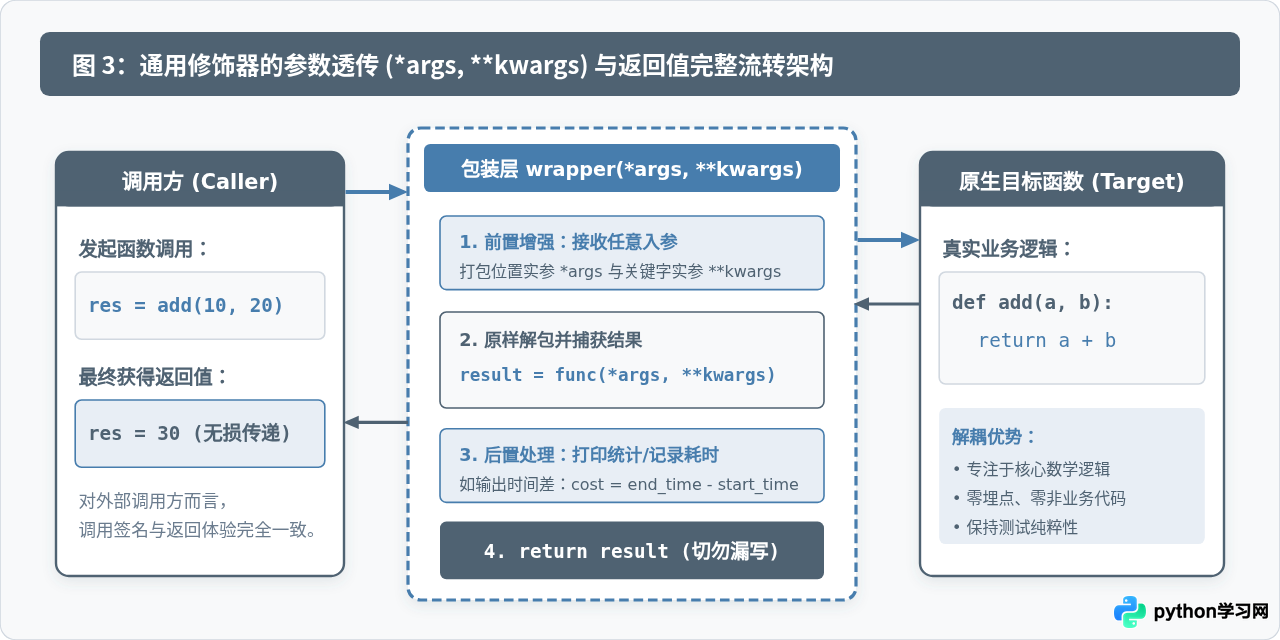
四、容易忽略的细节:使用 @functools.wraps 保护元数据
虽然上述代码运行良好,但如果打印函数的元信息(如名称 __name__ 或文档字符串 __doc__),就会发现端倪:
print(calculate_sum.__name__)
# 输出结果是:'wrapper',而不是 'calculate_sum'!
这是因为此时变量名 calculate_sum 实际指向的是修饰器内返回的 wrapper 函数对象。这会在以下场景引发问题:
- 日志排查时函数名全部显示为
wrapper,增加排错定位难度; - 自动化文档工具(如 Sphinx)无法提取原函数的 Docstring;
- 依赖函数反射或签名的 Web 框架(如 FastAPI、Flask)可能无法正确解析路由依赖。
解决方案:引入 @functools.wraps
Python 标准库的 functools 模块提供了专为修饰器定制的内置修饰器 @wraps。只要把它修饰在 wrapper 函数上方,它就会自动将 func 的 __name__、__doc__、__annotations__ 等元属性复制给 wrapper:
import time
from functools import wraps

def timer(func):
    @wraps(func)  # 保留原函数的签名与元信息
    def wrapper(*args, **kwargs):
        start_time = time.time()
        result = func(*args, **kwargs)
        end_time = time.time()
        print(f"[耗时统计] {func.__name__} 执行耗时: {end_time - start_time:.4f} 秒")
        return result
    return wrapper
再次检查 calculate_sum.__name__,输出即可正确恢复为 calculate_sum。
五、修饰器核心规则与常见疑问总结
1. 修饰器究竟在什么时候执行?
很多开发者误以为修饰器是在函数被调用时执行的。实际上,修饰器在模块加载(即 Python 解释器首次读取并定义该函数)时就会立即执行,此时已经完成了替换;只有 wrapper 内部的代码才是在每次函数真正被调用时运行的。
2. 多个修饰器同时修饰时的顺序是怎样的?
当一个函数上方同时堆叠多个修饰器时,装配顺序是由内而外(自底向上),而调用执行时的前置逻辑则是由外而内(自顶向下):
@decorator_a
@decorator_b
def func():
    pass

# 底层等价于:
func = decorator_a(decorator_b(func))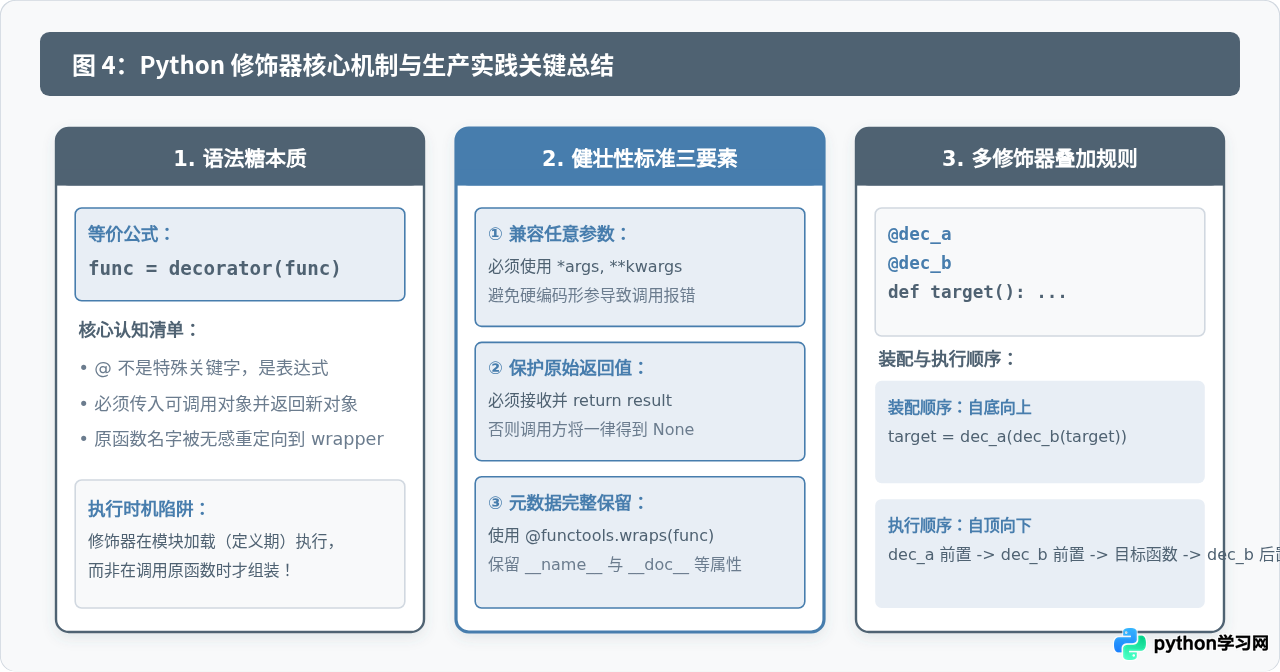
| 关键要素 | 标准做法 | 漏写或不当做法的后果 |
|---|---|---|
| 返回包装器 | 外层返回 return wrapper(不带括号) |
若写成 return wrapper(),会在加载期提前执行函数,且变量绑定为函数执行返回值而非可调用对象 |
| 参数兼容 | 形参定义 *args, **kwargs |
只要原函数带有形参,调用时立即报 TypeError |
| 返回值传递 | result = func(...) 并 return result |
调用方拿不到函数原本的返回值,统一变为 None |
| 元数据维护 | 在 wrapper 上添加 @wraps(func) |
函数的 __name__ 变为 'wrapper',文档注释丢失,影响反射和调试 |
掌握了 @ 的代换本质以及这四个核心编写要素后,无论是编写日志追踪、权限校验、缓存机制还是重试逻辑,修饰器的实现结构都是完全相通的。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









