

为什么数据分析首选Python?对比Excel与SQL看核心优势
深入对比Python、Excel与SQL在数据量级、处理复杂度、自动化流水线与算法生态上的核心差异,解析为什么现代数据分析首选Python,并给出切实可行的高效协同工具链选型指南。
设想一个每个月末都会发生的业务场景:你需要从公司数仓中提取数千万条明细订单,与运营部门收集的几十份离线渠道登记表汇总对齐,剔除刷单离群样本后对缺失画像进行插补,接着进行多元回归与 A/B 测试效果评估,最后把各渠道净 ROI 与趋势图汇总成分发给各业务负责人的定期分析报告。
面对这个典型任务,Excel 常常在跨表 VLOOKUP 突破数十万行时出现无响应,面对超百万行直接撞上软件硬性上限;SQL 虽能以极高效率在数据库集群内完成海量记录的检索过滤与粗粒度聚合,却无法原地执行复杂的缺失值矩阵插补、非线性统计建模与图表自动化排版。现代数据分析之所以普遍将 Python 作为核心首选,正是因为 Python 并不是要孤立取代 Excel 的即时直观或 SQL 的库内检索,而是凭借“千万级以上计算吞吐、全链路端到端自动化、图灵完备的业务逻辑表达,以及包含现代统计与机器学习的完备算法生态”,打通了传统数据工具链上的断层,将脆弱的人工作业升级为高鲁棒性、高复现性的工程流水线。
一、核心定位与分工层级:三大工具的本质差异
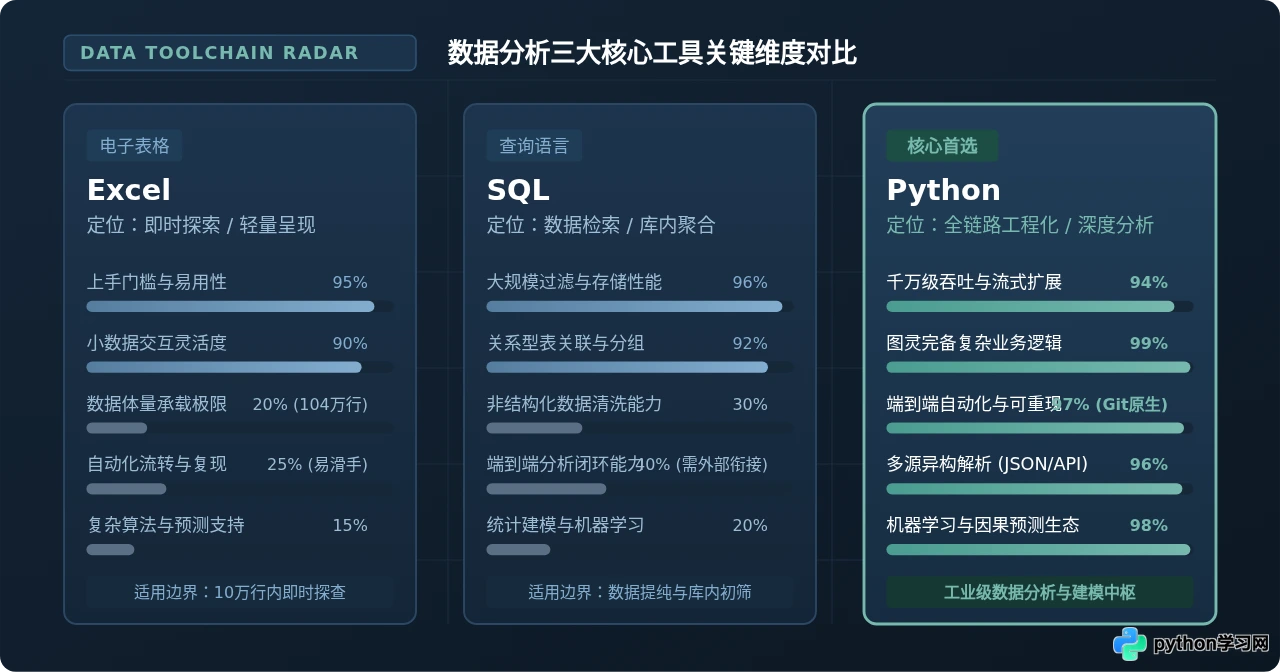
许多初学者容易产生“既然 Python 这么强大,是不是完全不需要学 Excel 和 SQL”的困惑。这种认知偏差源于混淆了不同工具在完整数据链路中的定位。这三者并非单向淘汰关系,而是各自锚定不同的能力区间:
- Excel(轻量级即时探索与人机交互终端):强项在于所见即所得的单元格操作。在数据量小于数万行、逻辑简单、需要业务人员直观浏览或手工微调假设时,Excel 具备最低的上手门槛与极高的沟通敏捷度。然而,其缺陷在于物理行数硬上限(1,048,576 行)、内存容易被复杂嵌套公式占满,以及每次数据更新都需要人肉复制粘贴。
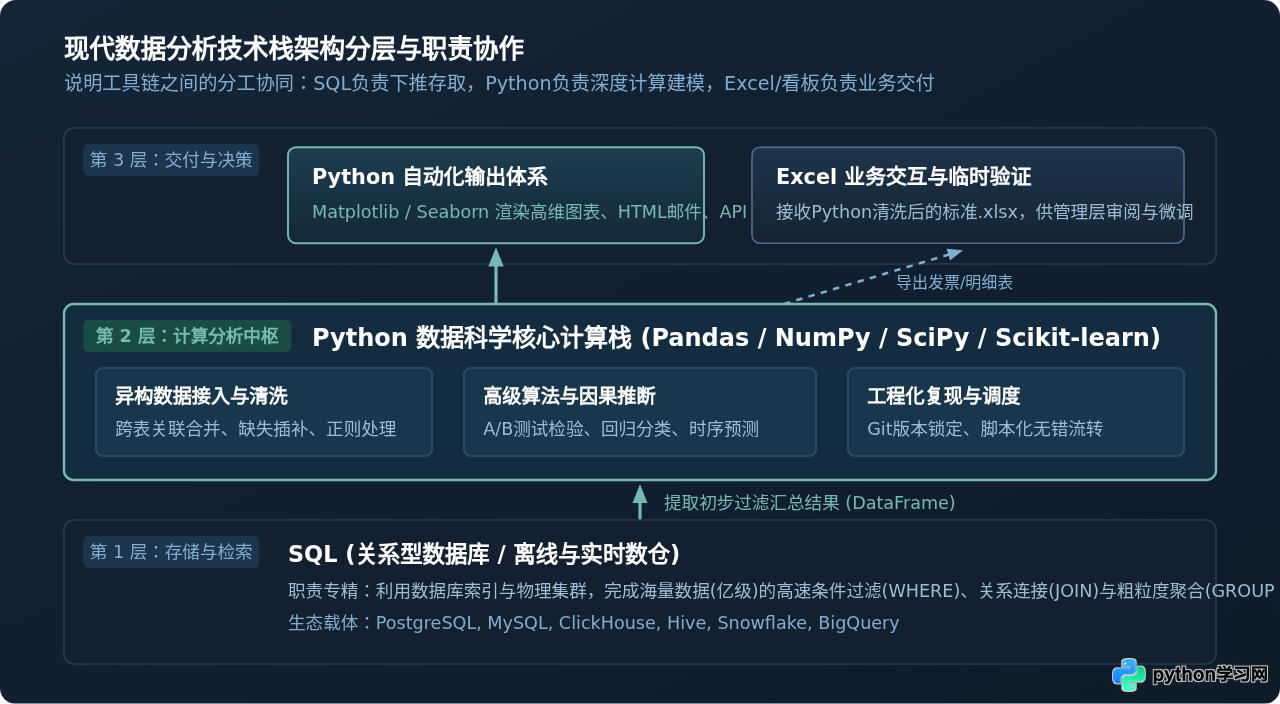
- SQL(关系型数据库存取与集合运算语言):强项在于直接在数据存储层进行下推计算。它利用数据库底层的 B-Tree 索引、分布式并行查询执行计划,能以极低的网络开销在秒级完成亿级数据的过滤(WHERE)、关联(JOIN)与分类聚合(GROUP BY)。然而,SQL 本身不具备通用编程能力,处理非结构化数据、多层迭代、科学计算或图形渲染时非常吃力,产出数据必须交接给下一步工具。
- Python(全流程工程化数据科学引擎):以通用的语法底座结合 Pandas、NumPy、SciPy、Scikit-learn、Matplotlib 等成熟生态。它向下能通过数据库驱动无缝对接 SQL 提取干净数据,中间承载任意复杂的逻辑分支、矩阵运算与算法建模,向上既能直接生成高分辨率图表与网页看板,也能反向写出格式规整的 Excel 交付业务层。
二、核心优势一:突破体量瓶颈与解析异构数据
在实际业务中,数据规模和形态往往不会停留在简单的“几十列标准二维表”。Python 相比 Excel 和纯 SQL 在处理边界上具备决定性优势。
1. 告别物理行数限制与内存窒息
Excel 的单表物理限制是 1,048,576 行,但在实际操作中,一张包含十几万行、同时套用多个跨表引用的表格,在普通办公电脑上就会引发卡顿甚至无预警崩溃。Python 单机利用 NumPy 的连续 C 语言内存布局与 Pandas 优化引擎,在几秒内就能完成千万级数据的计算。对于超出单机物理内存的极端超大数据集,Python 还能通过 chunksize 进行流式分块读取,或者平滑切换至 Polars、DuckDB 或 PySpark 等分布式加速引擎,而不存在断崖式失效。
2. 深度兼容非结构化与跨源异构数据
现代企业的数据源极为繁杂,包含了埋点服务器的 JSON 日志、三方开放平台的 RESTful API 接口、爬虫抓取的网页文本、半结构化 PDF 账单甚至时间序列信号。关系型数据库与 Excel 对此类嵌套结构支持极为局限。在 Python 中,通过内置标准库与 pandas.json_normalize(),仅需一行代码即可将层层嵌套的多层 JSON 展开为标准计算矩阵,配合正则表达式和自然语言处理库,能够快速对文本字段完成信息抽取与向量化。
import pandas as pd
total_sales = 0
chunk_iterator = pd.read_csv(
"large_transaction_logs.csv",
chunksize=500_000,
usecols=["user_id", "amount", "status"],
dtype={"user_id": "int32", "amount": "float32", "status": "category"}
)
for chunk in chunk_iterator:
valid_orders = chunk[chunk["status"] == "SUCCESS"]
total_sales += valid_orders["amount"].sum()
# 2. 异构 JSON 日志扁平化提取为分析表
raw_logs = [
{"event": "click", "meta": {"device": "iOS", "duration": 12.4}},
{"event": "pay", "meta": {"device": "Android", "duration": 45.1}}
]
df_logs = pd.json_normalize(raw_logs, sep="_")
# 产出结构清晰的列:event, meta_device, meta_duration
三、核心优势二:端到端自动化流水线与 100% 可复现性
在企业日常数据工作中,最大的隐形成本往往不是“算得慢”,而是“重复劳动”与“手滑出错”。
1. 摆脱手工流转的脆弱性
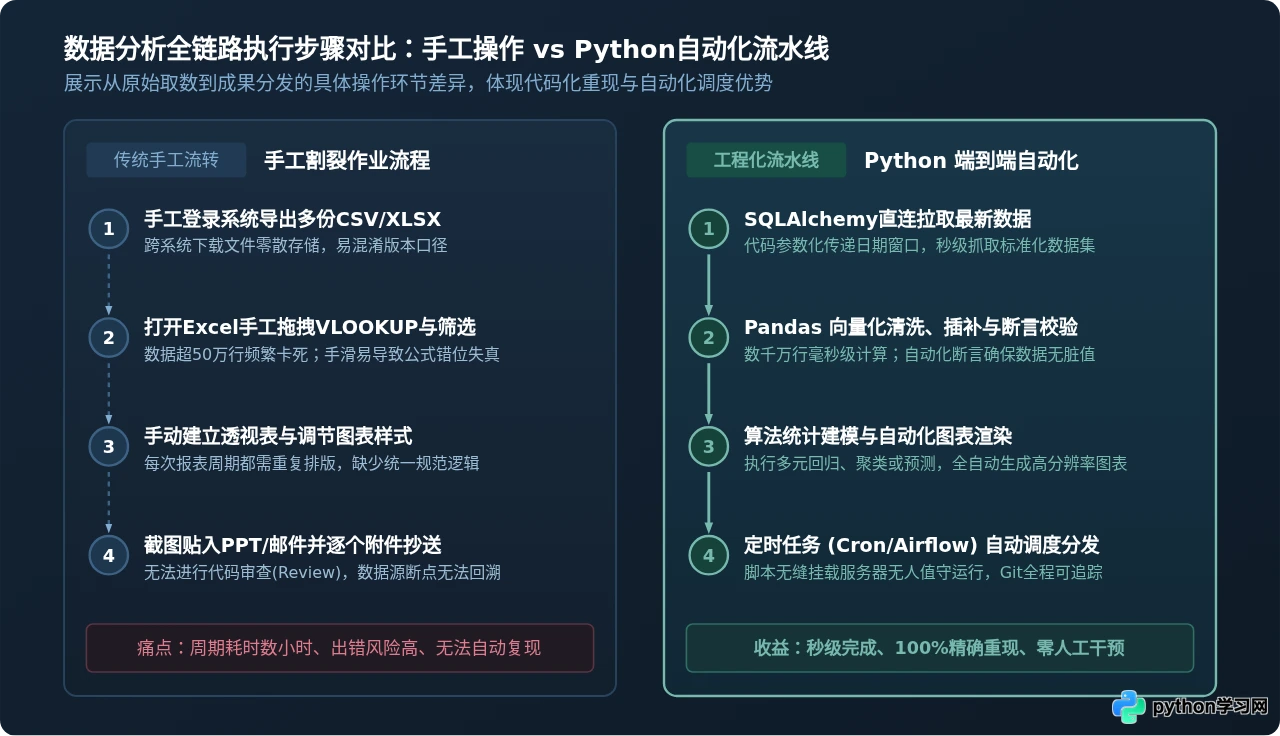
依赖 Excel 的传统工作流中,分析师每周需要花费数小时进行“从系统导出 CSV -> 复制粘贴到模版 -> 拖动 VLOOKUP 公式 -> 调整筛选条件 -> 刷新透视表 -> 截图填入 PPT”的操作。这个流程存在三重隐患:
- 无法进行版本追踪与代码审查:Excel 文件内部的逻辑修改无法被 Git 追踪,团队协作时难以核验谁在什么时候改动了哪个单元格的计算口径。
- 静默错误(Silent Error)频发:公式向下拖拽时漏选了一行、文本型数字导致 VLOOKUP 匹配为空、或是日期格式隐式转换异常,这些错误往往不会直接报错中断,而是输出看似正常却完全错误的汇总结果。
- 交接成本极高:复杂的多层嵌套公式和透视表结构,往往只有制作人自己能看懂,一旦人员离职,报表便沦为不可维护的“黑盒”。
2. Python 脚本化构建工业级数据管道
Python 将全过程写成结构化的代码脚本,赋予了数据分析软件工程级别的严谨度。通过配置 SQLAlchemy 直连业务库、Pandas 进行防御性清洗和断言检验(Assert)、Matplotlib/Seaborn 生成标准化图表,最后配合系统定时任务(如 Linux Cron 或 Apache Airflow),实现全流程无人值守一键运行。
四、核心优势三:算法前瞻——从“描述现状”跃迁到“预测未来”
商业分析的价值维度通常分为三个层次:
- 描述性分析(Descriptive):“过去发生了什么?”(例如:上月销售额总和、各省份销量占比);
- 诊断性分析(Diagnostic):“为什么会发生?”(例如:转化率骤降是因为渠道质量劣化还是页面加载延迟);
- 预测与指导性分析(Predictive & Prescriptive):“未来会怎样?我们应该如何决策?”(例如:下个季度的需求预测、用户流失概率预警与营销预算最优配置)。
Excel 与 SQL 的能力主要停留在第一层及部分第二层。一旦分析目标进入假设检验、因果推断、时序预测或复杂机器学习,Python 的生态优势便不可替代:
- 统计推断与 A/B 测试:利用
scipy.stats与statsmodels,可以严谨地进行双样本 t 检验、卡方检验、方差分析(ANOVA)以及消除混淆因子的多元线性/逻辑回归,给出置信区间和 P 值。 - 机器学习与客群建模:利用
scikit-learn、LightGBM等工具,数行代码即可构建随机森林或梯度提升树模型,自动完成特征归一化、交叉验证与混淆矩阵评估。 - 运筹优化决策:利用
scipy.optimize或PuLP,结合业务约束条件(如仓库库容、物流成本、预算上限)求解最优排产或营销分配方案。
import pandas as pd
from scipy import stats
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
# 1. 模拟业务样本:用户停留时长、登录频次与是否流失(1=流失, 0=留存)
np.random.seed(42)
n = 1000
df = pd.DataFrame({
"duration": np.random.exponential(scale=15, size=n),
"logins": np.random.poisson(lam=5, size=n),
"churn": np.random.binomial(n=1, p=0.25, size=n)
})
# 2. 统计推断:检验流失与留存用户的登录频次是否存在显著差异 (双独立样本 t 检验)
group_churn = df[df["churn"] == 1]["logins"]
group_stay = df[df["churn"] == 0]["logins"]
t_stat, p_val = stats.ttest_ind(group_churn, group_stay)
print(f"A/B显著性检验 p-value: {p_val:.4f}")
# 3. 预测建模:逻辑回归预测用户流失概率
X = df[["duration", "logins"]]
y = df["churn"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
clf = LogisticRegression()
clf.fit(X_train, y_train)
preds = clf.predict(X_test)
print(classification_report(y_test, preds, zero_division=0))
五、综合选型矩阵与决策路径
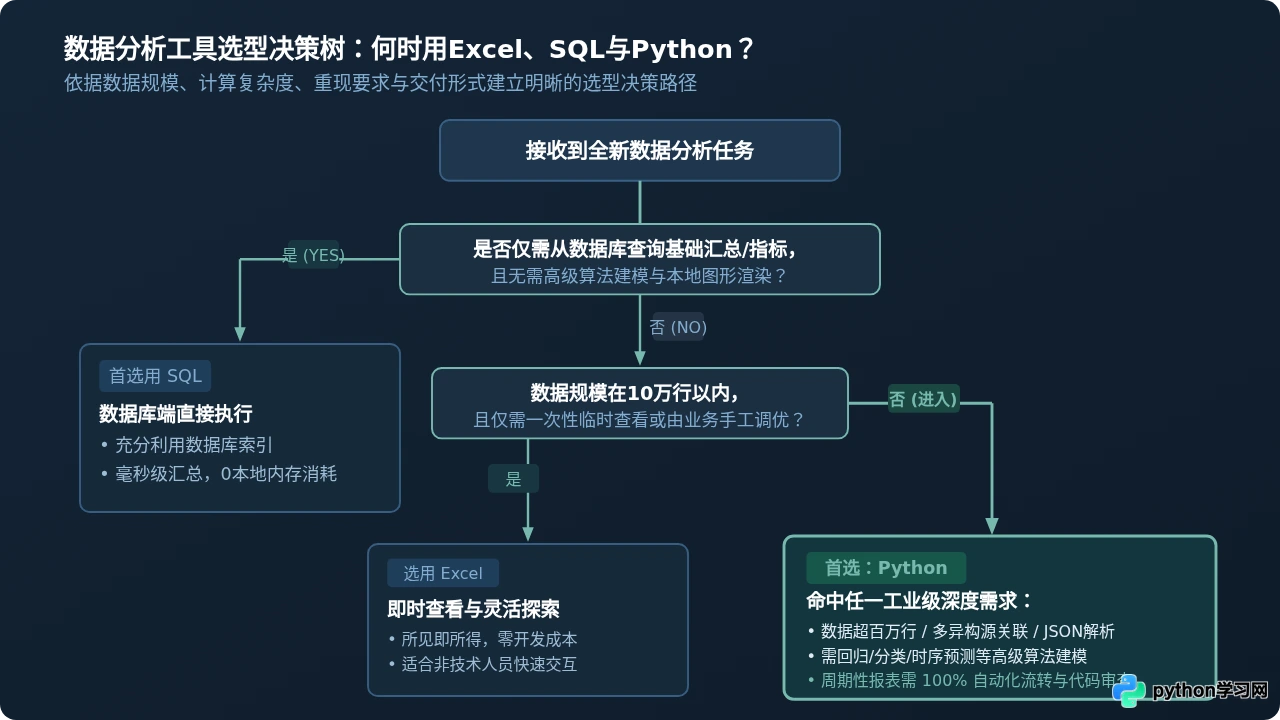
在了解了三大工具的核心长短板后,关键在于如何在具体业务场景中快速做出最优选型。下表全面梳理了核心差异:
| 对比维度 | Excel | SQL | Python |
|---|---|---|---|
| 数据承载上限 | 1,048,576 行(数十万行即明显卡顿) | 取决于数仓硬件配置(可达数亿级) | 单机千万级;可流式/分布式扩展至无上限 |
| 执行环境 | 本地单机客户端(所见即所得) | 数据库/数仓服务端集群 | 本地解释器、服务器脚本、云端集群 |
| 数据清洗能力 | 公式、分列、Power Query(操作割裂) | 条件查询、CASE WHEN、正则(语法繁冗) | 图灵完备编程语言、任意复杂业务逻辑封装 |
| 异构源支持 | 结构化二维表、部分 CSV/TXT | 严格的关系型结构表(JSON扩展较受限) | CSV/Excel/JSON/API/HTML/PDF/图像等 |
| 自动化与可重现 | 低(依赖人工点击与VBA宏,不易追踪) | 中等(SQL脚本可保存,但需外部编排) | 极高(脚本化、Git版本控制、Cron/Airflow) |
| 算法与统计深度 | 基础聚合、描述性统计、轻量图表 | 基础统计函数、窗口函数(无原生机器学习) | 假设检验、机器学习、深度学习、运筹优化 |
| 交付呈现形式 | .xlsx工作簿、手工图表 | 查询结果数据流(无原生绘图功能) | 交互式看板、高分辨率图表、自动化HTML/Excel |
六、避免走极端:三种常见误区与避坑指南
选择 Python 作为主轴,并不意味着要在所有场景下排斥 Excel 或重造 SQL 的轮子。在团队落地过程中,需要特别注意以下三类错误倾向:
1. 误区一:几百行数据强行写脚本(过度工程化)
在会议开始前 10 分钟,业务方临时发来一份包含 200 个客户名称的表格,要求快速核对是否存在重复。此时直接用 Excel 的“高亮重复项”或建一个临时数据透视表,30 秒即可交卷。如果非要为此新建虚拟环境、编写 Pandas 读取与去重脚本并调试语法,反而违背了解决业务问题的本质诉求。
2. 误区二:在 Python 中重造数据库已经做好的事
许多初学者在分析数仓数据时,喜欢写一条 SELECT * FROM huge_table 将数千万行原始明细全部拉取到本地 Python 内存中,再用 Pandas 过滤某个日期。这种做法不仅会堵塞公司内网带宽,还会直接撑爆本地内存。正确做法是将过滤与粗粒度关联下推给 SQL,让数据库集群先完成提纯,Python 仅承接缩减体积后的核心分析集。
3. 误区三:误认为 Python 执行速度慢
在数据处理领域,“Python 慢”通常是因为开发者错误地使用了原生 Python 的 for 循环逐行遍历 DataFrame。Pandas 和 NumPy 的底层由经过高度优化的 C 语言与 Fortran 编写,支持 SIMD 硬件指令级的向量化计算(Vectorization)。只要掌握了向量化表达式或借助 Polars 等现代列式引擎,其数据处理效率丝毫不逊于编译型语言。
七、总结与技术全景
数据分析从根本上说是一套解决业务问题、驱动商业决策的工程实践。在传统手工模式下,分析师的大量精力被消耗在跨表匹配、排查公式错位与机械更新周报等低效环节;而 Python 的介入,彻底将数据分析师从“人肉取数机”与“表格美化员”转变为具备工业级生产力的工程架构者。
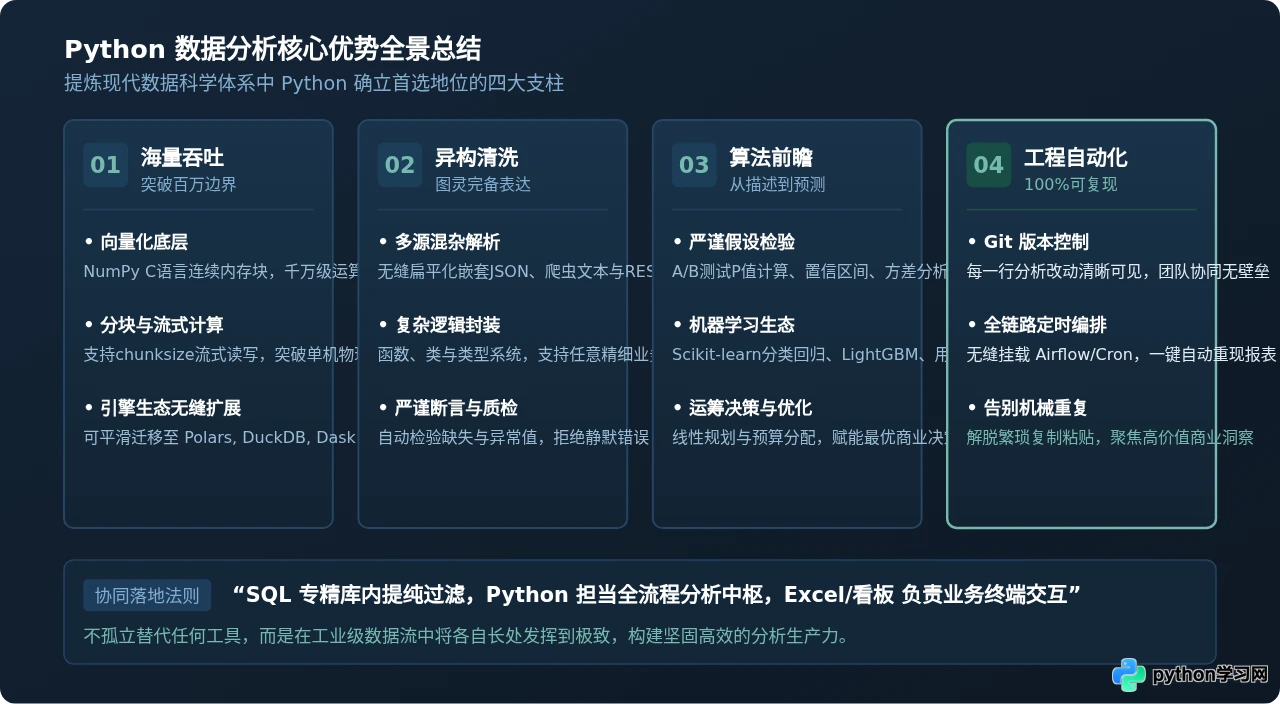
“SQL 专精库内提纯过滤,Python 担当全流程分析中枢,Excel/看板 负责业务终端交互”。以 Python 为核心枢纽,将三大工具嵌入最适合它们的环节,既能享受到数据库级的高速提取与电子表格的直观交付,又能充分享受 Python 带来的千万级数据吞吐、端到端自动化与前瞻预测能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









