

Python数据分析新手应优先学习Pandas还是其他框架
深入探讨Python数据分析新手应优先学习Pandas还是Polars、DuckDB等新兴框架。从学习曲线、生态联动、排错成本、执行机制及业务场景等维度,提供客观清晰的技术选型与成长路径建议。
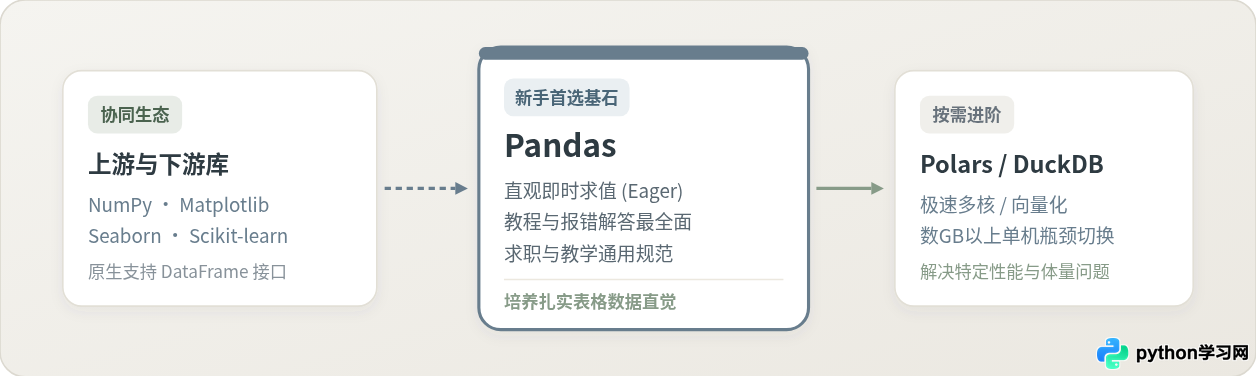
一、为什么新手的第一站仍是 Pandas
新手在初学阶段面临的核心矛盾,从来不是“数据处理需要几毫秒”,而是“如何快速建立表格数据处理的直觉,并且在遇到错误时能够立刻找到解决方法”。从这个角度来看,Pandas 具备三大不可替代的先发优势。
1. 无法撼动的生态互操作性与行业事实标准
Python 数据科学体系不是孤立存在的,它由一个高度协同的开源库群组成。底层通过 NumPy 管理连续内存数组,中间层通过 Pandas 进行灵活的二维数据切片与重塑,上层则通过 Matplotlib 和 Seaborn 绘制统计图表,或者通过 Scikit-learn 构建机器学习预测模型。
这套生态链条的默认交互语言就是 Pandas DataFrame。无论在后续开发中采用何种专用工具,只要需要使用经典算法库或进行可视化探索,数据几乎都需要转化为 Pandas 的数据结构。如果跳过 Pandas 直接学习其他框架,新手在接触可视化、特征工程或经典案例时,将不得不频繁停下来补习基础语法。
2. 报错沉淀丰厚,排错成本降到最低
初学者学习编程最容易产生挫败感的环节是遇到看不懂的报错信息。在 Pandas 中,无论是索引越界的 KeyError、视图赋值警告 SettingWithCopyWarning,还是数据类型不匹配的 TypeError,几乎每一个报错在主流技术社区中都有成千上万篇详尽的中文解析与成因说明。
相比之下,新兴框架虽然设计先进,但遇到深层表达式推断失败或 Arrow 内存映射异常时,公开的问答记录相对稀缺,新手往往需要直接查阅英文官方源码或 GitHub Issues,这无疑人为拔高了入门门槛。
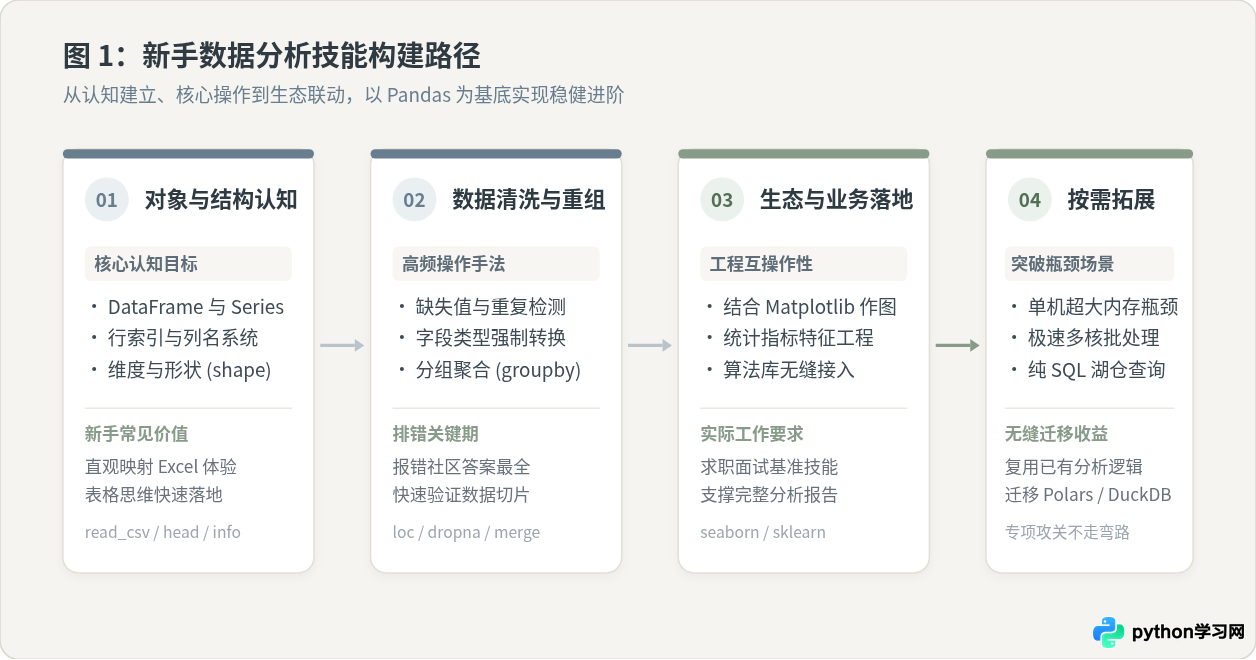
二、核心范式对比:Pandas 与 Polars / DuckDB 的关键差异
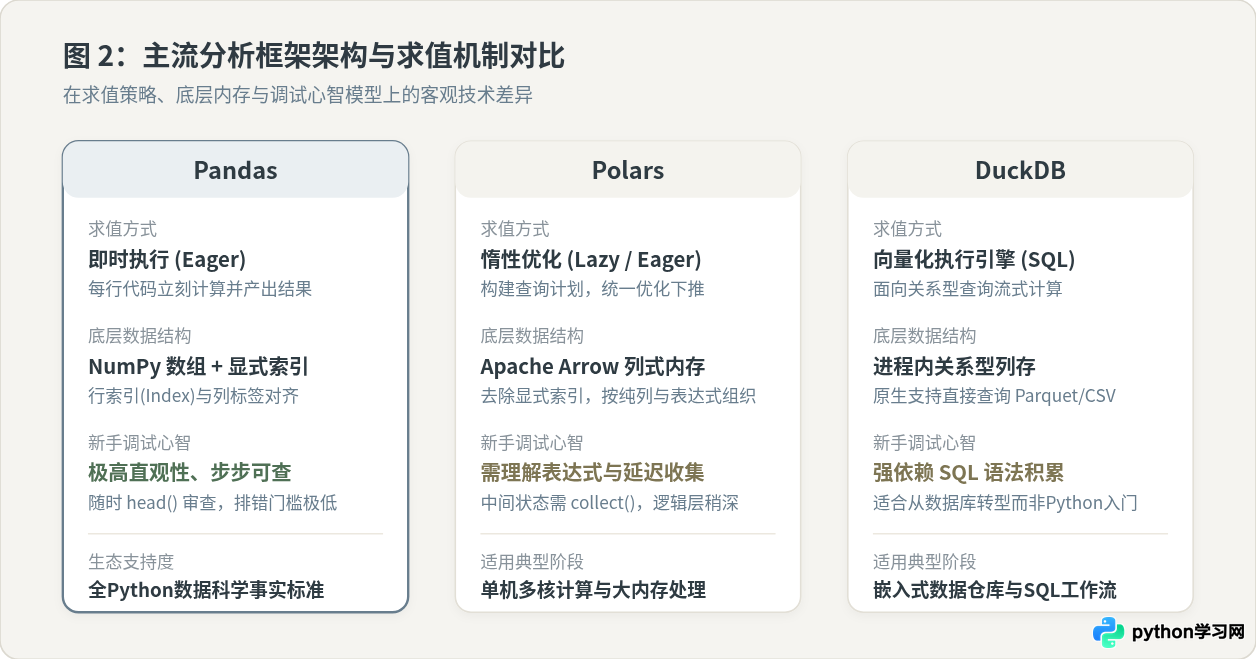
理解“为什么要先学 Pandas”,需要建立在客观理解各框架技术差异的基础之上。以下选择在同等数据分析任务下,对比 Pandas 与两个最热门的现代框架——Polars 与 DuckDB 的核心差异及其对新手学习带来的实际影响。
| 对比维度 | Pandas | Polars | DuckDB |
|---|---|---|---|
| 默认求值策略 | 即时执行 (Eager),步步产出结果 | 惰性执行 (Lazy) 为核心,需主动 collect | 向量化执行引擎,按需流式拉取 |
| 底层内存布局 | NumPy 二维/一维数组 + 显式索引 | Apache Arrow 紧凑列式内存 | 进程内列式关系存储 |
| 调试直观性 | 极高,随时打印 df.head() 查看状态 |
中等,惰性模式需理解查询图与延迟收集 | 依赖 SQL 客户端或交互式查询窗口 |
| 多核并行支持 | 单核主导,需外部库(如 pandarallel)辅助 | Rust 原生多线程,CPU 满载并行 | 原生多线程向量化执行 |
| 学习曲线 | 前期平缓,符合传统表格与 Excel 直觉 | 需掌握表达式语法(Expressions)与上下文 | 需具备扎实的关系型 SQL 基础语法 |
1. 即时求值(Eager)对初学者的调试价值
Pandas 采用即时执行模式:每敲下一行代码,Python 就会在内存中完成计算并生成新的对象。初学者在 Jupyter Notebook 中可以单步执行、单步检查,随时查看当前表格有几行几列、每一列的数据长什么样。这种“所见即所得”的即时反馈,对于建立“数据是如何被一步步清洗出来的”心理模型至关重要。
而 Polars 的高性能很大程度上得益于惰性计算(Lazy Evaluation)。在惰性模式下,写下的每一句过滤或聚合都不会立刻运算,而是构建一棵抽象语法树,直到调用 collect() 时优化器才会统一规划并执行。这种机制虽然大幅消除了冗余计算,但对于尚未完全掌握数据处理逻辑的新手而言,无法随时肉眼观察中间过程,增加了逻辑排查的抽象层级。
2. 同一任务的代码风格与心智模型对照
为了直观展现两者的差异,我们来看一个经典业务场景:读取销售记录,筛选出销售额大于 0 的记录,按产品品类分组计算订单量与总金额,最后按总金额从大到小排序。
import pandas as pd

# 1. 读入数据
df = pd.read_csv("sales_data.csv")

# 2. 条件筛选
valid_df = df[df["amount"] > 0]

# 3. 分组聚合与重命名
result = (
    valid_df.groupby("category")
    .agg(order_count=("order_id", "count"), total_amount=("amount", "sum"))
    .reset_index()
    .sort_values(by="total_amount", ascending=False)
)

print(result.head())import polars as pl
# 1. 声明惰性查询计划
query = (
pl.scan_csv("sales_data.csv")
.filter(pl.col("amount") > 0)
.group_by("category")
.agg(
pl.col("order_id").count().alias("order_count"),
pl.col("amount").sum().alias("total_amount")
)
.sort("total_amount", descending=True)
)
# 2. 统一优化并触发执行收集
result = query.collect()
print(result.head())
从对照中可以看出,Polars 的表达式语法(pl.col())非常优雅且富有现代函数式编程美感,但在初学阶段,理解 scan_csv 与 collect 的分离、理解 alias 的作用范围,需要付出额外的认知成本;而 Pandas 的代码逻辑更贴近常规过程式思维,新手更容易逐行验证。
三、新手阶段的核心操作:四步最小知识集
许多初学者对 Pandas 产生畏难情绪,是因为误以为需要把官方文档中数百个函数全部背下来。实际上,数据分析中 80% 的工作都可以通过一个规范的四步操作闭环来搞定。新手只需牢牢掌握这四步的标准写法即可。
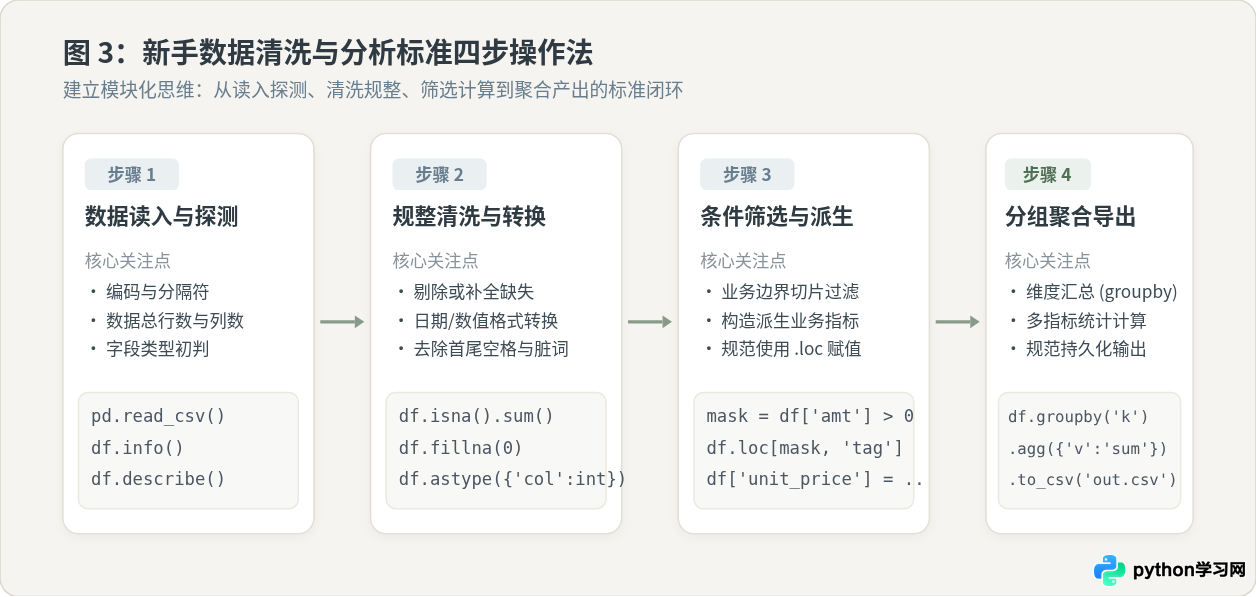
步骤 1:数据读入与结构探测
拿到数据后的第一件事,永远是探查数据的基本形状与字段分布,而不是直接开始做分析。
import pandas as pd

# 读取 CSV 文件(中文路径或编码异常时可显式传入 encoding='utf-8' 或 'gbk')
df = pd.read_csv("orders.csv")

# 关键探测三步曲
print("数据维度 (行, 列):", df.shape)
print("
--- 字段与非空统计 ---")
df.info()
print("
--- 数值型字段基本分布 ---")
print(df.describe())UnicodeDecodeError: 'utf-8' codec can't decode...,通常是源文件来自 Windows Excel 的 ANSI/GBK 编码,可添加参数 encoding='gbk' 重试。
步骤 2:规整清洗与缺失值处理
真实世界的数据往往存在脏数据与类型不一致。必须在计算前完成缺失值填补和字段类型校准。
# 统计各列缺失值数量
print(df.isna().sum())

# 对数值列填充默认值 0,对分类列填充 '未知'
df["amount"] = df["amount"].fillna(0)
df["channel"] = df["channel"].fillna("未知")

# 转换时间列为标准 datetime 格式,转换金额为浮点型
df["order_time"] = pd.to_datetime(df["order_time"])
df["amount"] = df["amount"].astype(float)
步骤 3:条件切片与特征派生
在提取满足特定业务条件的记录时,规范使用 .loc 索引器是避开各种诡异警告的核心习惯。
# 构造复合条件掩码:金额大于100 且 渠道不等于 '测试'
mask = (df["amount"] > 100) & (df["channel"] != "测试")

# 规范切片并派生新指标(避免使用 df[mask]['new_col'] 链式赋值)
df.loc[mask, "is_vip_order"] = 1
df.loc[~mask, "is_vip_order"] = 0

# 基于已有字段生成新衍生列
df["discount_amount"] = df["amount"] * 0.9&(与)和 |(或),且每一个子条件必须用括号包裹,例如 (df['a'] > 0) & (df['b'] < 10),否则会因 Python 运算符优先级产生歧义报错。
步骤 4:维度聚合与报表导出
统计汇总的终点通常是将清洗好的指标按照业务维度聚合,并导出为文件。
# 按渠道汇总总销售额与平均客单价
summary = (
    df.groupby("channel")["amount"]
    .agg(total_sales="sum", avg_sales="mean", order_num="count")
    .reset_index()
)

# 保存最终报告(通常无需保留 Pandas 自带的数字行索引)
summary.to_csv("channel_summary_report.csv", index=False, encoding="utf-8-sig")
print("报表导出完成,预览:
", summary)
四、什么时候需要引入其他框架
优先学习 Pandas 并不意味着固步自封。现代数据工程实践中,各个框架有其明确的优势边界。当你的技术基础已经扎实,且在实际项目中遇到以下三个典型场景时,就是引入其他框架的最佳时机。
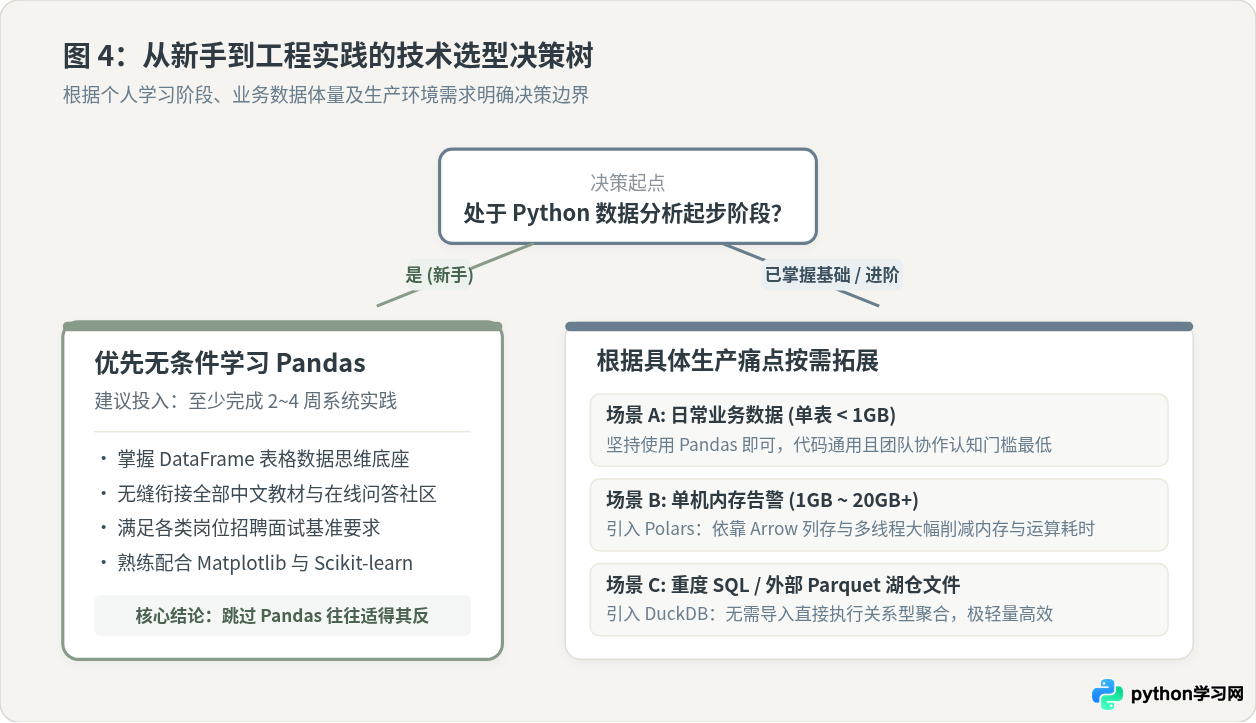
1. 场景一:单机内存告警,遭遇性能瓶颈(转向 Polars)
Pandas 由于其底层机制,在处理数据时通常需要占用原始 CSV 体积 3 到 5 倍的运行内存。当单表体量达到 3GB ~ 10GB 时,普通家用电脑(如 16GB 内存)运行复杂 groupby 或 merge 时极易触发系统的 MemoryError(内存溢出崩溃)。
此时,转向 Polars 是最自然、最平滑的选择。由于基于 Apache Arrow 列式格式且全核并行,Polars 能够以极低的内存开销完成同等任务,计算速度往往能达到 Pandas 的数倍至数十倍。
2. 场景二:习惯关系型查询,直接分析湖仓文件(转向 DuckDB)
如果你本身具备较好的 SQL 功底,或者日常工作需要直接对云存储上的多个 Parquet、JSON 文件进行多表关联分析,DuckDB 是神器一般的存在。
DuckDB 可以被视为“分析型数据的 SQLite”。它不需要像常规数据库那样启动单独的服务进程,只需要在 Python 脚本中引入包,就可以直接用标准 SQL 语句去 SELECT * FROM 'data/*.parquet' WHERE ...,同时还能将结果无缝转出为 Pandas 或 Polars 数据流。
3. 场景三:海量分布式集群分析(转向 PySpark)
当数据量达到百 GB 甚至 TB 级别,单台物理机的内存和磁盘已无法承载时,单机分析工具便不再适用。此时需要迈向基于分布式计算集群的 PySpark 或云端数仓(如 BigQuery、Snowflake、ClickHouse)。
五、总结与成长建议
技术学习的本质是“先建立框架,再按需突破”。对于 Python 数据分析新手来说:
- 坚定以 Pandas 为第一站:它能帮你快速建立行列索引、缺失处理、切片筛选和分组聚合的标准表格思维,并且拥有整个 Python 社区最丰富、最宽容的学习生态。
- 不必追求死记硬背:熟练运用“探测 - 清洗 - 切片 - 聚合”四个核心步骤,配合官方查阅文档,就足以独立完成 80% 的商业分析与报表需求。
- 把现代框架作为进阶武器:学好 Pandas 之后,你的数据分析逻辑已经完全成型。未来面对大规模高并发性能场景时,只需花上两三天熟悉 Polars 的表达式语法或 DuckDB 的 SQL 模式,即可快速完成迁移。
不要在初学阶段因为追求最新框架的极致性能而陷入深层概念与排错困境。先用 Pandas 跑通全流程、做出第一个完整的数据分析报告,才是新手最坚实、最具回报率的第一步。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









