

Python面试刷题指南:LeetCode与牛客网等算法练习网站对比
深度对比LeetCode、牛客网、HackerRank等算法练习网站的核心差异,剖析核心代码模式与ACM模式在Python下的具体实现、输入输出性能优化方案与四大避坑军规,提供系统的阶段性备考指南。
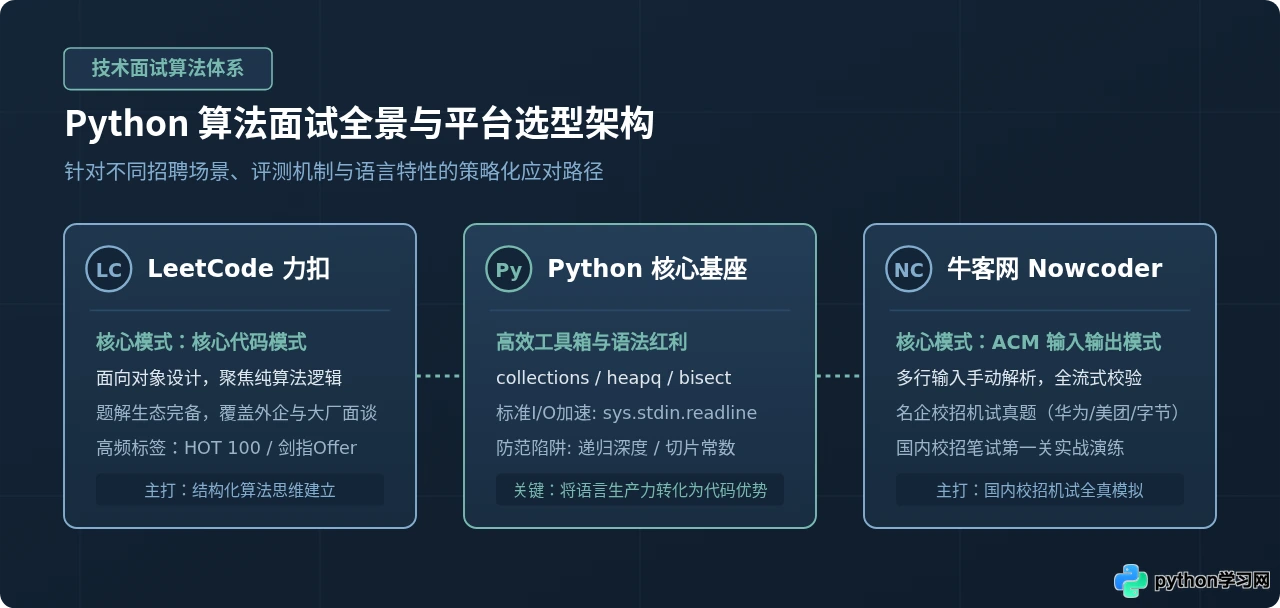
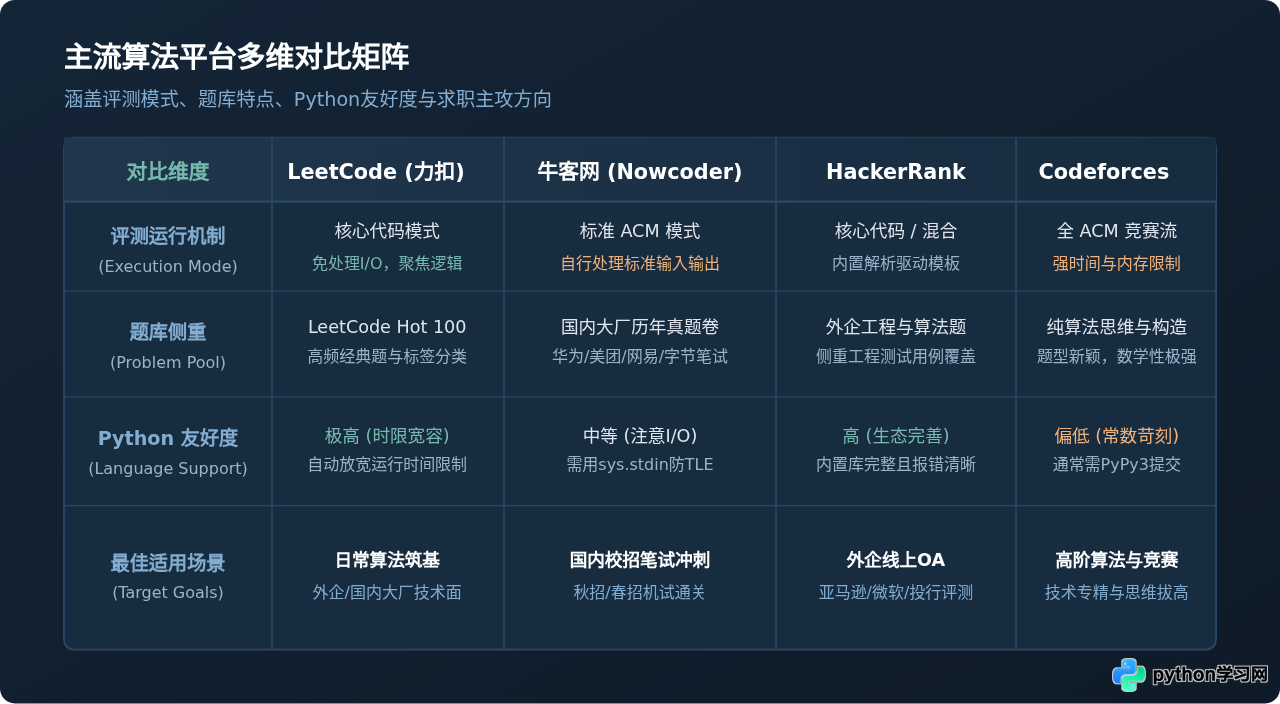
一、主流算法练习平台定位与横向对比
选择合适的练习平台决定了备考效率。目前主流的技术面试练习网站各具侧重,算法考核并非孤立的题目训练,而是与具体企业的招聘形式、机试系统及面试官习惯深度绑定的。盲目在一个平台刷题往往容易在面对真实的笔试环境时产生不适感。
1. LeetCode(力扣):算法体系与技术面谈的核心阵地
LeetCode 是全球范围内普及度最高的算法平台,也是国内大厂与外企技术面谈中面试官出题的主要参考库。其核心特点包括:
- 核心代码模式:解题时只需在给定的类中完善特定成员函数,函数的入参由后台自动反序列化,返回值由判题系统自动校验,读者无需编写任何输入输出代码。
- 题解与讨论生态繁荣:每道题通常涵盖多种解法,从基础暴力枚举到最优时空复杂度演进路径清晰,便于掌握算法推导过程。
- 标签与榜单完备:拥有「LeetCode Hot 100」、「面试经典 150 题」以及针对字节跳动、微软、腾讯等企业的专属高频标签,适合系统性建立算法模型。
2. 牛客网(Nowcoder):国内校招与大厂机试的主战场
如果求职目标是国内互联网大厂、通信巨头或国企银行的校招,牛客网是不可或缺的平台。牛客网的技术特性直接对应了国内招聘的第一道筛选门槛:
- 严格的 ACM 模式:题目要求从标准输入流(
sys.stdin)读取字符数据,手工处理多行输入、空行隔断与数据类型转换,并按照严格的字符格式输出到标准输出。 - 名企历年机试原题卷:汇集了华为、美团、拼多多、网易、字节跳动等企业的历年秋招与春招笔试真题,能够还原 90 至 120 分钟内的多题闭卷联考场景。
- 边界用例设计严苛:机试题目往往包含未公开的极端边界数据(如空树、极端大数、重边连通图),对输入输出健壮性要求极高。
3. HackerRank 与 Codeforces:外企 OA 与算法进阶补位
除了上述两大平台,面对跨国企业或需要极致算法功底的岗位时,还需了解另外两个平台:
- HackerRank:欧美外企(如亚马逊、高盛、彭博等)发放线上笔试(Online Assessment, OA)的高频选用系统。其题面为全英文,评测多采用给定了部分框架的混合模式,用例强调工程测试思维与代码边界覆盖。
- Codeforces:国际知名的算法竞赛平台,题型侧重逻辑思维、数学构造与极端优化。通常不作为普通开发岗位的首选题库,但对于追求高难度算法岗、量化策略开发岗的候选人,能够提供极佳的思维深度训练。
二、评测模式差异:核心代码模式 vs ACM 模式
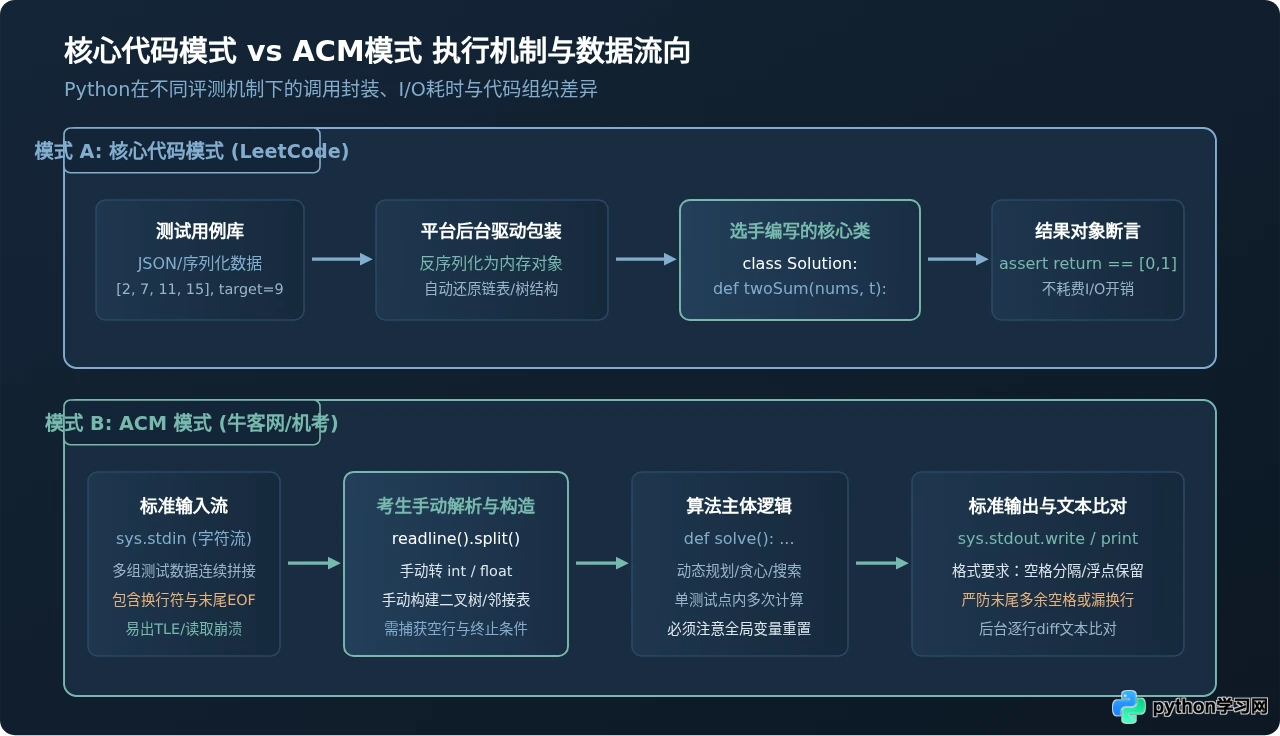
许多初学 Python 的求职者在从 LeetCode 切换到牛客网或企业机试系统时,最常遇到的挫败并非算法逻辑错误,而是“无法获取输入”、“输出格式错误”或“由于 I/O 耗时过高导致运行超时(TLE)”。理解这两种评测模式的底层流向是高效通关的前提。
1. 核心代码模式的封装逻辑
在核心代码模式下,平台的评测沙箱已经预置了测试驱动代码。例如针对「两数之和」题目,候选人只需交付如下类定义:
class Solution:
    def twoSum(self, nums: list[int], target: int) -> list[int]:
        hashmap = {}
        for idx, val in enumerate(nums):
            diff = target - val
            if diff in hashmap:
                return [hashmap[diff], idx]
            hashmap[val] = idx
        return []
在该模式下,评测系统在沙箱外部调用 Solution().twoSum(case_nums, case_target) 并直接比对内存对象的值,执行开销纯粹集中在算法本身的计算复杂度上。
2. ACM 模式下 Python 高性能 I/O 模板与实操要点
ACM 模式将程序视作独立的可执行进程,测试用例通过重定向管道写入 sys.stdin。在 Python 中,如果简单使用内置的 input() 函数逐行读取,当测试数据达到数十万行时,每次调用带来的字符串剥离开销极易导致超时。
sys.stdin.readline 直接调用底层 C 语言 I/O 缓冲区,比 input() 快约 2 到 4 倍。同时,读取末尾包含换行符
,通常需要结合 .strip() 或 .split() 处理。
以下是处理多组未知数量输入的经典通用模板:
import sys

def solve():
    # 方式一:一次性读取全部输入,按空白字符快速切分
    raw_data = sys.stdin.read().split()
    if not raw_data:
        return

    ptr = 0
    total_tokens = len(raw_data)

    # 模拟读取:例如每组数据第一项为 N,随后为 N 个整数
    while ptr < total_tokens:
        n = int(raw_data[ptr])
        ptr += 1
        numbers = [int(raw_data[ptr + i]) for i in range(n)]
        ptr += n

        # 执行算法核心逻辑
        result = sum(numbers)

        # 格式化输出到标准输出
        sys.stdout.write(f"{result}\n")

if __name__ == "__main__":
    solve()
在涉及链表、二叉树或加权图的 ACM 题目中,必须在本地自行定义节点类并手工写出反序列化函数。例如根据先序与中序遍历数组重建二叉树,或者将输入的二维边集转化为邻接表字典,这一过程考查了代码的整体工程组织能力。
三、Python 在算法面试中的核心优势与关键陷阱
与 C++ 或 Java 相比,Python 的代码表达极为精炼。例如交换两个变量仅需一行 a, b = b, a,使用切片 nums[::-1] 即可完成逆序,极大地减少了在面试有限时间内的代码输入负担。然而,Python 的动态特性与解释执行机制也带来了不可忽视的性能陷阱。
1. 不容忽视的四大性能与逻辑陷阱
-
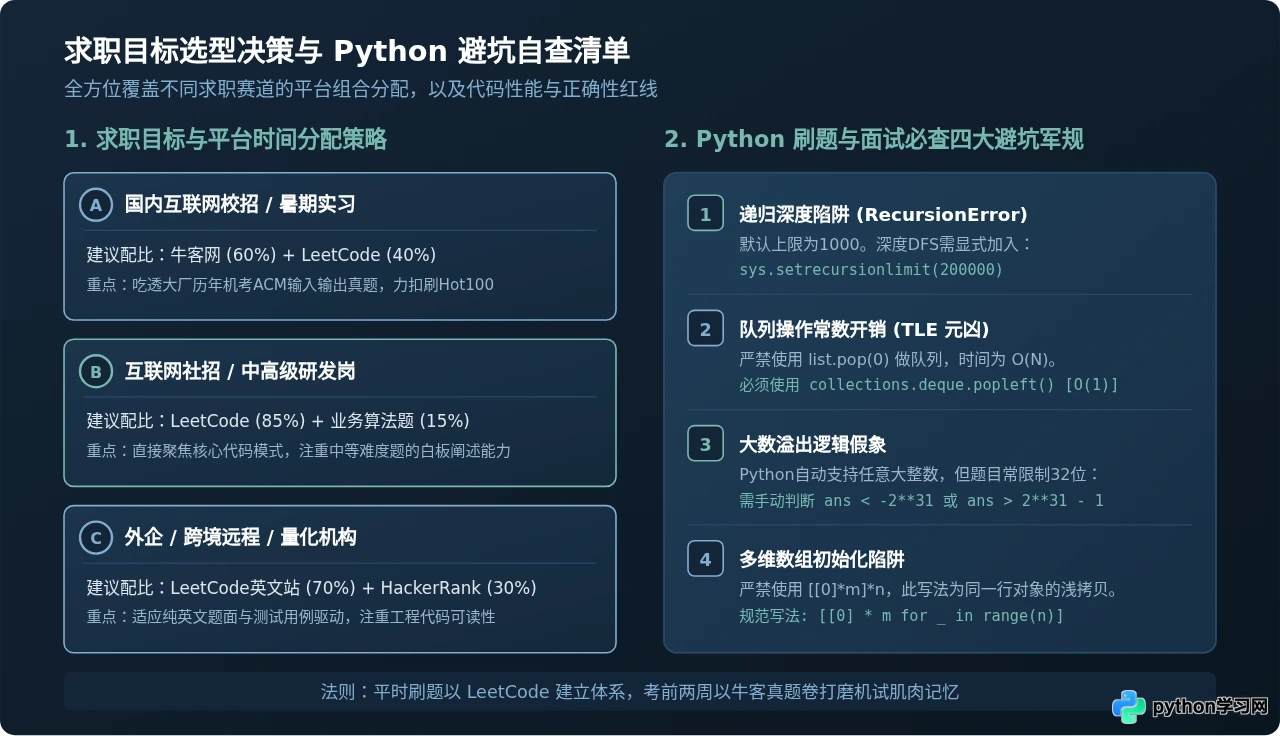
递归深度上限(RecursionError):Python 默认的最大递归深度仅为 1000。在图的深度优先搜索(DFS)或长链表操作中,当测试节点达到上万个时会直接抛出递归超限错误。必须在脚本开头显式声明:
import sys sys.setrecursionlimit(200000) -
队列操作误区(TLE 的主要元凶):Python 的普通列表
list底层是动态连续数组。在广度优先搜索(BFS)中使用queue.pop(0)是 $O(N)$ 的移动操作,整个 BFS 的时间复杂度将退化为 $O(V + E \cdot V)$。必须引入双端队列:from collections import deque q = deque() q.append(node) curr = q.popleft() # 严格保证 O(1) -
多维数组初始化的浅拷贝陷阱:在动态规划构建二维表格时,新手常写出
dp = [[0] * m] * n。该语法复制的是内部列表的同一引用,一旦修改dp[0][1] = 5,整个二维表格的所有行第 1 列均会被同步赋值。正确做法必须使用列表推导式:dp = [[0] * m for _ in range(n)] -
32 位整数溢出逻辑:Python3 的整型原生支持无限精度,计算类似
2**63 - 1不会发生自然溢出。然而,部分面试题目(如「整数反转」或位运算)明确要求遵循 32 位带符号整型约束 $[-2^{31}, 2^{31} - 1]$。必须在输出或中间判断中手动加入边界截断保护。
四、四阶段 Python 刷题备考执行路线
为了避免陷入“刷了忘、忘了再刷”的低效循环,算法训练应遵循由浅入深、由模块到综合的四阶段递进法则。
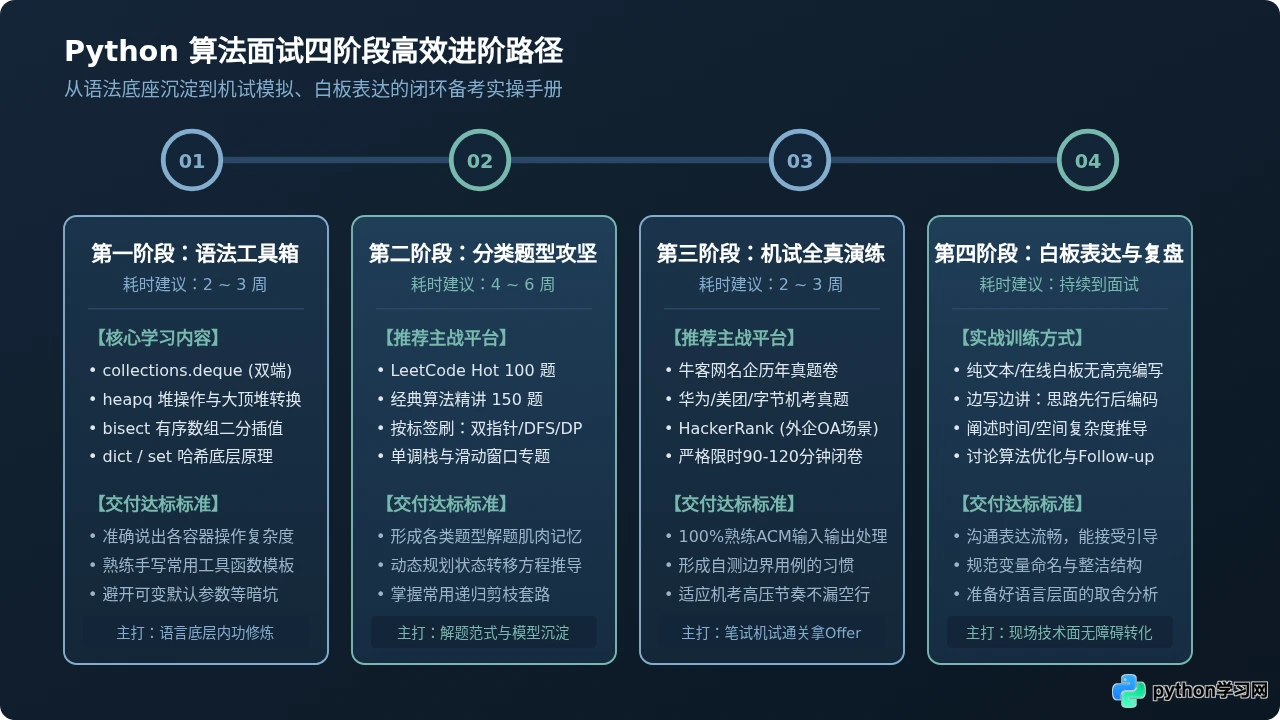
阶段一:语言内置工具箱与时间复杂度直觉(2 ~ 3 周)
第一阶段的目标是熟悉标准库的高效用法,并建立对各个操作时间复杂度的肌肉记忆。
- 核心库掌握:深入熟练掌握
collections.Counter(词频统计)、collections.defaultdict(自动初始化字典)、heapq(默认小顶堆,取负值构建大顶堆)以及bisect.bisect_left / bisect_right(二分插入查找)。 - 复杂度分析:明确知道
in dict为 $O(1)$,而in list为 $O(N)$;字符串通过+=拼接会产生频繁内存重分配,必须优先使用"".join(list)。
阶段二:分类题型模型攻坚(4 ~ 6 周)
此阶段建议以 LeetCode 核心代码模式 为主,按专题推进,彻底吃透基础算法模型:
- 双指针与滑动窗口:快慢指针判定链表环、相向对撞指针求有序数组和、定长与变长窗口最大子串。
- 树与图遍历:二叉树的前中后序递归与迭代遍历、层序遍历、二叉搜索树(BST)性质、图的 DFS 与 BFS。
- 动态规划(DP):由记忆化搜索过渡到状态转移数组。熟练掌握 0-1 背包、完全背包、最长上升子序列(LIS)与最长公共子序列(LCS)。
- 回溯与剪枝:全排列、子集求和、括号生成,深刻理解回溯中状态撤销的时机。
阶段三:ACM 机试真题与全真限时模拟(2 ~ 3 周)
在笔试前一个月,必须将主战平台切换至 牛客网名企真题模块:
- 选择意向企业的真实笔试试卷,严格按照系统规定的 90 到 120 分钟倒计时进行全闭卷答题。
- 强迫自己手工编写输入输出解析,针对每个题目自行构造 3 到 5 组极限边界用例(全空、极端重复、单节点、最大数值范围)。
- 习惯在没有详细用例失败提示的评测环境下排查逻辑漏洞。
阶段四:白板演练与复杂度口头阐述(持续至面试)
进入面试环节后,技术面试官考查的不仅是能否写出代码,更是问题拆解与团队沟通能力。
- 先讲思路,后动键盘:在编码前向面试官口述暴力解法的复杂度,再提出通过哈希表或双指针优化的思路,得到面试官认可后再开始书写。
- 主动分析时空复杂度:写完后主动给出大 $O$ 阶数,例如:“由于使用了排序,时间复杂度为 $O(N \log N)$,额外使用了一个哈希字典,最坏空间复杂度为 $O(N)$。”
- 面对 Follow-up 积极应对:当面试官追问“如果内存只有 10MB 怎么处理”,能够联想到分块处理、多路归并或位图(BitMap)压缩等工程策略。
五、求职目标选型决策与核心自查矩阵
针对不同求职背景与时间限制,合理分配在 LeetCode、牛客网以及其他平台的训练时间,才能使收益最大化。
| 求职方向 | 核心平台配比 | 关键考核形式 | Python 备考策略重中之重 |
|---|---|---|---|
| 国内互联网大厂校招 | 牛客网 (60%) + LeetCode (40%) | 笔试机考 (ACM) + 视频技术面 | 熟练掌握 sys.stdin 模板,熟悉大厂常考的中等至困难 DP 与模拟题。 |
| 互联网社招研发岗 | LeetCode (85%) + 业务专项 (15%) | 在线白板 (核心代码模式为主) | 直接以 Hot 100 为轴心,重在无语法报错的稳健代码与口头沟通表达。 |
| 外企 / 跨境远程 / 量化 | LeetCode 英文站 (70%) + HackerRank (30%) | 英文 OA 评测 + 架构与算法深聊 | 适应全英文用例描述,注重变量命名的工程规范性与边界测试用例覆盖。 |
sys.setrecursionlimit、deque 队列操作与浅拷贝等语言特性带来的陷阱,方能在技术面试与机试笔试中游刃有余。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









