

Python列表与字典怎么用?零基础掌握常用数据结构操作
零基础系统掌握Python两大最核心的数据结构:列表(List)与字典(Dictionary)。本文详细解析列表的有序索引、增删改查、切片,以及字典的键值映射、安全查询与常用方法,配有直观架构图、代码示例与防坑指南。
一、列表(List):有序集合的核心操作与索引机制
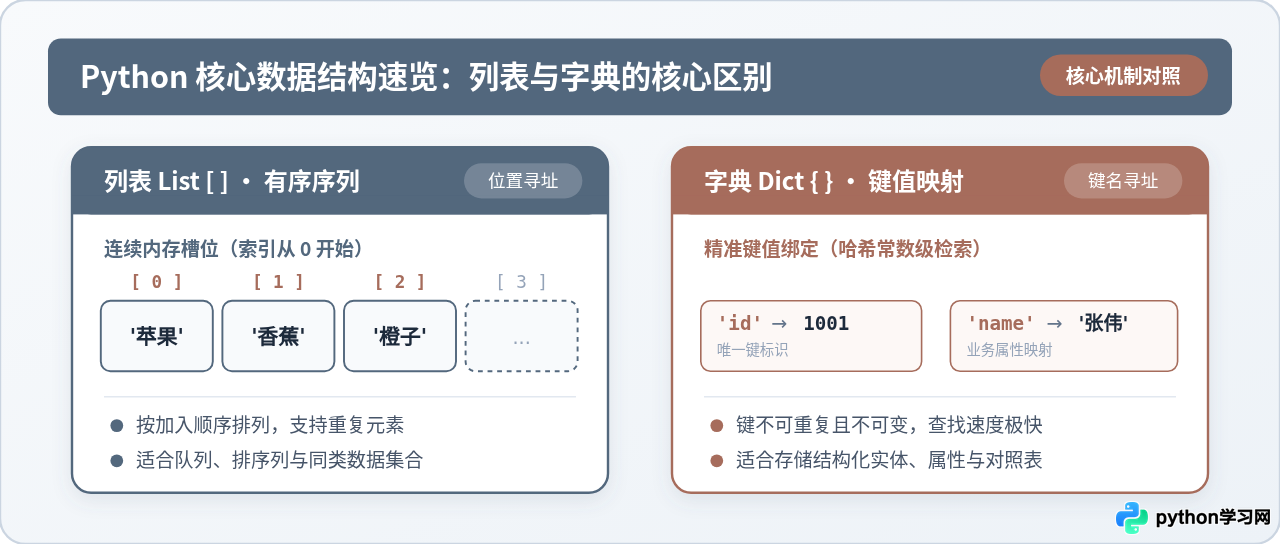
列表是 Python 中最常用的有序序列容器,使用中括号 [ ] 声明。它允许存放任意类型的对象,并且元素保持插入时的前后次序,同一个元素也可以重复出现。当需要记录一串按时间发生的事件、排队的任务或具有批处理特征的数据集时,列表是首选。
1. 声明与正反向双向索引
Python 列表具备优雅的双向索引机制:正向索引从 0 开始依序增加,代表第 1 个元素;负向索引从 -1 开始从尾部倒数,-1 即为最后一个元素。利用该机制无需提前计算长度就能安全获取末尾数据。
# 1. 列表声明(可包含相同元素与混合类型)
languages = ['Python', 'Java', 'Rust', 'Go', 'C++']

# 2. 索引读取
first_item = languages[0]    # 示例输出: 'Python'
last_item = languages[-1]    # 示例输出: 'C++'
third_item = languages[2]    # 示例输出: 'Rust'

# 3. 原地修改元素
languages[1] = 'TypeScript'  # 替换索引为 1 的元素
# languages 现在为: ['Python', 'TypeScript', 'Rust', 'Go', 'C++']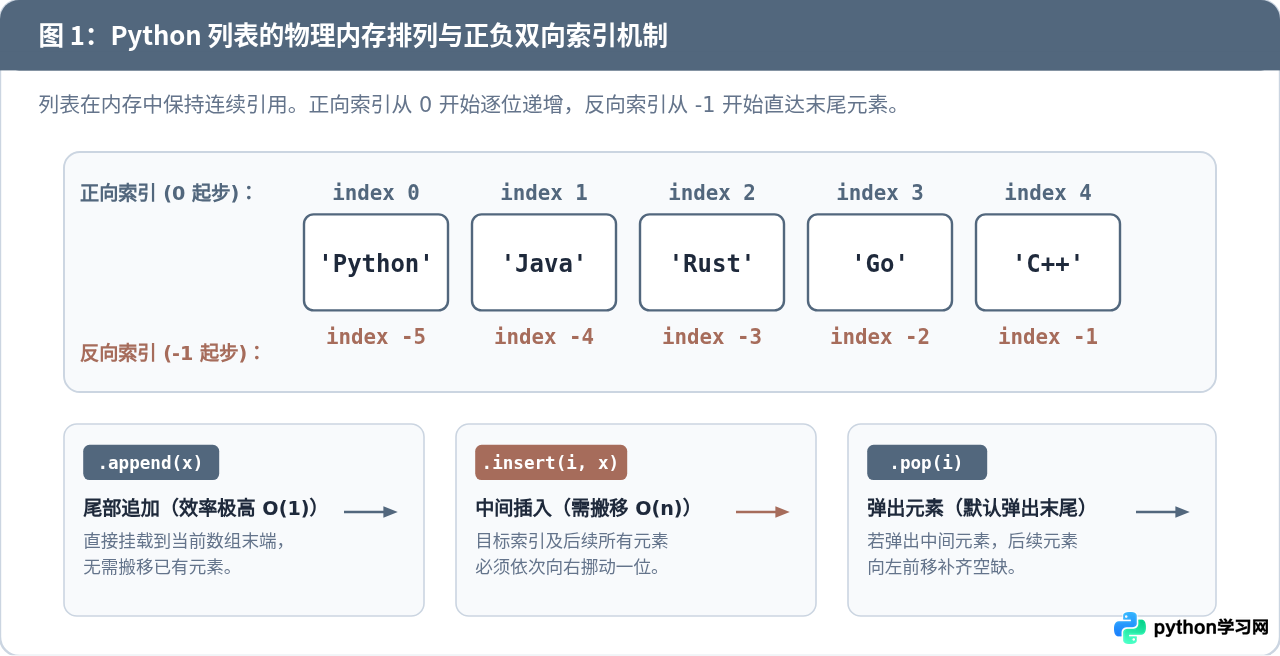
2. 元素的动态增删改查
列表的长度是动态可变的,Python 提供了高度优化的内置方法来维护列表元素:
- 追加与插入:
append(x)将元素直接追加到列表末端,执行极快;insert(i, x)将元素插入到指定索引位置,其后所有元素会顺延后移。 - 删除元素:
pop(i)移除并返回指定索引的元素(缺省参数时弹出末尾元素);remove(x)则根据元素的值查找并删除首个匹配项;del关键字亦可按索引删除。 - 批量合并:
extend(iterable)可以将另一个序列中的所有元素整体追加到当前列表中,与单个append插入完整列表有本质区别。
tasks = ['数据清洗', '特征提取']

# 追加元素至末尾
tasks.append('模型训练')          # ['数据清洗', '特征提取', '模型训练']

# 指定位置插入
tasks.insert(1, '探索性分析')      # ['数据清洗', '探索性分析', '特征提取', '模型训练']

# 弹出末尾元素并接收
finished = tasks.pop()           # 返回 '模型训练'

# 根据值删除指定项
tasks.remove('探索性分析')

# 列表批量合并
tasks.extend(['模型调优', '指标评估'])
# 最终 tasks: ['数据清洗', '特征提取', '模型调优', '指标评估']
3. 列表切片(Slicing):灵活截取子序列
切片是列表最强大的特性之一,通用语法为 list[start:end:step],遵循“左闭右开”原则(包含 start,但不包含 end)。
scores = [85, 92, 78, 64, 99, 88, 76]

top_three = scores[0:3]     # 截取前 3 项: [85, 92, 78]
sub_list = scores[2:5]      # 截取索引 2 到 4: [78, 64, 99]
every_second = scores[::2]  # 步长为 2 隔位抽样: [85, 78, 99, 76]
reversed_list = scores[::-1] # 步长为 -1 实现列表翻转① 当访问不存在的索引(例如长度为 3 的列表中访问
lst[5])时,会抛出 IndexError: list index out of range。在不确定长度时,建议先使用 len(lst) 确认或捕获异常。② 切勿在
for item in lst: 循环中直接使用 remove() 或 del 删除正在遍历的列表元素。这会导致内部索引偏移引起“跳过元素”逻辑错误;正确做法是遍历该列表的切片副本 lst[:] 或采用列表推导式生成新列表。
二、字典(Dictionary):键值对映射与常数级极速查找
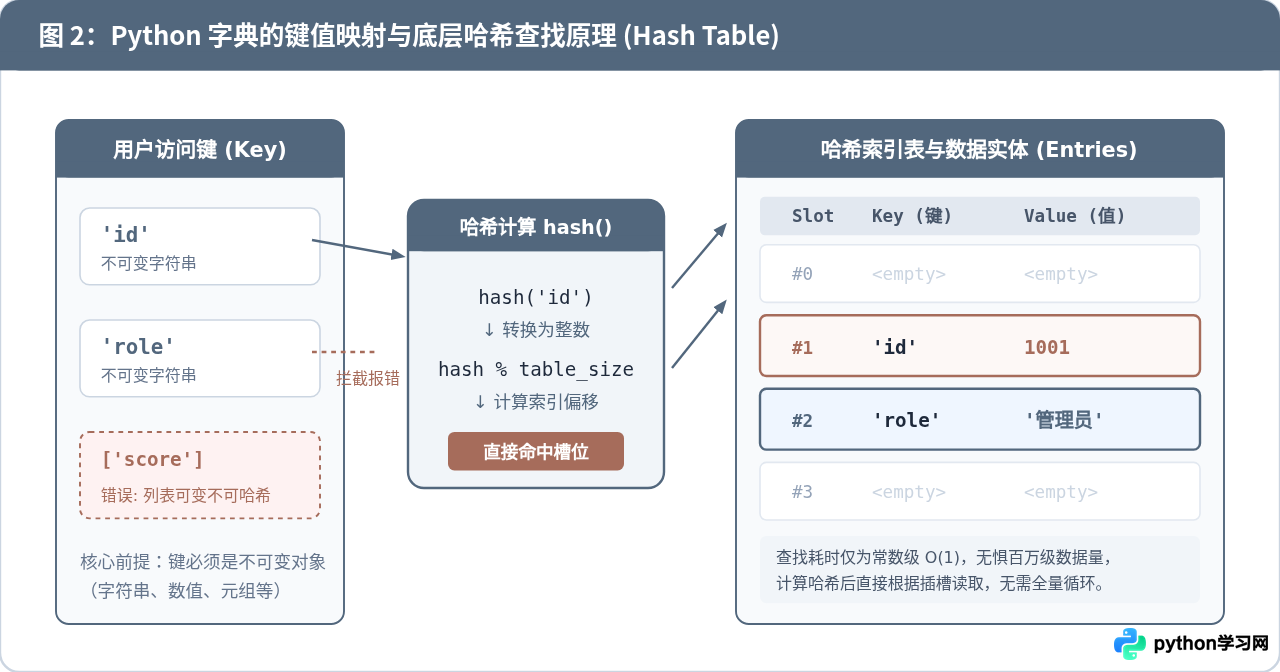
字典是 Python 中基于哈希表(Hash Table)实现的键值对容器,使用大括号 { } 声明,每一项由“键(Key)”和“值(Value)”组成,形式为 key: value。字典的核心使命是建立语义属性与数据的直接关联,实现无论总数据量多大都能在近乎常数时间 $O(1)$ 内找到目标。
1. 键(Key)的核心要求与声明
理解字典的关键在于理解“键”的约束:
- 键必须唯一:若重复对同一个键赋值,新值将直接覆盖旧值。
- 键必须是不可变对象(Hashable):字符串、整数、浮点数、元组(内含不可变对象)可以作为键;而列表、字典、集合等可变容器绝不能作为键,否则会触发
TypeError: unhashable type: 'list'。 - 值(Value)不受限制:值可以是任意数据类型,包括嵌套的列表、字典甚至函数。
# 字典的基础定义
student = {
    'id': 20260101,
    'name': '李雷',
    'major': '计算机科学',
    'scores': [88, 95, 91]  # 值为列表
}

# 新增与修改(语法完全一致)
student['grade'] = '大三'    # 键不存在,新增键值对
student['major'] = '软件工程' # 键已存在,直接更新值
2. 安全读取:方括号索引 vs .get() 方法
读取字典数据有两种方式,在实际开发中有截然不同的稳健性差异:
user = {'username': 'coder_dev', 'status': 'active'}

# 方式一:中括号直接取值(键不存在时直接崩溃)
print(user['username'])  # 示例输出: 'coder_dev'
# print(user['email'])   # 抛出 KeyError: 'email'!程序崩溃中断

# 方式二:.get() 友好防崩取值(推荐)
email = user.get('email')              # 键不存在返回 None,绝不报错
role = user.get('role', 'standard_user') # 可提供默认缺省值
print(role)                            # 示例输出: 'standard_user'
3. 字典的遍历技巧
Python 字典提供了 keys()、values() 以及 items() 三种视图对象,其中 items() 能够同时解包获取键与值,是日常遍历最规范的书写方式。
config = {'host': '127.0.0.1', 'port': 8080, 'debug': True}

# 同时获取键与值
for key, value in config.items():
    print(f"配置项: {key} -> 当前值: {value}")

# 示例输出:
# 配置项: host -> 当前值: 127.0.0.1
# 配置项: port -> 当前值: 8080
# 配置项: debug -> 当前值: True
三、实战选型与嵌套组合:何时用列表,何时用字典?
初学者常困惑于何时使用列表、何时使用字典。简明判断法是:如果数据关注的是次序、排队、位置索引,用列表;如果数据关注的是属性名、标签对照、唯一标记快速检索,用字典。而在真实开发中,二者往往结合使用。
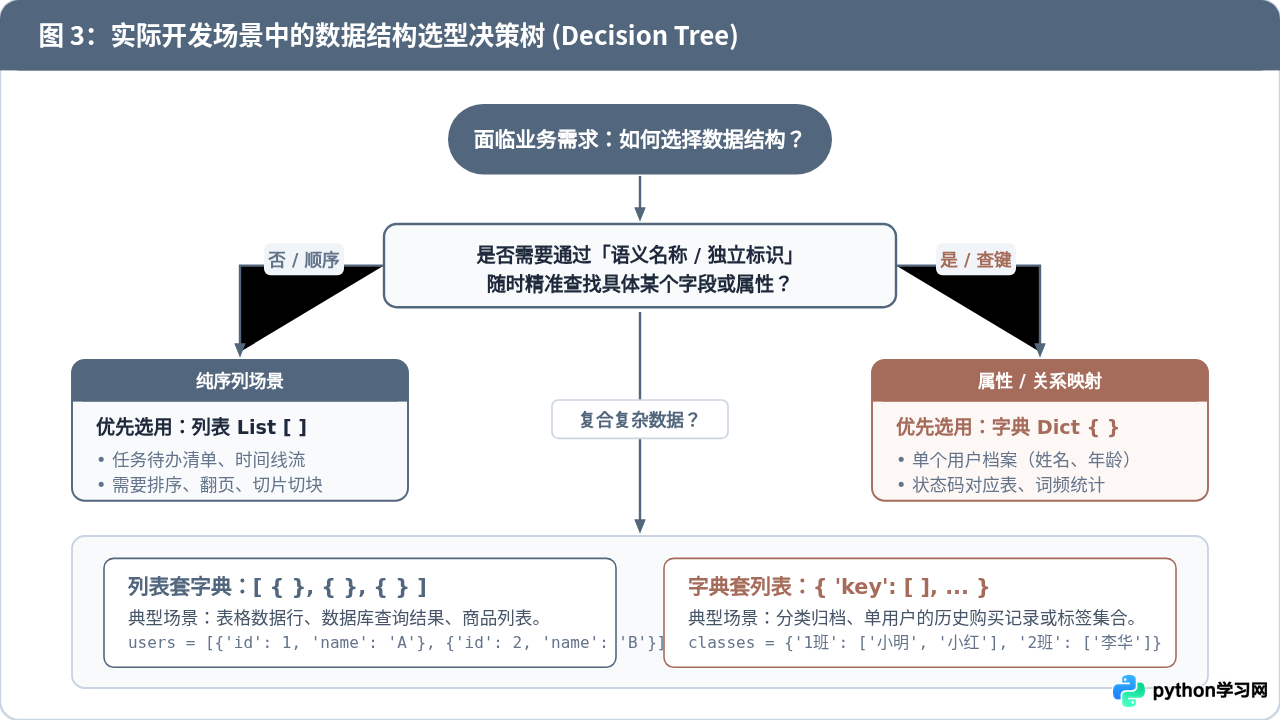
场景演练:列表与字典的高频嵌套模式
模式一:列表嵌套字典(表格型数据)。这对应现实世界中的数据行,每一行都是一个具有相同属性结构的字典实体:
# 员工信息列表(非常贴合数据库查询或 Excel 数据)
employees = [
    {'id': 101, 'name': '张三', 'department': '技术部', 'salary': 15000},
    {'id': 102, 'name': '李四', 'department': '市场部', 'salary': 12000},
    {'id': 103, 'name': '王五', 'department': '技术部', 'salary': 18000}
]

# 业务过滤:统计技术部员工的平均工资
tech_salaries = [emp['salary'] for emp in employees if emp['department'] == '技术部']
avg_salary = sum(tech_salaries) / len(tech_salaries)
print(f"技术部平均薪资: {avg_salary}") # 示例输出: 16500.0模式二:字典嵌套列表(分类归档数据)。以标签或分类为键,将同类对象归入列表之中:
# 按省份聚合城市列表
regions = {
    '广东省': ['广州', '深圳', '珠海'],
    '浙江省': ['杭州', '宁波', '温州']
}

# 新增某个省份的新城市
regions['广东省'].append('佛山')
print(regions['广东省'])  # 示例输出: ['广州', '深圳', '珠海', '佛山']
四、核心操作全景对比与速查总结
下表与图示全面总结了 Python 列表与字典在定义语法、读写访问、增删改查以及成员检测等维度的具体差异与适用建议:
| 对比维度 | 列表 (List) | 字典 (Dictionary) | 实战建议 |
|---|---|---|---|
| 语法符号 | [item1, item2] |
{key: value} |
列表用方括号,字典用大括号键值对 |
| 元素标识 | 基于从 0 开始的整数索引 | 基于不可变哈希键(如字符串、数字) | 字典键不可重复,列表元素允许重复 |
| 读取元素 | lst[index] |
d.get(key, default) |
查字典首选 get() 避免抛出 KeyError |
| 成员检测 (in) | val in lst:扫描对比,耗时 $O(n)$ |
key in d:哈希直达,耗时 $O(1)$ |
海量数据频繁检查“是否存在”时务必用字典或集合 |
| 保持次序 | 严格保证插入与索引顺序 | Python 3.7+ 官方保证保留插入顺序 | 列表支持按指定步长与方向切片截取 |
| 适用场景 | 序列数据、批处理任务流、需要切片切块 | 结构体、属性映射表、配置参数、实体对象 | 二者互相嵌套可表达绝大多数复杂商业数据 |
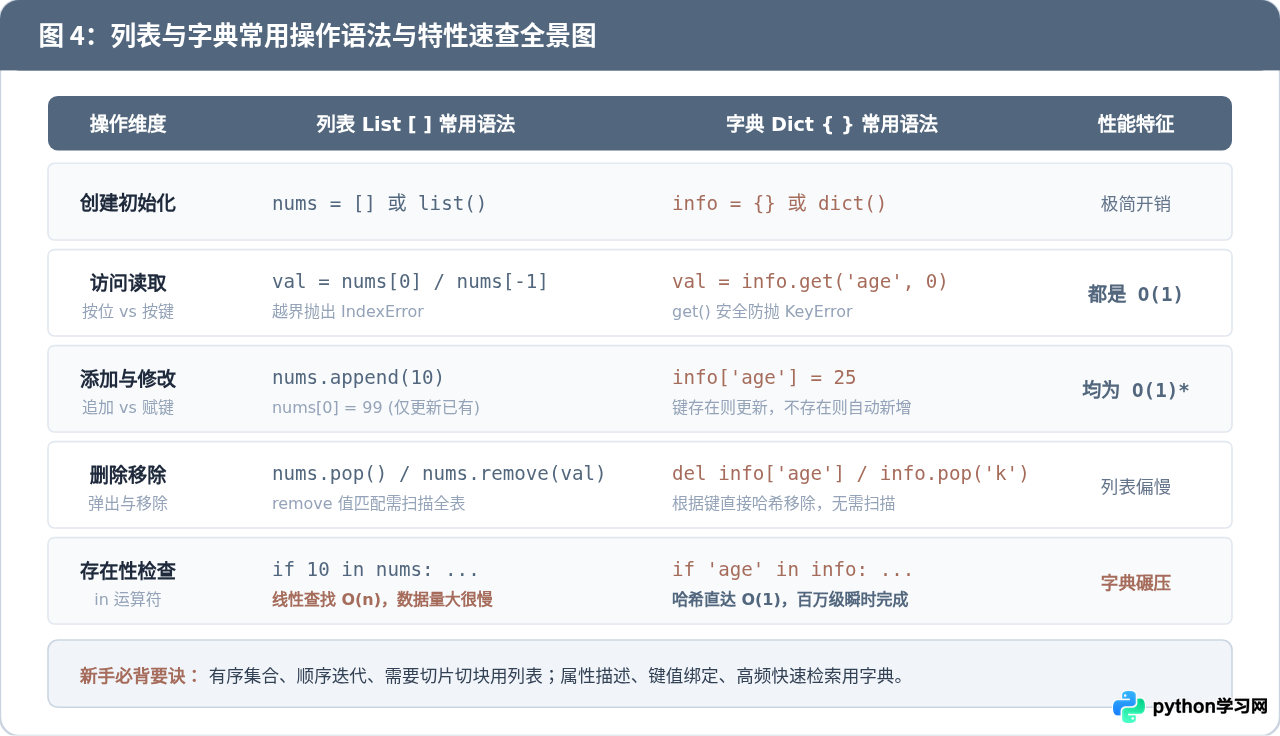
掌握 Python 列表与字典,并不需要死记硬背所有底层 API。核心逻辑可以概括为两句话:“列表靠位置排队,遍历切片最在行;字典靠键名索引,属性查找快如光”。在日常写代码时,先停顿一秒思考“我需要按顺序排,还是按名称查?”,自然就能选对最恰当的数据容器。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









