

Python能做什么?数据分析、Web开发与自动化办公场景介绍
深入解析Python在自动化办公、Web后端开发与数据分析三大核心场景中的实际应用,通过具体操作代码、核心工具链解析、架构流程图与技术选型建议,帮助读者建立清晰的Python实用认知。
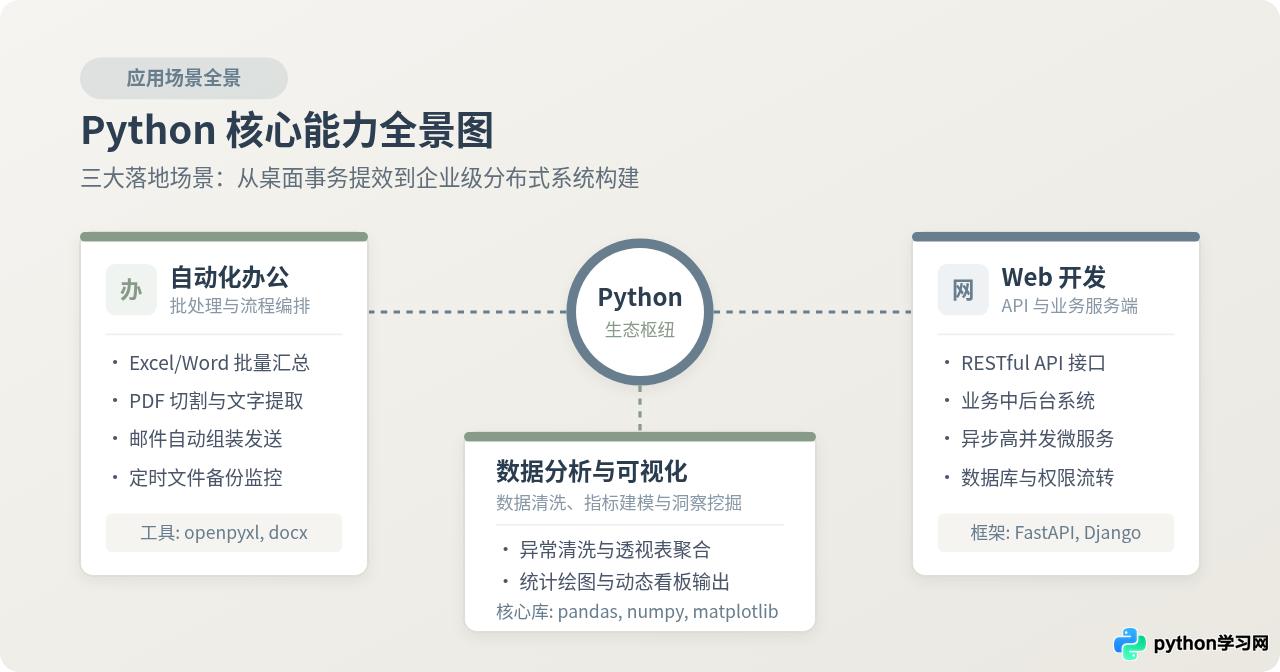
一、自动化办公:批量处理与流程自动化
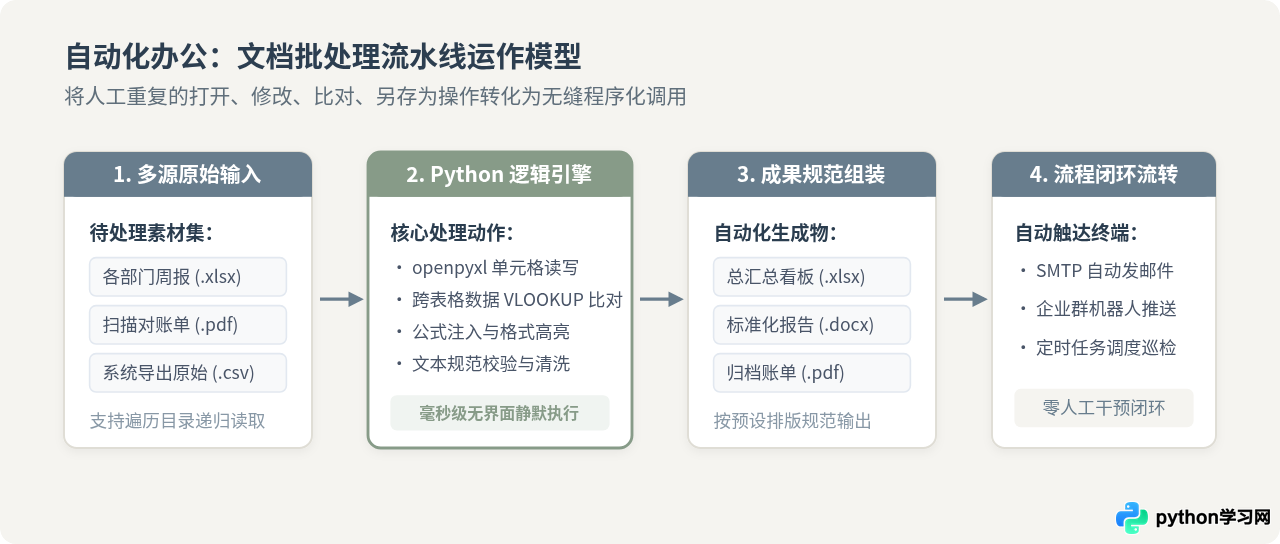
日常办公中经常充斥着高度机械化的文件流转任务:每周合并几十个部门提交的销售明细表、核对银行回单与开票系统的数值偏差、从数百页合同样本中抽取关键签署人与金额,或是定时向各区域负责人发送定制化汇总邮件。人工手动点击操作不仅耗时冗长,而且随着重复次数增加,疏漏率直线上升。
Python 自动化办公正是通过代码接管人机交互界面,直接在底层读写办公文档的数据结构,将“手动打开、逐行核对、复制粘贴、另存为”转化为标准化的批处理流水线。
关键差异:Python 脚本化处理与 Excel 传统 VBA 宏
理解自动化办公时,常需要对比 Python 脚本与微软原装 Excel VBA 宏这两种做法。二者均能实现表格自动化,但差异对实际工程产生决定性影响:
- 运行环境与软件依赖:VBA 运行强依赖本地已安装的 Microsoft Office 宿主环境,缺乏对 WPS、Linux 服务器或 macOS 的一致兼容性;而 Python 是独立的控制台程序,无需在计算机后台唤起任何 Office 客户端窗口,即可无界面(Headless)静默完成运算。
- 跨生态协同能力:VBA 的控制边界通常局限在单个 Office 办公套件内部,若要联动 PDF 文字识别、企业微信群机器人推送、数据库直接写入或多线程大批文件遍历,代码复杂度极高;Python 则拥有标准化包管理器,通过一行
pip install即可无缝串联 Excel(openpyxl)、Word(python-docx)、PDF(pypdf)与邮件(smtplib),形成端到端的闭环流水线。
实操示例:销售业绩自动汇总与超标标记
以月度业绩核算为例,假设我们需要读取多名销售人员的原始订单表格,计算各自的总成交金额,并对超过 10,000 元达标门槛的人员自动标记为“优秀”,最终输出一张结构规整的统计总表。
import openpyxl
from openpyxl.styles import Font, PatternFill

def generate_monthly_report(raw_data, output_file):
    # 创建全新工作簿并初始化工作表
    wb = openpyxl.Workbook()
    ws = wb.active
    ws.title = "月度业绩汇总"

    # 写入表头
    headers = ["员工编号", "姓名", "总销售额", "绩效评级"]
    ws.append(headers)

    # 预设高亮样式:鼠尾草绿背景,加粗文字
    highlight_fill = PatternFill(start_color="D6E4D8", end_color="D6E4D8", fill_type="solid")
    bold_font = Font(name="PingFang SC", size=11, bold=True)

    # 逐行处理业务数据
    for emp_id, name, sales in raw_data:
        # 判断业务规则
        if sales >= 10000:
            rating = "优秀 (达标)"
            is_highlight = True
        else:
            rating = "常规"
            is_highlight = False

        # 追加数据行
        ws.append([emp_id, name, sales, rating])

        # 若达标,将当行单元格应用高亮样式
        if is_highlight:
            current_row = ws.max_row
            for col_idx in range(1, 5):
                cell = ws.cell(row=current_row, column=col_idx)
                cell.fill = highlight_fill
                cell.font = bold_font

    # 设置数值列货币显示格式
    for row in range(2, ws.max_row + 1):
        ws.cell(row=row, column=3).number_format = '¥#,##0.00'

    wb.save(output_file)
    print(f"[完成] 报表已成功生成并写入: {output_file}")

if __name__ == "__main__":
    records = [
        ("E101", "张三", 12500),
        ("E102", "李四", 8300),
        ("E103", "王五", 16800),
        ("E104", "赵六", 9400),
    ]
generate_monthly_report(records, "2026年10月业绩汇总.xlsx")$ python3 batch_sales_summary.py
[完成] 报表已成功生成并写入: 2026年10月业绩汇总.xlsx
PermissionError: [Errno 13] Permission denied,运行前必须关闭相关表格;二是用 openpyxl 读取带有计算公式的表格时,默认读取到的是公式字符串(如 =SUM(A1:A10)),若需读取实际运算结果值,须在加载时显式传入参数 load_workbook(filename, data_only=True)。
二、Web 开发:API 服务与业务系统后端
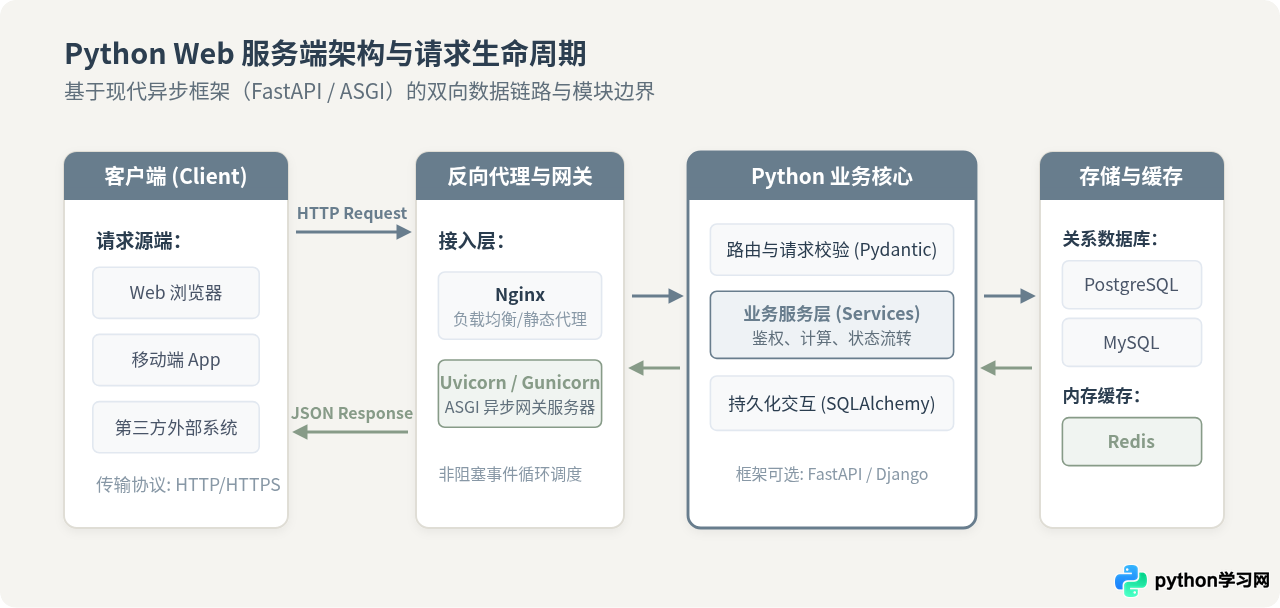
Web 开发是 Python 在工程架构领域的核心阵地。日常接触到的互联网产品中,网页前端与手机客户端所展示的个人主页、订单状态、商品列表,均由后端服务器接收网络请求、执行鉴权校验、查询持久化数据库后以统一的 JSON 格式响应返回。
Python 拥有深厚的服务端框架生态,从支持高并发微服务接口的现代异步框架,到开箱即配齐管理后台的企业级全栈框架,覆盖了中小型项目到大型互联网应用的不同阶段。
关键差异:FastAPI 与 Django 的架构取向
在 Python Web 生态中,最典型的两种技术选型方案是现代轻量型的 FastAPI 与全功能型的 Django:
- Django 的一体化设计(Batteries-Included):Django 遵循“开箱即用”哲学,自带对象关系映射(ORM)、用户认证体系、表单校验机制以及功能完备的后台管理界面(Admin)。其优势在于构建复杂度高、需要内部运营后台的传统管理系统时极为高效;但对于当下流行的前后端分离与移动端 API 架构而言,其庞大的默认组件往往显得繁重。
- FastAPI 的类型驱动与异步设计:FastAPI 基于现代 Python 的类型提示(Type Hints)与 ASGI 规范设计。它不仅具备极高的数据吞吐性能,还能根据代码中声明的 Pydantic 数据模型,自动生成符合 OpenAPI 标准的交互式 API 文档页面(Swagger UI),在微服务与纯接口开发场景中大幅降低前后端沟通成本。
实操示例:基于 FastAPI 快速实现待办任务 RESTful API
以下示例展示如何利用 FastAPI 编写一个包含输入验证、条件筛选与错误返回的标准 HTTP 接口:
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
from typing import List, Optional

app = FastAPI(title="任务管理服务", description="演示 Python Web API 的构建与参数验证")

# 定义数据结构与入参约束
class TaskItem(BaseModel):
    id: int
    title: str = Field(..., min_length=2, max_length=50, description="任务标题")
    is_completed: bool = False

# 内存模拟数据源
task_database: List[TaskItem] = [
    TaskItem(id=1, title="整理周报数据", is_completed=True),
    TaskItem(id=2, title="配置生产服务器代理", is_completed=False),
]

@app.get("/api/tasks", response_model=List[TaskItem])
def list_tasks(completed: Optional[bool] = None):
    """查询任务列表,支持按完成状态筛选"""
    if completed is not None:
        return [t for t in task_database if t.is_completed == completed]
    return task_database

@app.post("/api/tasks", response_model=TaskItem, status_code=201)
def create_task(task: TaskItem):
    """创建新任务,自动校验任务ID唯一性"""
    if any(existing.id == task.id for existing in task_database):
        raise HTTPException(status_code=400, detail="该任务ID已存在,请勿重复创建")
    task_database.append(task)
return task$ uvicorn main:app --host 127.0.0.1 --port 8000 --reload
INFO: Uvicorn running on http://127.0.0.1:8000 (Press CTRL+C to quit)
INFO: Started reloader process [PID 45892]
INFO: Application startup complete.
$ curl -X GET "http://127.0.0.1:8000/api/tasks?completed=false"
[{"id":2,"title":"配置生产服务器代理","is_completed":false}]
三、数据分析与可视化:从原始数据到业务洞察
在企业运营、金融分析与学术科研领域,数据分析师面临的核心挑战是海量、异构且伴随脏数据的原始输入。从数据库直接导出的数十万行用户行为日志中,往往夹杂着空值、格式不一致的时间字符串与异常极值。数据分析的本质,就是把混乱的无序记录逐步加工成清晰的业务指标。
Python 在该领域的支配地位源于其标准“科学计算技术栈”:由底层的高性能数值计算库 NumPy、上层的数据切片与重塑工具 pandas,以及专业制图库 Matplotlib / Seaborn 紧密啮合构成。
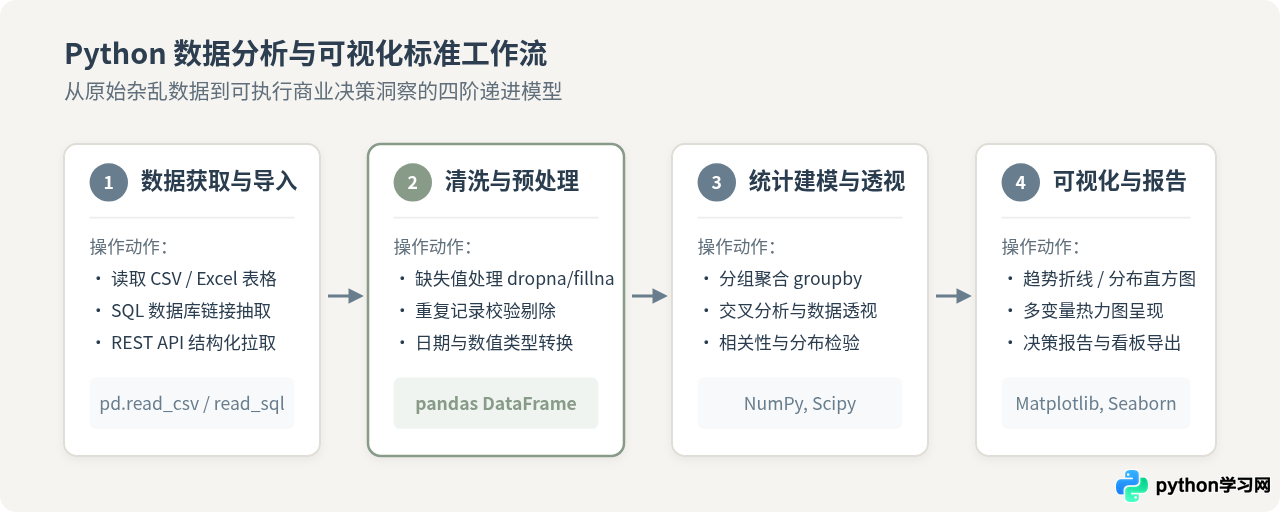
关键差异:pandas 向量化计算与普通 Python 循环遍历
在处理数万至数百万行数据时,很多初学者习惯用内置的 for row in data: 循环逐行计算,这种做法与 pandas 的向量化计算(Vectorized Operations)有着本质区别:
- 运算性能与底层实现:Python 内置的
for循环在解释器中逐行进行动态类型解包与函数调用,处理十万条记录耗时通常在数秒甚至数十秒;而 pandas 的向量化计算底层由高度优化的 C 语言与 Fortran 连续内存块驱动,将整列数据直接推送到 CPU SIMD 指令集批量计算,运算时间可缩短至毫秒级别。 - 代码语义与维护性:使用向量化操作只需书写如
df['profit'] = df['revenue'] - df['cost'],语义清晰直观,避免了在多层循环中维护临时变量和下标索引,大幅降低逻辑越界与漏算风险。
实操示例:销售日志清洗、分组聚合与指标提炼
下面展示一段完整的数据清洗与统计分析代码:输入包含缺失值与格式混乱的原始交易流水,完成数据清洗后,计算各商品品类的总成交量、平均客单价与最大交易金额。
import pandas as pd
import numpy as np

# 构造模拟原始交易数据(包含空值与负数异常)
raw_sales = {
    "订单号": ["ORD-001", "ORD-002", "ORD-003", "ORD-004", "ORD-005", "ORD-006"],
    "商品类别": ["办公电子", "日用耗材", "办公电子", "办公家具", "日用耗材", "办公电子"],
    "销售单价": [1200, 45, 1350, np.nan, 52, 980],
    "销售数量": [3, 100, -1, 4, 80, 5],
}

df = pd.DataFrame(raw_sales)

# 阶段一:数据清洗
# 1. 过滤销售数量小于等于0的异常退单或错误记录
df_clean = df[df["销售数量"] > 0].copy()

# 2. 对缺失单价按品类均值或指定规则进行填充(此处剔除缺失行)
df_clean = df_clean.dropna(subset=["销售单价"])

# 3. 计算单笔总金额
df_clean["总交易额"] = df_clean["销售单价"] * df_clean["销售数量"]

# 阶段二:分组统计分析 (Groupby)
summary = df_clean.groupby("商品类别").agg(
    订单总数=("订单号", "count"),
    总销售额=("总交易额", "sum"),
    平均客单价=("总交易额", "mean"),
    单笔最大额=("总交易额", "max")
).reset_index()

# 按总销售额降序排列
summary = summary.sort_values(by="总销售额", ascending=False)

print("=== 最终品类业绩透视看板 ===")
print(summary.to_string(index=False))$ python3 analyze_sales.py
=== 最终品类业绩透视看板 ===
商品类别 订单总数 总销售额 平均客单价 单笔最大额
办公电子 2 8500.0 4250.0 4900.0
日用耗材 2 8660.0 4330.0 4500.0
SettingWithCopyWarning。这是因为 pandas 无法确认当前对象是对原数据的视图(View)还是深拷贝(Copy)。在切片过滤后显式调用 .copy()(如示例中的 df[...].copy()),能确保操作在独立内存空间中进行,从根源上杜绝潜在的链式赋值静默错误。
四、三大方向综合对比与选型决策
在面对“我应该学哪一个”、“我的项目该用哪个方向”的问题时,关键在于将业务目标与投入成本做精准对齐。各场景在学习坡度、前置知识与见效周期上存在显著差异,下表对三大核心场景的关键维度进行了系统化对照:
| 对比维度 | 自动化办公 (Office Automation) | Web 开发 (Web Development) | 数据分析 (Data Analysis) |
|---|---|---|---|
| 主要服务对象 | 个人提效、部门内部文件流转 | 外部终端用户、跨系统 API 调用方 | 管理层战略决策、业务运营与研究团队 |
| 典型见效周期 | 极短(1 ~ 2 周即可编写单功能脚本) | 较长(需 1 ~ 2 个月掌握网络与数据库全流程) | 适中(2 ~ 4 周掌握基础报表清洗与出图) |
| 前置基础知识 | Python 基础语法、文件路径与基本循环 | HTTP 网络协议、数据库(SQL)、认证鉴权 | 基础统计学、业务理解、数据结构变换思维 |
| 典型工具生态 | openpyxl, python-docx, pypdf, smtplib | FastAPI, Django, Flask, SQLAlchemy, Uvicorn | pandas, NumPy, Matplotlib, Seaborn, Jupyter |
| 成果交付形式 | 本地运行脚本、整理后的 Excel/PDF 汇总文件 | 在线可调用的 RESTful API、完整后台管理系统 | 动态分析仪表盘、统计图表、清洗后数据仓库 |
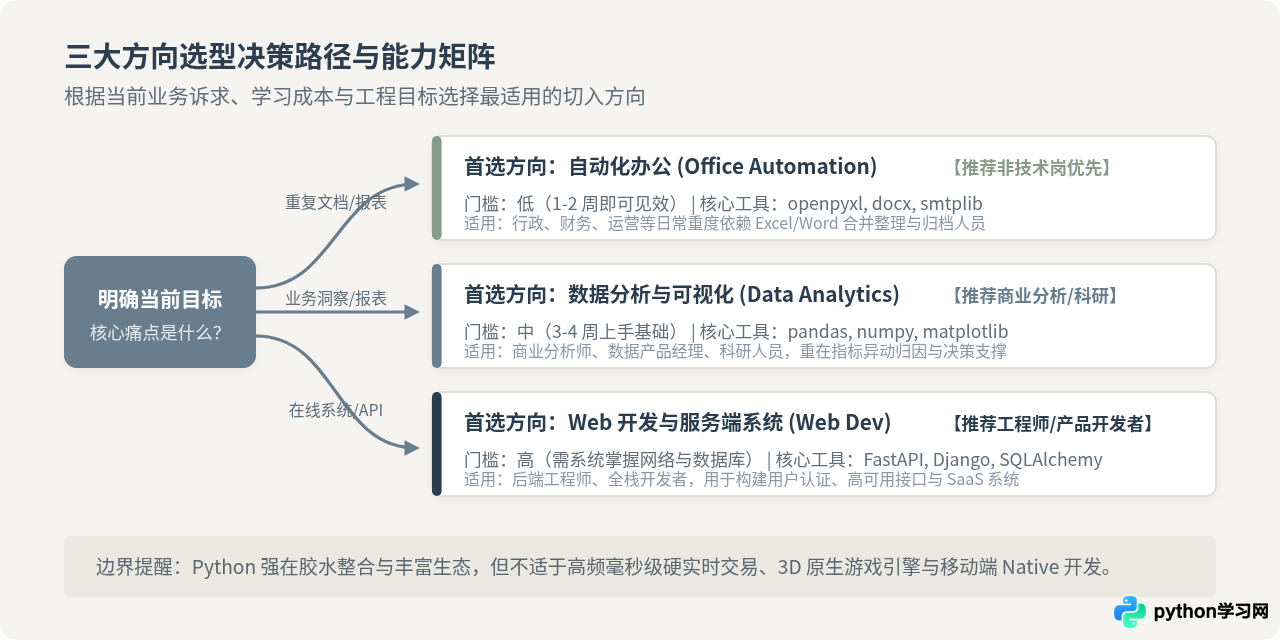
根据实际目标的路径建议
- 若当前处于非技术岗位,痛点在于报表繁复:建议直接从自动化办公切入。以
openpyxl为核心,先解决单个 Excel 的行列合并与格式导出。由于输入输出都是肉眼可见的本地文件,反馈即时,最容易建立正向学习循环。 - 若目标是独立开发产品、上线独立工具或从事后端研发:建议选择 Web 开发。推荐从
FastAPI起步,掌握标准的 HTTP 请求方法、状态码定义与关系型数据库操作,逐步建立现代微服务与分布式系统的架构思维。 - 若岗位涉及业务运营、市场洞察或科研统计:建议聚焦于数据分析。重点攻克
pandas的数据重塑与分组聚合方法,结合Seaborn绘制直观图表,将重心放在“从数据中提炼出哪些业务结论”上,而非单纯追求代码量。
Python 的客观局限与适用边界
在充分认识 Python 优势的同时,也需理性看待其工程边界:
- 非原生移动端与大型 3D 游戏首选:尽管有 Kivy 等实验性库,但在 iOS/Android 原生应用开发中,Swift 与 Kotlin/Flutter 在性能和系统适配上具有绝对优势;同理,高负荷的 3D 游戏引擎底层依然是 C++ 与 C# 的天下。
- 硬实时与微秒级高频交易限制:由于解释执行机制以及全局解释器锁(GIL)的存在,Python 不适合用于航天飞控、高频微秒级撮合系统等对垃圾回收延迟有严苛硬实时要求的极端场景。
明确这些适用边界,有助于技术决策者在架构设计中扬长避短,将 Python 部署在最能发挥其胶水整合能力与极速迭代优势的业务环节中。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









