

Python Scrapy结合Selenium处理动态加载数据详解

本文详解如何在Scrapy框架中集成Selenium以解决动态加载数据的抓取难题。通过重写爬虫构造方法与关闭方法管理浏览器实例,并在下载中间件中拦截Response对象,利用Selenium渲染页面后篡改响应数据,从而在Spider中获取完整的动态内容。
引言
引言
在使用Scrapy框架进行网站数据爬取时,常会遇到页面动态加载数据的情况。若直接通过Scrapy向URL发送请求,无法获取这些动态生成的数据值。然而观察发现,通过浏览器访问同一URL时,动态数据能够正常加载。因此,若要在Scrapy中获取此类动态数据,必须借助Selenium创建浏览器对象,并通过该对象发送请求以提取动态加载的数据。
案例分析与需求
1. 案例分析:
- 需求:爬取网易新闻的国内、国际、军事、无人机板块下的新闻数据
- 需求分析:当点击国内超链接进入对应页面时,会发现当前页面展示的新闻数据是通过动态加载生成的。如果直接通过程序对URL发起请求,将无法获取这些动态加载的新闻数据。因此,需要使用Selenium实例化一个浏览器对象,并在该对象中执行URL请求,以获取动态加载的新闻数据。
Selenium在Scrapy中的工作原理
2. Selenium在Scrapy中使用的原理分析:
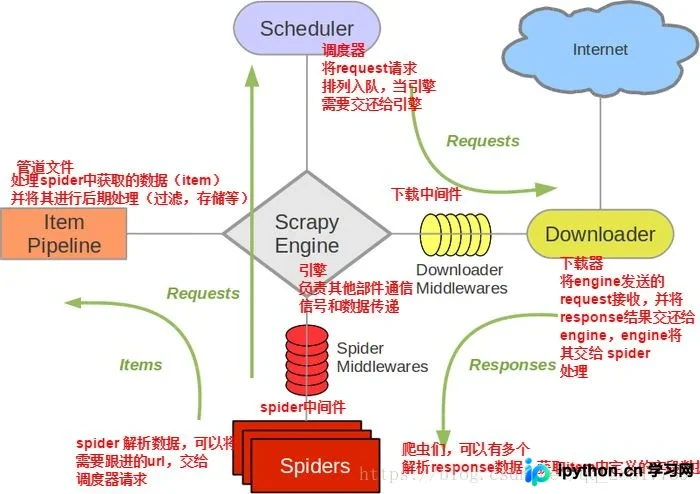
当引擎将国内板块URL对应的请求提交给下载器后,下载器负责网页数据的下载,并将下载到的页面数据封装到Response对象中,随后提交给引擎。引擎再将Response转交给Spider。此时,Spider接收到的Response对象中存储的页面数据不包含动态加载的新闻数据。为了获取动态加载的新闻数据,需要在下载中间件中拦截下载器提交给引擎的Response响应对象,并篡改其内部存储的页面数据,将其修改为包含动态加载出的新闻数据的形式,然后将被篡改后的Response对象最终交给Spider进行解析操作。
Selenium集成Scrapy的使用流程
3. Selenium在Scrapy中的使用流程:
- 重写爬虫文件的构造方法,在该方法中使用Selenium实例化一个浏览器对象(因为浏览器对象只需要被实例化一次)
- 重写爬虫文件的closed(self, spider)方法,在其内部关闭浏览器对象。该方法是在爬虫结束时被调用
- 重写下载中间件的process_response方法,让该方法对响应对象进行拦截,并篡改Response中存储的页面数据
- 在配置文件中开启下载中间件
代码实例展示
4. 实例:
# 1.spider文件

import scrapy
from wangyiPro.items import WangyiproItem
from selenium import webdriver

class WangyiSpider(scrapy.Spider):
  name = 'wangyi'
  # allowed_domains = ['www.xxx.con']
  start_urls = ['https://news.163.com/']
  # 浏览器实例化的操作只会被执行一次
  bro = webdriver.Chrome(executable_path='chromedriver.exe')

  urls = []# 最终存放的就是5个板块对应的url

  def parse(self, response):
    li_list = response.xpath('//*[@id="index2016_wrap"]/div[1]/div[2]/div[2]/div[2]/div[2]/div/ul/li')
    for index in [3,4,6,7,8]:
      li = li_list[index]
      new_url = li.xpath('./a/@herf').extract_first()
      self.urls.append(new_url)

      # 对5大板块对应的url进行请求发送
      yield scrapy.Request(url=new_url,callback=self.parse_news)

  # 用来解析每一个板块对应的新闻数据【只能解析到新闻的标题】
  def parse_news(self,response):
    div_list = response.xpath('//div[@class="ndi_main"]/div')
    for div in div_list:
      title = div.xpath('./div/div[1]/h3/a/text()').extract_first()
      news_detail_url = div.xpath('./div/div[1]/h3/a/@href').extract_first()
      # 实例化item对象,将解析到的标题和内容存储到item对象中
      item = WangyiproItem()
      item['title'] = title
      # 对详情页的url进行手动请求发送获得新闻内容
      yield scrapy.Request(url=news_detail_url,callback=self.parse_detail,meta={'item':item})

  def parse_detail(self,response):
    item = response.meta['item']
    # 通过response解析出新闻内容
    content = response.xpath('//div[@id="endText"]//text()').extract()
    content = ''.join(content)

    item['content'] = content
    yield item

  def close(self,spider):
    # 当爬虫结束之后,调用关闭浏览器方法
    print('爬虫整体结束~~~~~~~~~~~~~~~~~~~')
    self.bro.quit()
----------------------------------------------------------------------------------------
# 2.items文件

import scrapy

class WangyiproItem(scrapy.Item):
  # define the fields for your item here like:
  # name = scrapy.Field()
  title = scrapy.Field()
  content = scrapy.Field()
----------------------------------------------------------------------------------------
# 3.middlewares文件

from scrapy import signals
from scrapy.http import HtmlResponse
from time import sleep

class WangyiproDownloaderMiddleware(object):

  def process_request(self, request, spider):
    return None

  def process_response(self, request, response, spider):
    # 判断哪些响应对象是5个板块的,如果在就对响应对象进行处理
    if response.url in spider.urls:
      # 获取在爬虫类中定义好的浏览器
      bro = spider.bro
      bro.get(response.url)

      bro.execute_script('window.scrollTo(0,document.body.scrollHeight)')
      sleep(1)
      bro.execute_script('window.scrollTo(0,document.body.scrollHeight)')
      sleep(1)
      bro.execute_script('window.scrollTo(0,document.body.scrollHeight)')
      sleep(1)
      bro.execute_script('window.scrollTo(0,document.body.scrollHeight)')
      sleep(1)

      # 获取携带了新闻数据的页面源码数据
      page_text = bro.page_source
      # 实例化一个新的响应对象
      new_response = HtmlResponse(url=response.url,body=page_text,encoding='utf-8',request=request)
      return new_response
    else:
      return response

  def process_exception(self, request, exception, spider):
    pass
----------------------------------------------------------------------------------------
# 4.pipelines文件

class WangyiproPipeline(object):
  def process_item(self, item, spider):
    print(item)
    return item
----------------------------------------------------------------------------------------
# 5.setting文件
BOT_NAME = 'wangyiPro'

SPIDER_MODULES = ['wangyiPro.spiders']
NEWSPIDER_MODULE = 'wangyiPro.spiders'

USER_AGENT = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/76.0.3809.132 Safari/537.36'

ROBOTSTXT_OBEY = False

DOWNLOADER_MIDDLEWARES = {
  'wangyiPro.middlewares.WangyiproDownloaderMiddleware': 543,
}

ITEM_PIPELINES = {
  'wangyiPro.pipelines.WangyiproPipeline': 300,
}

LOG_LEVEL = 'ERROR'
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









