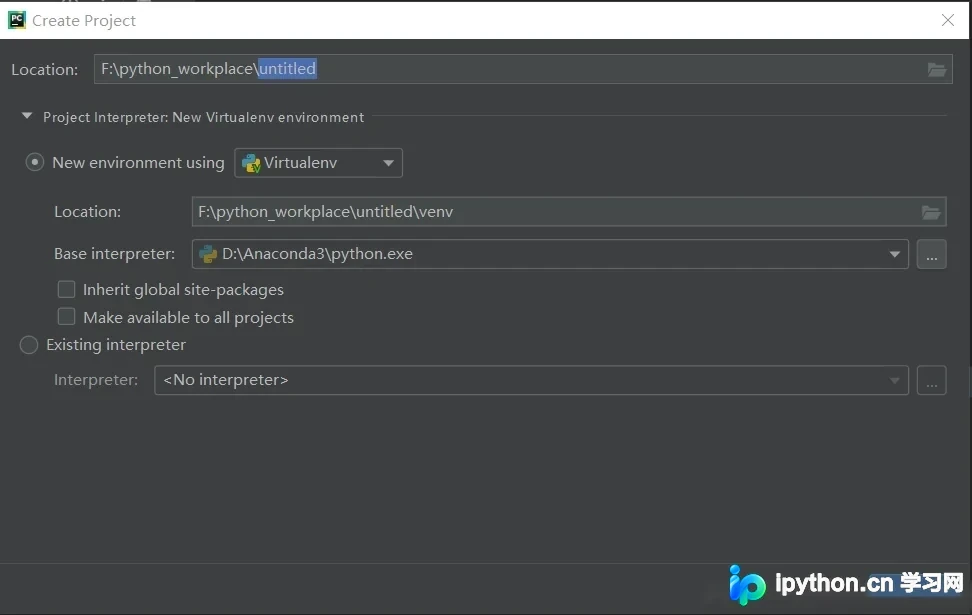
PyCharm中创建Scrapy项目的完整指南
本文详细介绍如何在PyCharm中快速创建Scrapy爬虫项目。主要步骤包括:新建Python项目、通过Settings配置并安装Scrapy库(建议更换下载源以防超时),最后利用Terminal终端执行scrapy startproject命令完成项目初始化。文章涵盖环境配置与命令行操作,帮助开发者高效搭建爬虫开发环境。
2026-10-14
6

本文详细介绍如何在PyCharm中快速创建Scrapy爬虫项目。主要步骤包括:新建Python项目、通过Settings配置并安装Scrapy库(建议更换下载源以防超时),最后利用Terminal终端执行scrapy startproject命令完成项目初始化。文章涵盖环境配置与命令行操作,帮助开发者高效搭建爬虫开发环境。
本文系统梳理Python Scrapy框架在爬虫开发中的关键注意事项。涵盖利用Redis实现分布式去重与存储、通过Middleware处理代理IP与Headers、合理配置Settings文件、使用FormRequest提交表单数据,以及结合PhantomJS处理动态渲染页面的技术方案。旨在帮助开发者提升爬取效率与稳定性,解决常见技术痛点。
本文详解Python Scrapy框架中项目数据的持久化处理方案。针对抓取数据需后期分析的需求,重点介绍如何将默认的文件存储切换至MySQL数据库。通过修改settings.py配置文件,启用SavetoMySQLPipeline并配置数据库连接参数,实现高效的数据存储与管理,避免文件散乱带来的检索难题。
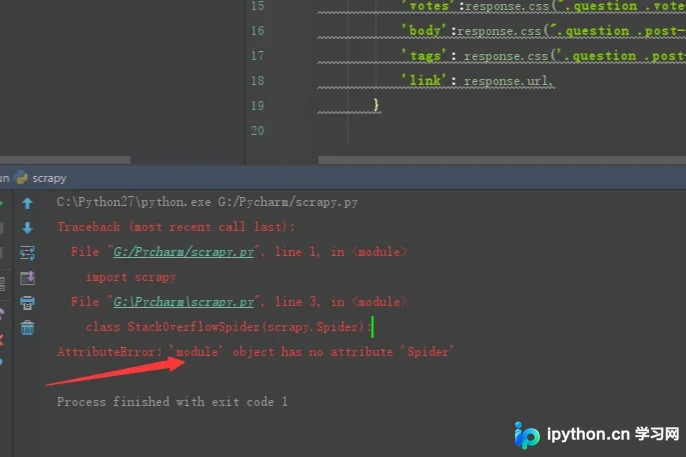
本文针对Python中使用Scrapy框架搭建爬虫时遇到的报错问题,深入分析了错误原因。核心问题在于用户自定义文件命名为scrapy.py,导致与Scrapy官方包名冲突,进而引发Spider属性查找错误。文章提供了具体的解决步骤和命名规范建议,帮助开发者快速定位并修复此类常见搭建错误,确保爬虫项目正常运行。
本文详解向 Scrapy Spider 传递参数的三种常用方式。首先介绍通过命令行 crawl 命令的 -a 选项传递参数;其次讲解利用 Scrapyd 的 schedule.json 接口发送 -d 参数;最后演示如何在 Request 中使用 meta 字段在解析函数间传递数据。通过具体代码示例,帮助开发者灵活控制爬虫行为并关联用户请求与页面数据。
本文记录在 Scrapy 项目中自定义 Cookie 中间件时遇到的坑:即使手动控制 Request 的 meta 标志位,账号仍被封禁。经排查发现 Scrapy 内置的 CookiesMiddleware(优先级 700)会在自定义中间件(优先级 500)之后自动合并 Cookie 到 Header。解决方案是在 Request meta 中设置 dont_merge_cookies 为 true,并手动将 Cookie 写入 Header 而非 request.cookies 属性,从而避免框架自动处理。
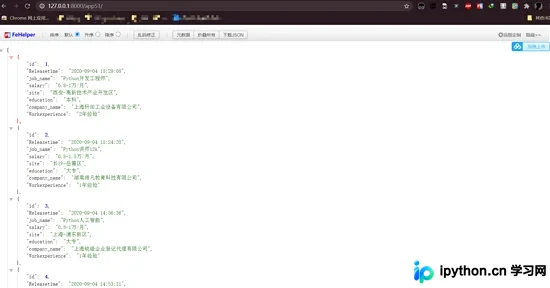
本文详细讲解如何将Django框架与Scrapy爬虫深度集成,实现从51job网站抓取数据、自动存入MySQL数据库,并通过Django视图生成标准JSON接口的完整流程。内容涵盖项目创建、setting配置、scrapy_djangoitem使用、反爬处理及数据库迁移等关键步骤。
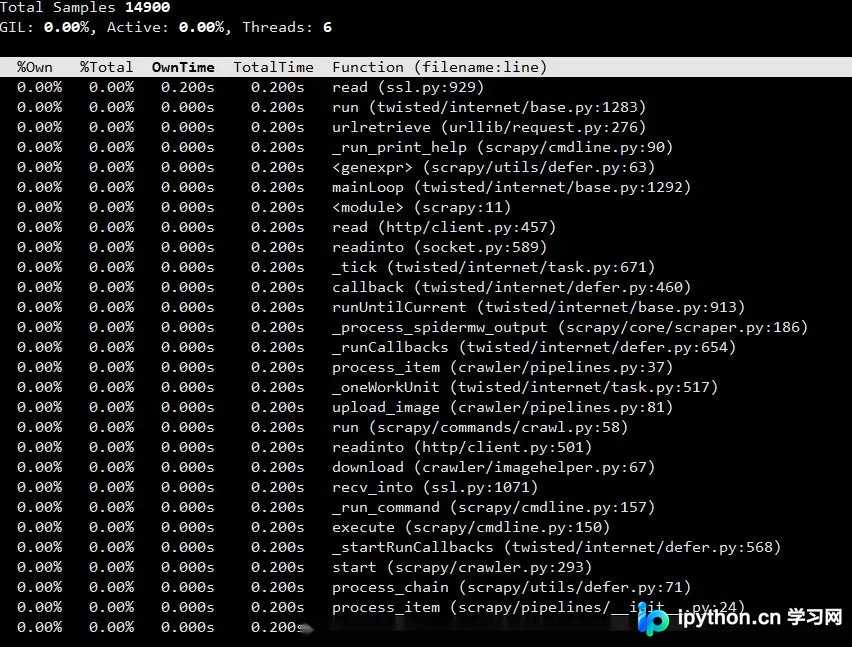
本文介绍如何使用py-spy工具排查Scrapy爬虫因网络IO导致的进程卡死问题。通过定位耗时函数发现urllib.urlretrieve缺乏超时参数,进而封装支持timeout的urlopen方法,有效解决爬虫进程堆积和数据延迟问题。
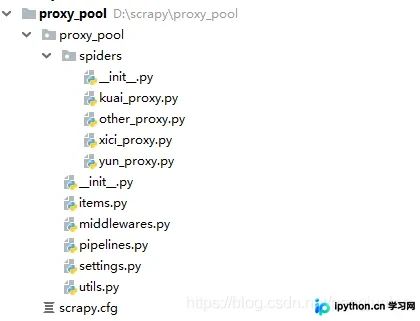
本文详细介绍如何使用Scrapy-Redis框架搭建高效的IP代理池。内容涵盖从快代理等网站批量爬取IP、通过请求验证IP可用性,以及利用Redis存储和管理代理池的完整流程。相比传统requests方案,该方法能显著提升爬取速度并解决高频访问限制问题,适合需要大规模数据采集的场景。
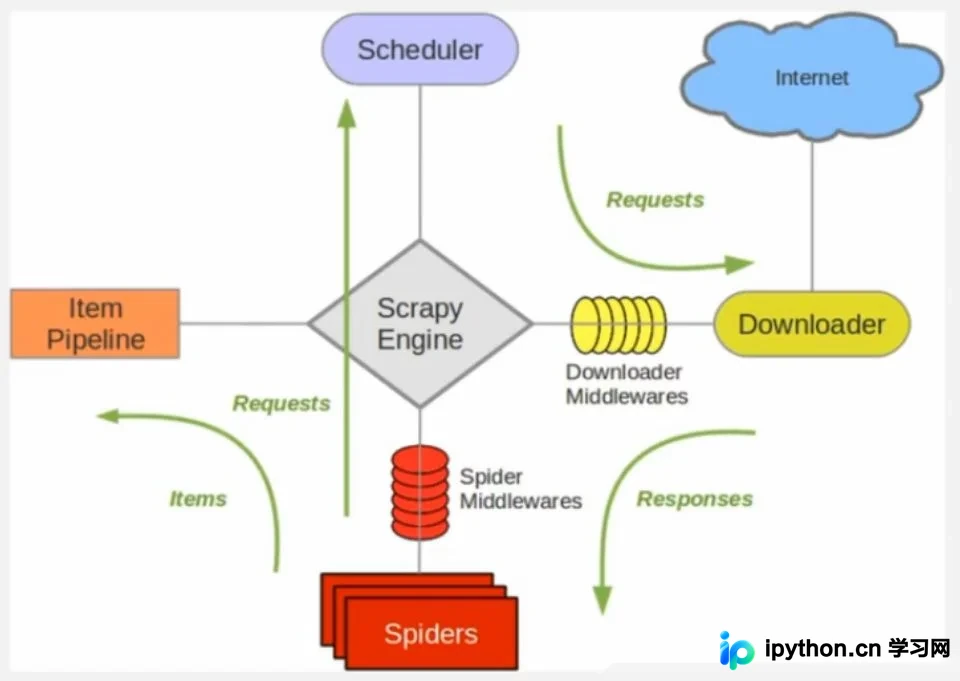
本文深入解析Scrapy-Redis分布式爬虫的核心原理与搭建流程。通过对比Scrapy与Scrapy-Redis的架构图,详细阐述Master端与Slaver端的协作机制,包括URL指纹判重、Request分配及数据存储策略。同时提供从环境配置、依赖安装到代码编写的完整实操指南,帮助开发者高效构建高性能分布式数据采集系统。
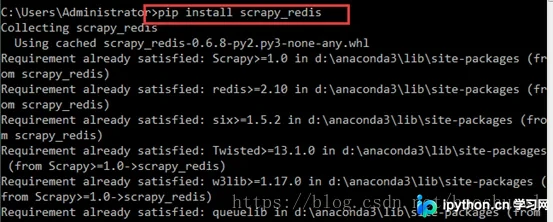
本文详细介绍如何利用scrapy_redis库将Scrapy爬虫升级为分布式架构。内容涵盖环境准备、Settings配置修改、Spider类重写以及Redis数据源注入等关键步骤,帮助开发者实现多台服务器共享URL去重与数据存储,提升爬取效率。
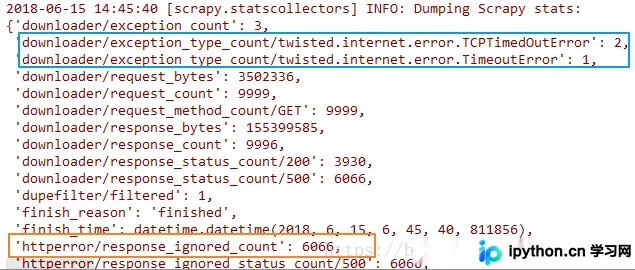
本文详解Scrapy中处理下载错误的两种主要场景:HTTP状态码异常(如403/500)与代码执行异常。通过深入分析RetryMiddleware源码,揭示process_response与process_exception的工作机制,并提供一个自定义中间件模板,用于兜底捕获未重试成功的请求,确保爬虫在长时间运行时的稳定性与数据完整性。