

Scrapy结合ADBAPI实现MySQL异步数据存储

本文详解如何利用Scrapy框架结合Twisted的ADBAPI实现MySQL数据库的异步写入。通过对比同步操作的局限性,阐述了在高并发爬虫场景下使用异步机制避免数据库崩溃的必要性。文章提供了从Item解析、Pipeline配置到Settings设置的完整代码示例,展示如何高效处理大量数据入库。
Scrapy结合ADBAPI实现MySQL异步数据存储
此前我们探讨了Scrapy爬虫的相关话题,今天将重点介绍如何将通过Scrapy抓取的数据持久化保存到MySQL数据库中。
异步存储的必要性
关于Python操作MySQL的资料在网络上已非常丰富,但多数示例仅演示同步操作模式。当数据规模较小时,同步方式尚可应对;然而随着数据量激增,由于爬虫抓取速度远超数据库插入速度,MySQL极易因负载过高而崩溃。为解决这一性能瓶颈,采用异步存储机制成为必要选择,从而实现爬虫抓取与数据存储的解耦,互不阻塞。
为简化演示流程,我们将程序逻辑精简,仅抓取单一页面的数据。本次示例选取伯乐在线网站作为目标,专门针对其第一页内容进行爬取。
爬虫代码实现
首先需启动Scrapy项目,并创建名为jobbole.py的爬虫文件。接下来查看该文件的具体代码实现。
# -*- coding: utf-8 -*-
import io
import sys
import scrapy
import re
import datetime
from scrapy.http import Request
from urllib import parse
from ArticleSpider.items import JobboleArticleItem, ArticleItemLoader
from scrapy.loader import ItemLoader
sys.stdout = io.TextIOWrapper(sys.stdout.buffer,encoding='utf-8')

class JobboleSpider(scrapy.Spider):
 """docstring for JobboleSpider"""
 name = "jobbole"
 allowed_domain = ["blog.jobbole.com"]
 start_urls = ['http://blog.jobbole.com/all-posts/']

 def parse(self, response):
 """
 1.获取列表页中的文章url
 """
 # 解析列表汇中所有文章url并交给scrapy下载器并进行解析
 post_nodes = response.css("#archive .floated-thumb .post-thumb a")
 for post_node in post_nodes:
 image_url = post_node.css("img::attr(src)").extract_first("")# 这里取出每篇文章的封面图,并作为meta传入Request
 post_url = post_node.css("::attr(href)").extract_first("")
 yield Request(url = parse.urljoin(response.url, post_url), meta = {"front_image_url":image_url}, callback = self.parse_detail)

 def parse_detail(self, response):
 article_item = JobboleArticleItem()
 # 通过ItemLoader加载Item
 # 通过add_css后的返回值都是list型,所有我们再items.py要进行处理
 item_loader = ArticleItemLoader(item = JobboleArticleItem(), response = response)
 item_loader.add_css("title", ".entry-header h1::text")
 item_loader.add_value("url", response.url)
 # item_loader.add_value("url_object_id", get_md5(response.url))
 item_loader.add_value("url_object_id", response.url)
 item_loader.add_css("create_date", "p.entry-meta-hide-on-mobile::text")
 item_loader.add_value("front_image_url", [front_image_url])
 item_loader.add_css("praise_nums", ".vote-post-up h10::text")
 item_loader.add_css("comment_nums", "a[href='#article-comment'] span::text")
 item_loader.add_css("fav_nums", ".bookmark-btn::text")
 item_loader.add_css("tags", "p.entry-meta-hide-on-mobile a::text")
 item_loader.add_css("content", "div.entry")

 article_item = item_loader.load_item()
 print(article_item["tags"])

 yield article_item
 pass
此处对代码进行了简化处理:首先向列表页发起请求,限定仅抓取一页数据;随后解析各文章URL,并交由Scrapy下载器对每个URL发起请求以获取文章详情页。最终,将详情页提取的内容存入MySQL数据库。 解析环节采用ItemLoader,其核心优势在于支持将解析规则存储于数据库中,进而实现解析规则的动态加载。需注意,ItemLoader通过CSS或XPath提取的数据均为列表类型,因此需在items.py中对相关数据进行后续处理。
Item数据处理与解析
接下来分析items.py中如何处理列表类型的数据。
# -*- coding: utf-8 -*-

# Define here the models for your scraped items
#
# See documentation in:
# https://doc.scrapy.org/en/latest/topics/items.html
import datetime
import re


import scrapy
from scrapy.loader import ItemLoader
from scrapy.loader.processors import MapCompose, TakeFirst,Join
from ArticleSpider.utils.common import get_md5


def convert_date(value):
 try:
 create_date = datetime.datetime.strptime(create_date, "%Y/%m/%d").date()
 except Exception as e:
 create_date = datetime.datetime.now().date()
 return create_date

def get_nums(value):
 match_re = re.match(".*?(\d+).*", value)
 if match_re:
 nums = int(match_re.group(1))
 else:
 nums = 0

 return nums

def remove_comment_tags(value):
 # 去掉tags中的评论内容
 if "评论" in value:
 # 这里做了修改,如果返回"",则在list中仍然会占位,会变成类似于["程序员",,"解锁"]这样
 # return ""
 return None
 else:
 return value

def return_value(value):
 return

class ArticleItemLoader(ItemLoader):
 """docstring for AriticleItemLoader"""
 # 自定义ItemLoader
 default_output_processor = TakeFirst()

class ArticlespiderItem(scrapy.Item):
 # define the fields for your item here like:
 # name = scrapy.Field()
 pass

class JobboleArticleItem(scrapy.Item):
 """docstring for ArticlespiderItem"""
 title = scrapy.Field()
 create_date = scrapy.Field(
 input_processor = MapCompose(convert_date)
 )
 url = scrapy.Field()
 url_object_id = scrapy.Field(
 output_processor = MapCompose(get_md5)
 )
 # 这里注意front_image_url还是一个list,在进行sql语句时还需要处理
 front_image_url = scrapy.Field(
 output_processor = MapCompose(return_value)
 )
 front_image_path = scrapy.Field()
 praise_nums = scrapy.Field(
 input_processor = MapCompose(get_nums)
 )
 comment_nums = scrapy.Field(
 input_processor = MapCompose(get_nums)
 )
 fav_nums = scrapy.Field(
 input_processor = MapCompose(get_nums)
 )
 # tags要做另行处理,因为tags我们需要的就是list
 tags = scrapy.Field(
 input_processor = MapCompose(remove_comment_tags),
 output_processor = Join(",")
 )
 content = scrapy.Field()
代码中定义了一个ArticleItemLoader类,该类仅包含一行核心逻辑:默认提取每个Item列表中的第一个元素,以此获取具体数值。但需注意,部分场景必须保留列表类型,例如ImagePipeline要求输入数据为列表形式,因此front_image_url字段需单独处理。此处采取的技巧是对front_image_url不做额外处理,因为传入的数据本身已是列表类型。 在Item的Field定义中,包含input_processor和output_processor两个参数,用于对列表元素进行加工。例如,某些字段需通过MD5加密,部分需利用正则表达式进行筛选或排序等。
在配置MySQL Pipeline之前,需先设计数据库结构。以下是参考设计的数据库字段方案。
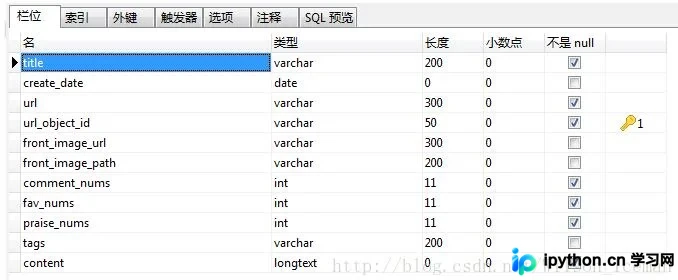
此处将url_object_id设为主键,因其具备唯一性且不会重复,适合作为主键使用。
MySQL Pipeline配置
接下来详细查看数据库Pipeline的具体实现。
# -*- coding: utf-8 -*-

# Define your item pipelines here
#
# Don't forget to add your pipeline to the ITEM_PIPELINES setting
# See: https://doc.scrapy.org/en/latest/topics/item-pipeline.html
import codecs
import json
from twisted.enterprise import adbapi
import MySQLdb
import MySQLdb.cursors


class MysqlTwistedPipeline(object):
 """docstring for MysqlTwistedPipeline"""
 #采用异步的机制写入mysql
 def __init__(self, dbpool):
 self.dbpool = dbpool

 @classmethod
 def from_settings(cls, settings):
 dbparms = dict(
 host = settings["MYSQL_HOST"],
 db = settings["MYSQL_DBNAME"],
 user = settings["MYSQL_USER"],
 passwd = settings["MYSQL_PASSWORD"],
 charset='utf8',
 cursorclass=MySQLdb.cursors.DictCursor,
 use_unicode=True,
 )
 dbpool = adbapi.ConnectionPool("MySQLdb", **dbparms)

 return cls(dbpool)

 def process_item(self, item, spider):
 #使用twisted将mysql插入变成异步执行
 query = self.dbpool.runInteraction(self.do_insert, item)
 query.addErrback(self.handle_error, item, spider) #处理异常
 return item

 def handle_error(self, failure, item, spider):
 # 处理异步插入的异常
 print (failure)

 def do_insert(self, cursor, item):
 #执行具体的插入
 #根据不同的item 构建不同的sql语句并插入到mysql中
 # insert_sql, params = item.get_insert_sql()
 # print (insert_sql, params)
 # cursor.execute(insert_sql, params)
 insert_sql = """
 insert into jobbole_article(title, url, create_date, fav_nums, url_object_id)
 VALUES (%s, %s, %s, %s, %s)
 """
 # 可以只使用execute,而不需要再使用commit函数
 cursor.execute(insert_sql, (item["title"], item["url"], item["create_date"], item["fav_nums"], item["url_object_id"]))
本示例仅演示插入5个字段的数据,分别为title、url、create_date、fav_nums以及url_object_id。
根据实际需求,您也可以扩展插入其他字段。
首先分析from_settings函数,该函数负责从settings.py中读取配置数据,包括数据库的host、dbname、username和password。实际的插入逻辑封装在do_insert函数中,并将其传递给dbpool以执行真正的数据插入操作。
最后查看settings.py的配置代码,此处配置较为简洁。
MYSQL_HOST = "localhost"
MYSQL_DBNAME = "article_wilson"
MYSQL_USER = "root"
MYSQL_PASSWORD = "root"
此处的配置与Pipeline代码相互对应,务必确保在settings.py中正确启用该Pipeline。
ITEM_PIPELINES = {
 # 'ArticleSpider.pipelines.ArticlespiderPipeline': 300,
 # 'ArticleSpider.pipelines.JsonWithEncodingPipeline': 1

 # # 'scrapy.pipelines.images.ImagePipeline': 1,
 # 'ArticleSpider.pipelines.JsonExporterPipleline': 1
 # 'ArticleSpider.pipelines.ArticleImagePipeline': 2
 # 'ArticleSpider.pipelines.MysqlPipeline': 1
 'ArticleSpider.pipelines.MysqlTwistedPipeline': 1
}
程序运行与测试
配置完成后,即可运行程序进行测试。
执行命令:scrapy crawl jobbole
以下是程序运行结果的截图展示。
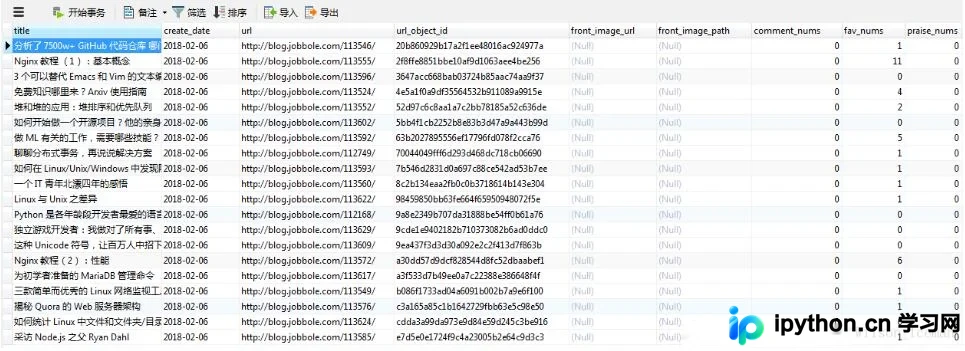
至此,本文的全部内容介绍完毕。
希望本文的内容能对各位的学习有所帮助,欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









