

Python3 Scrapy爬虫框架IP代理配置实战:解决阿里云代理参数变更问题

本文详细讲解在Python3 Scrapy框架中配置IP代理的方法。针对阿里云IP代理参数变更及公共IP池不可用的问题,提出结合阿里云API生成有效IP池并在middlewares.py中通过process_request动态设置request.meta['Proxy-Authorization']的解决方案,确保爬虫稳定运行。
Scrapy框架简介
Scrapy是什么?
Scrapy是一个专注于爬取网站数据并提取结构化信息的应用框架,在开发者群体中享有极高声誉且功能强大。所谓框架,是指已经集成了高性能异步下载、队列管理、分布式支持、数据解析及持久化等多种核心功能的高通用性项目模板。学习框架的核心在于掌握其特性及各功能模块的具体用法。
IP代理配置背景与痛点
一、背景
在开发爬虫项目时,IP代理配置常遇瓶颈。网络上常见的解决方案主要依赖阿里云IP代理或搜集公共IP资源并写入setting文件,但这两种方式均存在明显缺陷。
第一种方法是配置阿里云IP代理,网上教程多指导用户配置用户名和密码并进行加解密处理。然而实际操作发现,新版阿里云IP代理参数中已不再包含用户名和密码相关配置项,导致旧教程失效。
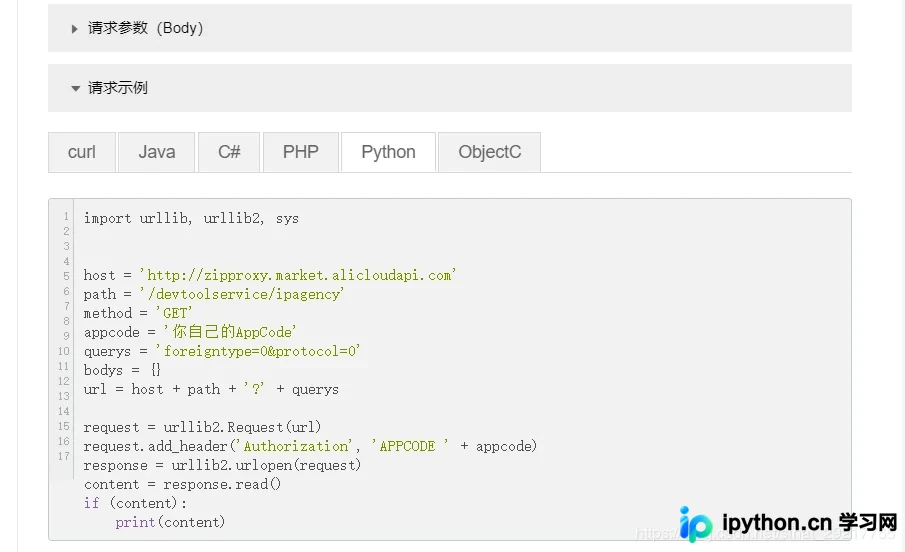
第二种常见做法是在setting文件中添加代理IP资源池,并在middlewares.py文件中编写相应代码实现代理切换。但该方法的痛点在于,网上搜集的公共IP资源往往不可用,导致请求失败。
基于阿里云API的改进方案
二、改进方法
鉴于上述两种现有方法的局限性,本文提出一种综合改进方案。
具体改进策略如下:
1)利用阿里云IP代理API生成包含50个代理IP的资源池。通过登录个人阿里云账号生成,确保IP的有效性得到官方保障。
2)直接在middlewares.py文件中添加特定函数。其中PROXIES变量存储从阿里云生成的IP地址,出于隐私保护考虑,具体IP地址以****代替。
Middlewares代码实现
class my_proxy(object):
  def process_request(self, request, spider):
    PROXIES = ['http://****.****.****.****:8080']
    ip = random.choice(PROXIES)
    request.meta['Proxy-Authorization'] = ip
注意:request.meta字典中使用的键名必须准确无误,否则代理功能将无法正常运行。
注意事项与总结
总结
以上内容介绍了Python3 Scrapy爬虫框架中IP代理的配置方法,希望能对读者有所帮助。如有任何疑问,欢迎留言交流,小编将及时回复。感谢大家对本站的支持!若本文对您有帮助,欢迎转载,请注明出处,谢谢!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









