Python协程并发处理:基于gevent与Queue的实战解析
本文详细解析Python中使用gevent库实现协程并发的两种模式。通过对比直接spawn任务与结合Queue队列管理的两种方式,展示如何利用monkey.patch_all()实现非阻塞I/O。代码涵盖从导入模块、定义URL列表到执行并发请求及耗时统计的完整流程,适用于提升网络请求效率的开发者参考。
2026-10-13
9

本文详细解析Python中使用gevent库实现协程并发的两种模式。通过对比直接spawn任务与结合Queue队列管理的两种方式,展示如何利用monkey.patch_all()实现非阻塞I/O。代码涵盖从导入模块、定义URL列表到执行并发请求及耗时统计的完整流程,适用于提升网络请求效率的开发者参考。
本文详解Python中urllib模块的核心用法,涵盖urlopen发起请求、Request设置User-Agent伪装、urlencode处理查询参数及quote编码等关键步骤。通过百度贴吧多页数据抓取的完整案例,演示如何构建爬虫类、拼接URL并保存HTML文件,帮助开发者掌握基础网络数据采集技能。
本文系统梳理Python爬虫工程师面试中的核心问题,涵盖if __name__机制、Python内存管理(引用计数与垃圾回收)、对象拷贝差异、异常处理、常用爬虫库对比及反爬应对方案。深入解析Django与Flask选型、多线程异步优化、POST/GET区别及Lambda表达式,为求职者提供实用的技术参考。
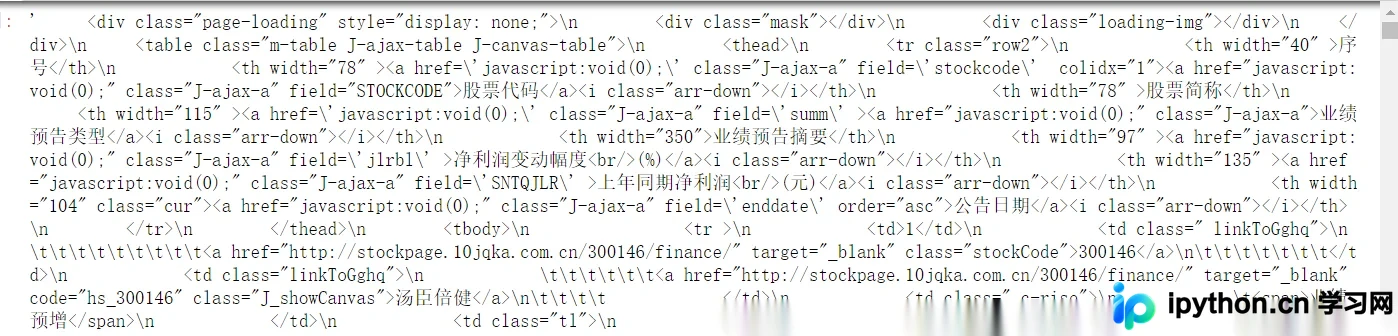
本文详解利用Python从同花顺财经抓取业绩预告数据的全过程。通过requests获取HTML源码,结合正则表达式提取股票代码、净利润及增长幅度,构建DataFrame进行数据清洗。最后使用Matplotlib绘制饼图,直观展示148家公司的盈利与亏损分布情况,为财务数据分析提供可视化参考。
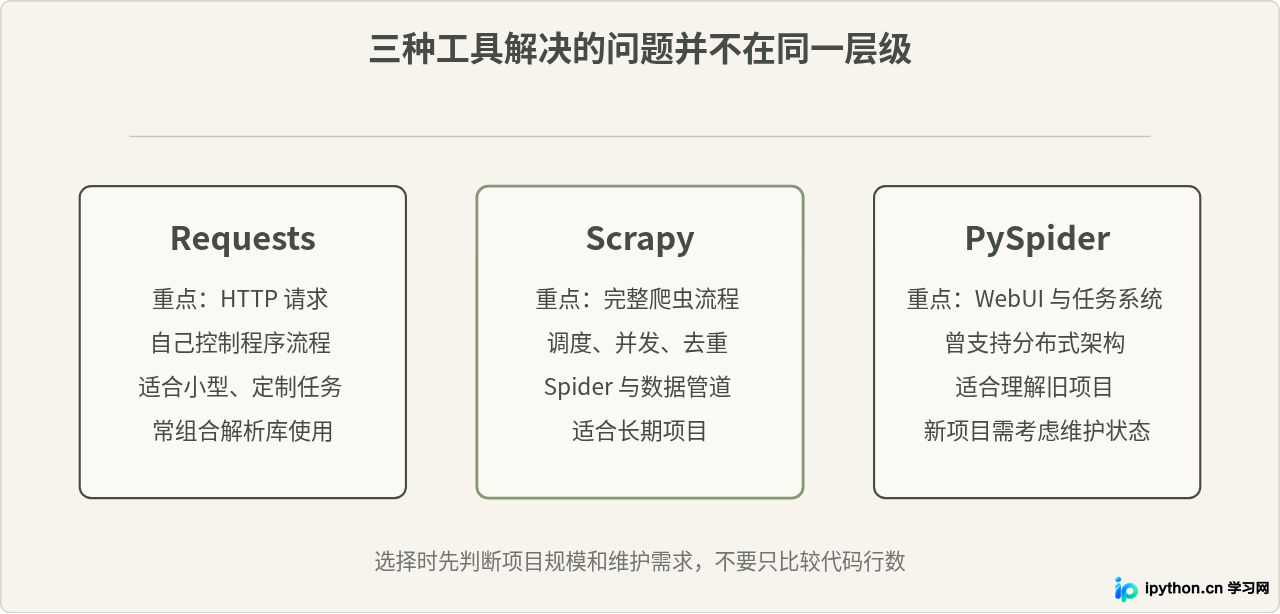
对比Python爬虫常见的Requests、Scrapy与PySpider,从学习成本、并发抓取、任务调度、数据处理、项目维护和适用场景等方面说明区别,并给出不同爬虫项目的选择方法。
本文总结了在Python中清洗小说数据时去除HTML标签的三种常用方法。通过对比正则表达式、BeautifulSoup解析器以及lxml库的实际代码示例,展示了如何从混杂HTML的字符串中提取纯文本。此外,还介绍了利用正则表达式移除HTML标签属性的技巧,帮助开发者快速实现数据清洗。
教你使用 Python 的 requests 与 BeautifulSoup 编写第一个网页爬虫,步骤详尽,示例完整。
本文详解Python爬虫中的三大核心要素:IP代理(透明、匿名、高匿)用于规避频率限制;Cookie机制解决HTTP无状态问题,通过MozillaCookieJar实现持久化存储;以及urllib.error模块对URLError和HTTPError的捕获与属性解析,帮助开发者构建稳定的网络请求程序。
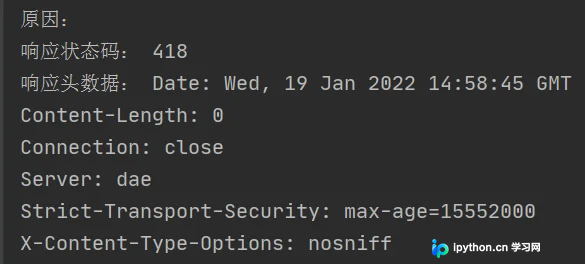
本文详细解析起点中文网月票榜的字体反爬机制,通过Python结合requests、lxml和fonttools库,实现从HTML中提取加密字体文件,解析Unicode编码映射关系,最终还原书名与月票数。教程涵盖XPath定位、正则提取及字体文件动态加载,提供完整代码示例与常见错误排查。
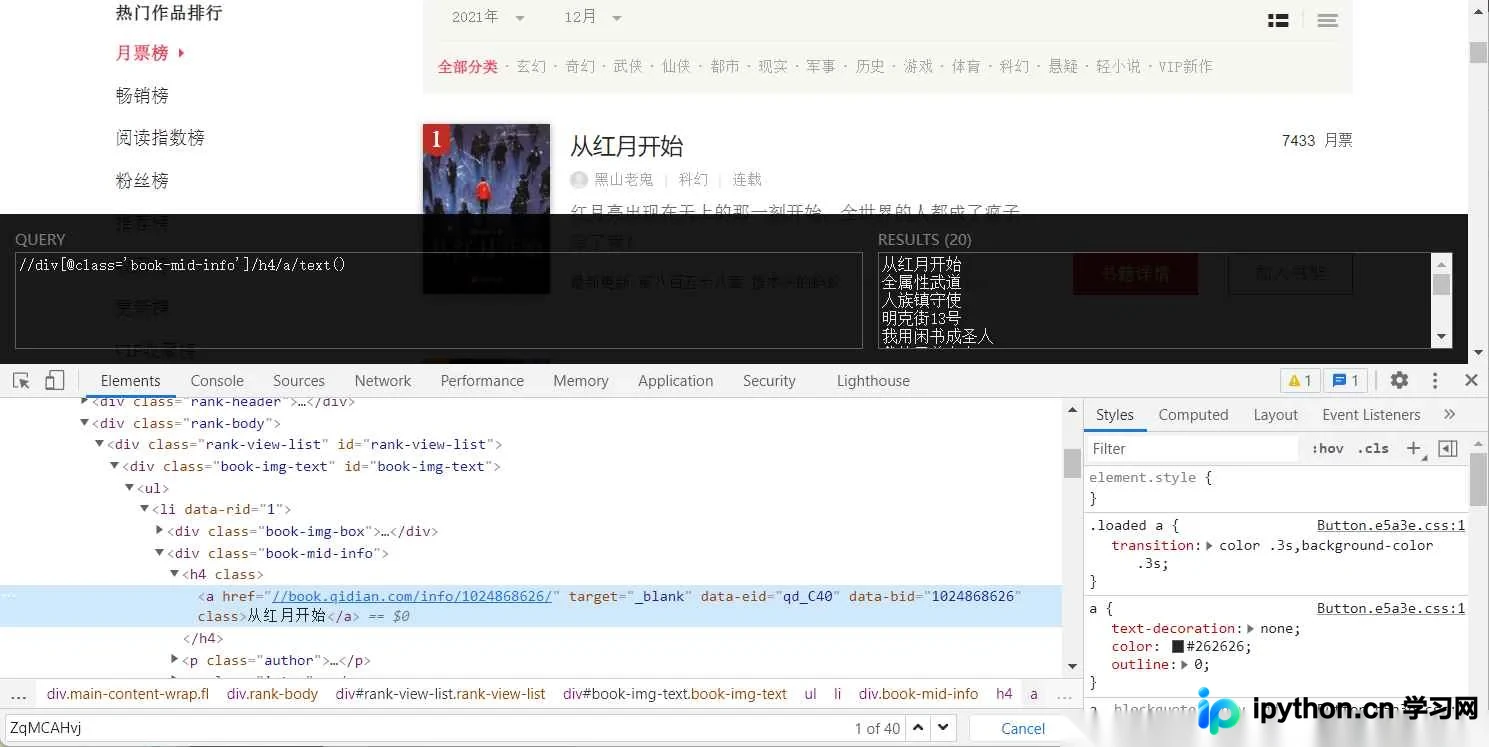
本文详细介绍Scrapy框架中代理中间件的使用与自定义方法。涵盖HttpProxyMiddleware的默认配置、通过Request meta参数设置代理、抓取快代理IP并验证可用性,以及继承HttpProxyMiddleware和直接编写中间件类两种自定义实现方案,帮助开发者解决IP被封或访问受限问题。
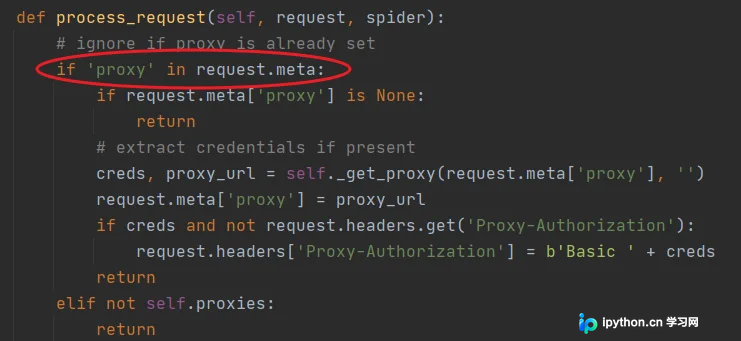
本文详细解析Python异步爬虫中处理多个URL请求时的性能优化方案。通过对比单线程阻塞、多线程及线程池三种方式,展示了如何利用并发机制减少等待时间。重点介绍了线程池在降低系统开销方面的优势,并提供了具体的代码示例与运行结果分析,帮助开发者选择合适的并发策略。
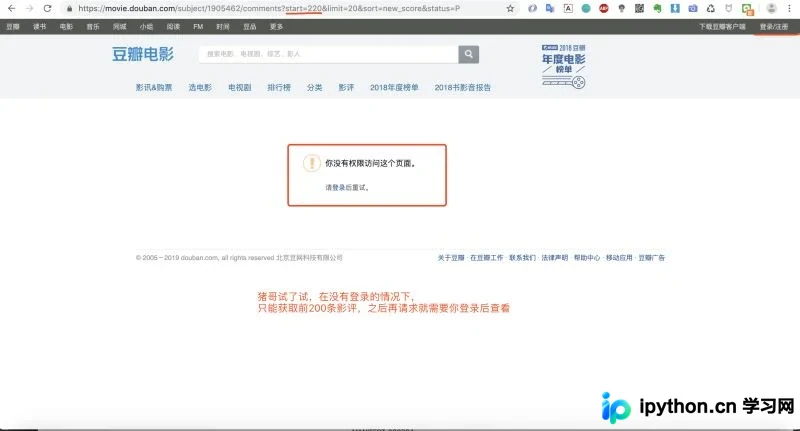
本文详解如何使用Python的requests库实现豆瓣登录及会话状态保持,通过Session对象自动管理Cookie,进而批量抓取《荒野生存》影评数据。结合正则表达式提取内容,利用结巴分词与词云库进行数据分析,完整展示从登录接口分析到数据可视化的全流程。