

Windows环境下Python自动化部署:定时任务与Selenium实战
本文详细介绍在Windows系统中利用Python脚本结合Selenium库实现自动化数据采集与更新的方法。内容涵盖通过psutil监控Chrome进程状态、处理长时间未生成数据的异常退出机制,以及利用Windows计划任务实现脚本的周期性自动执行。此外,还包含基于日志的企业微信错误报警集成方案,确保自动化流程的稳定运行。
2026-10-16
9

本文详细介绍在Windows系统中利用Python脚本结合Selenium库实现自动化数据采集与更新的方法。内容涵盖通过psutil监控Chrome进程状态、处理长时间未生成数据的异常退出机制,以及利用Windows计划任务实现脚本的周期性自动执行。此外,还包含基于日志的企业微信错误报警集成方案,确保自动化流程的稳定运行。
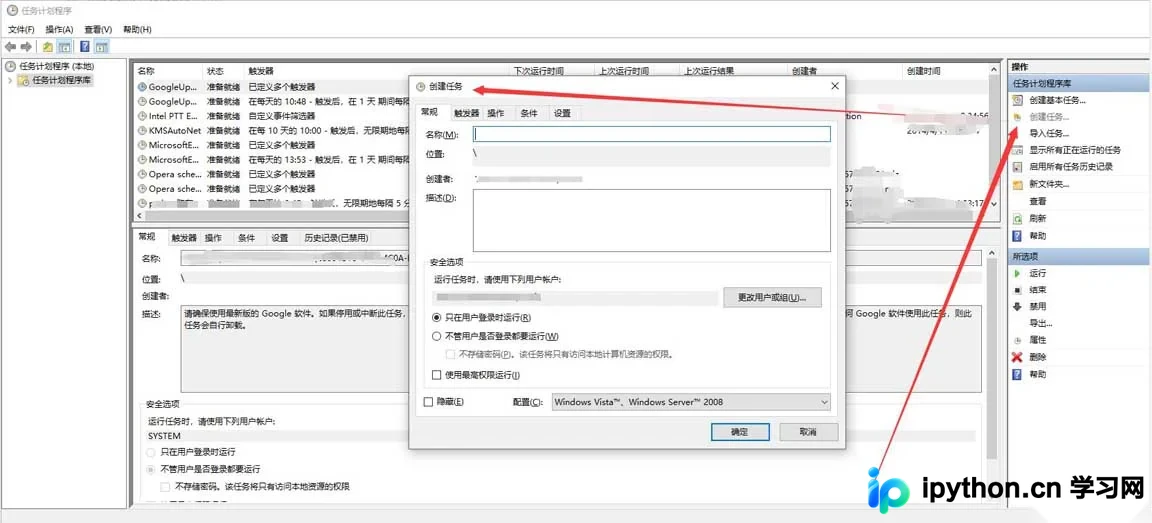
本文详解如何在Python爬虫中通过百度智能云文字识别API解决图片验证码问题。内容涵盖从创建应用获取凭证、安装baidu-aip库,到使用Pillow库进行图像二值化预处理以提高识别率,最后调用handwriting接口完成自动登录的全过程。
本文详细介绍如何利用Python爬虫技术获取天气通讯社的高温预警数据。通过分析目标网站反爬机制,结合亿牛云代理IP配置示例,帮助开发者有效规避访问限制,提前获取高温、暴雨等气象预警信息,做好防暑防灾准备。
本文详细介绍如何使用Python爬取Pixiv图片。内容涵盖通过抓包分析模拟登录流程,动态获取post_key,利用Session保持状态,以及通过BeautifulSoup和正则表达式提取图片链接。针对Pixiv的防盗链机制,文章提供了处理Referer、动态构建真实图片URL及解决403/404错误的完整代码方案。
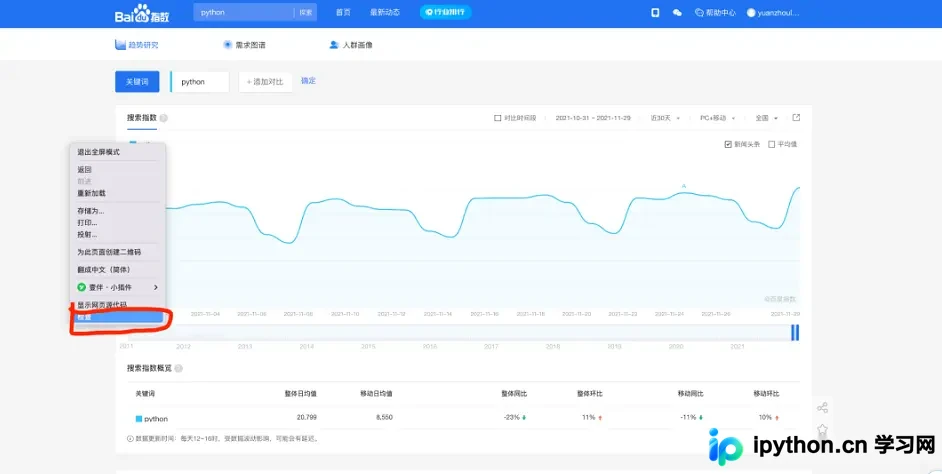
本文介绍如何使用Python脚本获取百度指数数据。通过提取登录Cookie,利用自定义类解析API返回的加密数据,生成Pandas DataFrame。文章包含获取Cookie的步骤、核心代码示例、数据保存为CSV的方法,以及使用Plotly进行时间序列可视化的完整流程,帮助开发者便捷地获取并分析关键词热度趋势。
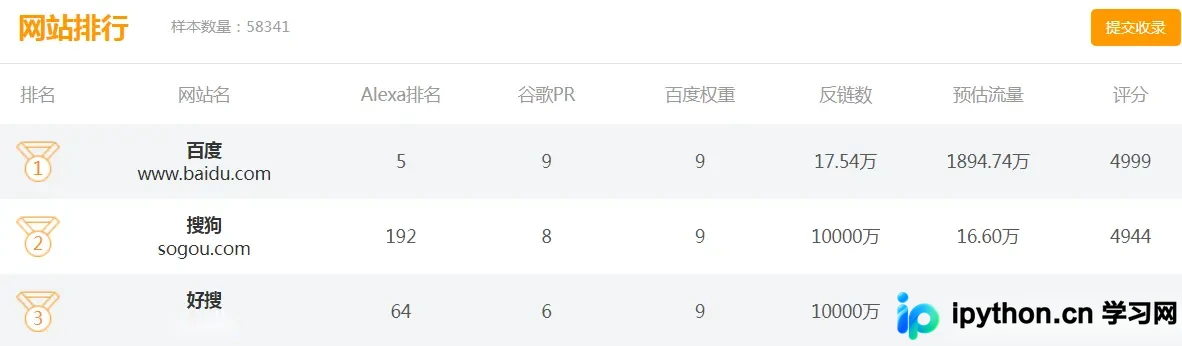
本文详解如何使用Python结合requests、lxml、threading和queue模块,高效爬取中介网网站排行榜。通过多线程生产者-消费者模型,自动解析总页码并批量抓取域名详情页数据,提供完整的逻辑梳理与代码实现参考。
本文详细记录使用Python爬取京东商品信息及评论并存入MySQL的全过程。重点解决了SQLAlchemy中非主键字段无法自增的问题,以及应对京东强反爬机制导致的空白页现象。通过对比多线程与单线程加延时的策略,最终确定单线程逐条爬取是避免被屏蔽的有效方案。
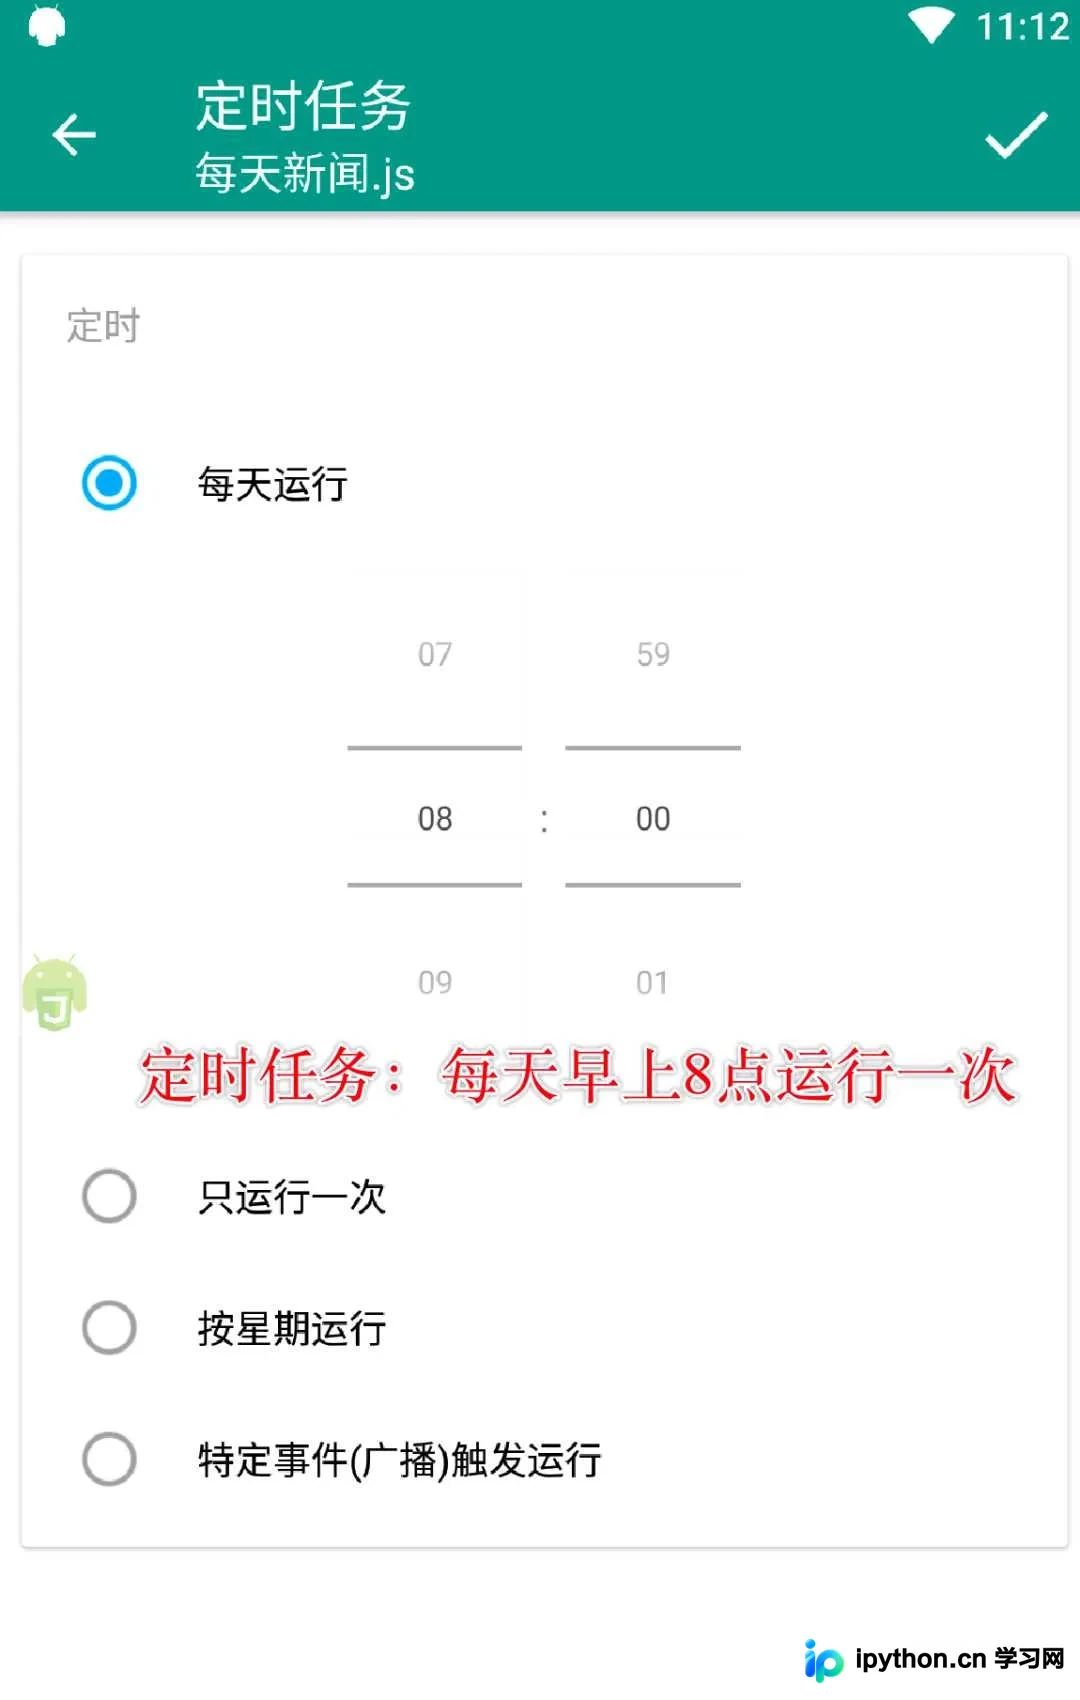
本文介绍一种无需编写原生App或利用无障碍服务即可实现微信群自动发送新闻早报的方案。通过Python结合Requests和FastAPI构建新闻获取接口,再使用AutoJS脚本在Android端调用该接口并自动操作微信发送消息。文章详细展示了从数据爬取、服务部署到脚本编写及定时任务设置的全过程,适用于希望实现自动化办公或信息推送的技术人员。
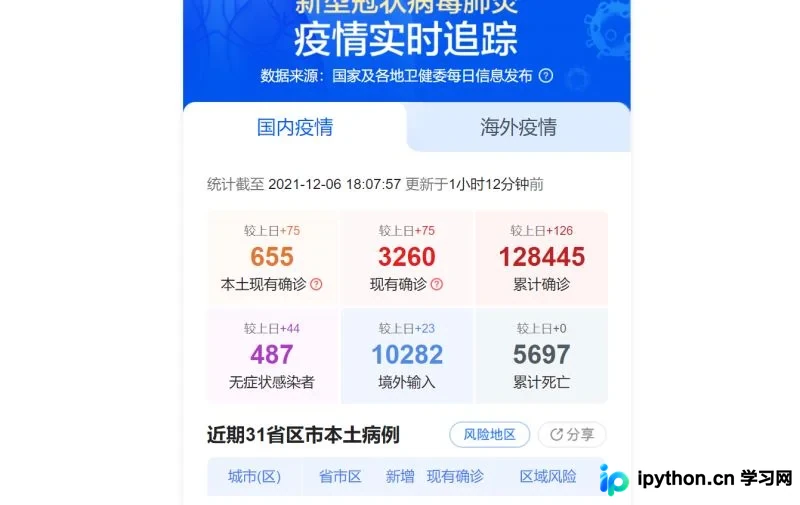
本文详细介绍如何使用Python进行疫情数据爬取与可视化。通过requests获取腾讯接口数据,利用pandas清洗保存,最后使用pyecharts绘制死亡率、治愈率及各地区确诊分布图表,完整展示从数据获取到可视化展示的全流程。
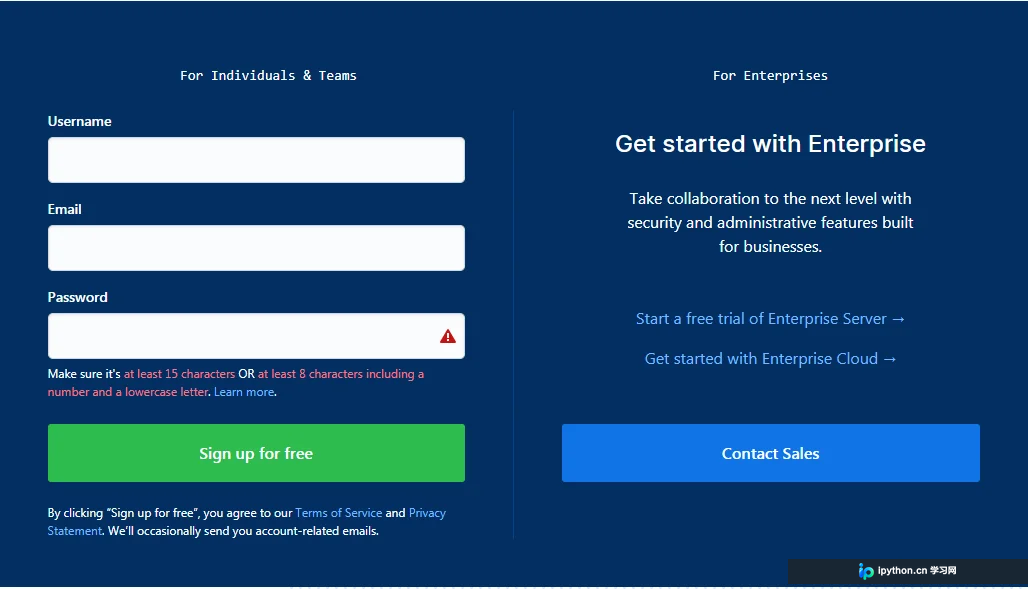
本文详解Scrapy实现模拟登录的两种核心方式:一是直接携带Cookie发起请求,适用于Cookie有效期较长的场景;二是通过发送Post请求获取Cookie,分别介绍scrapy.FormRequest手动构造表单与scrapy.FormRequest.from_response()自动填充表单的方法。结合GitHub登录示例代码,解析如何验证登录状态及处理动态表单字段,帮助开发者高效解决需要登录才能访问的页面爬取问题。
本文介绍如何使用Python的Queue模块结合多线程实现高效的多线程爬虫。通过实例化多个队列分别处理URL、HTML响应和解析内容,利用Queue.task_done()和Queue.join()机制确保线程有序执行与资源释放,实现并发抓取糗事百科数据。
本文详细解析使用Docker部署Python爬虫项目的完整步骤。内容涵盖Docker环境安装、基础镜像拉取、Python运行环境编译、依赖库处理、Dockerfile编写规范、镜像构建命令及容器启动参数配置,帮助开发者实现爬虫项目的标准化与自动化部署。