Scrapy爬取结果导出为Excel的实现方法
本文详细介绍如何使用Scrapy框架将爬取数据导出为Excel格式。通过定义Item实体类、配置CsvItemExporter以及注册Pipeline,实现数据的结构化存储。文章涵盖环境要求、核心代码实现及爬虫运行步骤,帮助开发者快速掌握Scrapy数据导出功能。
2026-10-16
7

本文详细介绍如何使用Scrapy框架将爬取数据导出为Excel格式。通过定义Item实体类、配置CsvItemExporter以及注册Pipeline,实现数据的结构化存储。文章涵盖环境要求、核心代码实现及爬虫运行步骤,帮助开发者快速掌握Scrapy数据导出功能。
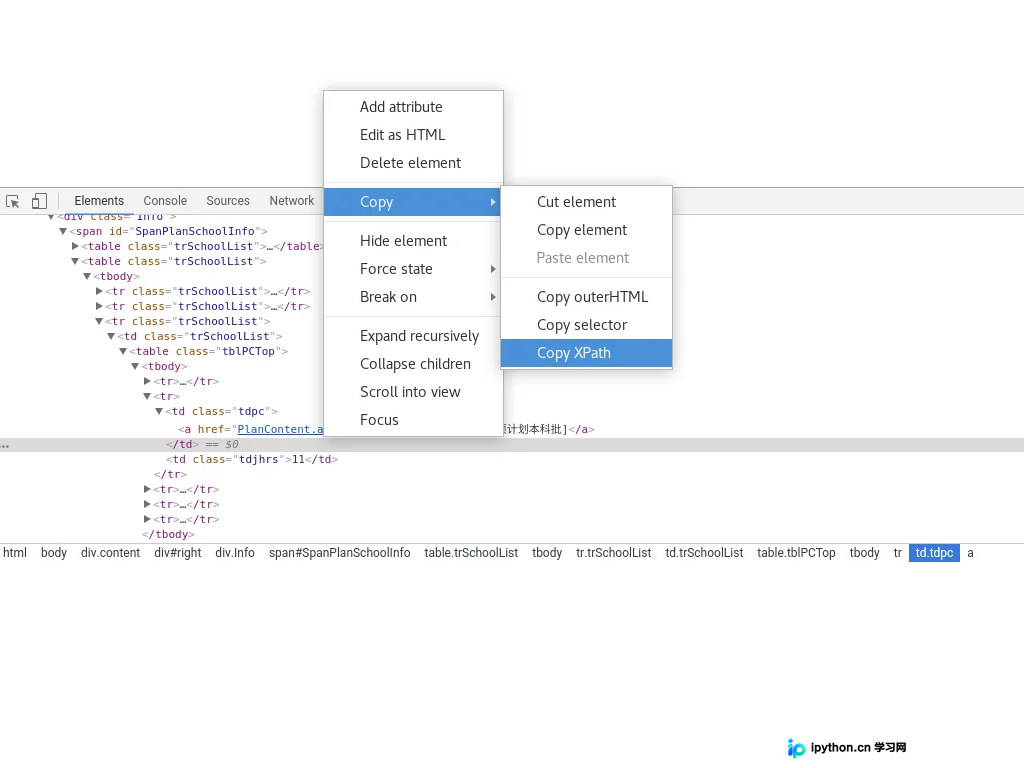
本文分析Scrapy中使用Chrome开发者工具生成的XPath在爬虫中失效的问题。根本原因在于浏览器自动插入tbody标签,而原始HTML结构中可能不存在该标签。通过对比Chrome生成的含tbody XPath与Scrapy实际解析结果,发现需手动移除xpath中的tbody节点。文章提供了使用scrapy shell逐步定位问题的方法,并给出修正后的正确XPath示例,帮助开发者避免此类常见坑点。
本文深入解析Python中五种常见的爬虫框架,包括成熟的Scrapy、高效的Crawley、可视化的Portia、轻量级的Newspaper以及文章提取工具Python-goose。详细对比各框架的功能特点、适用场景及技术优势,帮助开发者根据需求选择合适的爬虫解决方案。
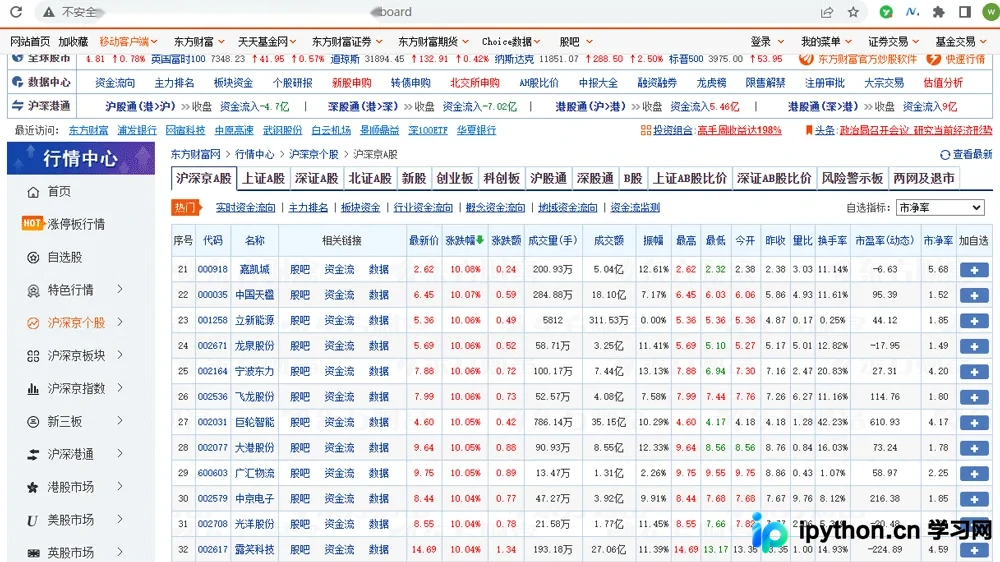
本文详细讲解如何利用Python爬取东方财富网的股票实时数据。通过F12开发者工具分析Ajax动态加载接口,识别关键参数如pn控制页码。针对非标准JSON返回格式进行清洗处理,提取f2至f22等字段含义,并编写Python脚本实现数据解析、存储及多页循环抓取,最终完成股票信息的本地保存。
本文详细解析M3U8视频播放原理,介绍如何利用Python脚本抓取.m3u8索引文件及对应的.ts分片文件。通过requests库获取资源链接,结合os系统命令将多个小体积.ts文件合并为完整的mp4视频。文章提供具体操作步骤、代码示例及注意事项,适用于Windows环境下对特定网站视频资源的抓取与本地保存。
本文详解Python爬虫中urllib模块的异常处理机制。重点解析URLError(主机错误)与HTTPError(路径或参数错误)的区别与捕获顺序,通过具体代码实例演示如何构建健壮的爬虫程序,确保在网络请求失败时能正确识别错误类型并执行相应处理逻辑。
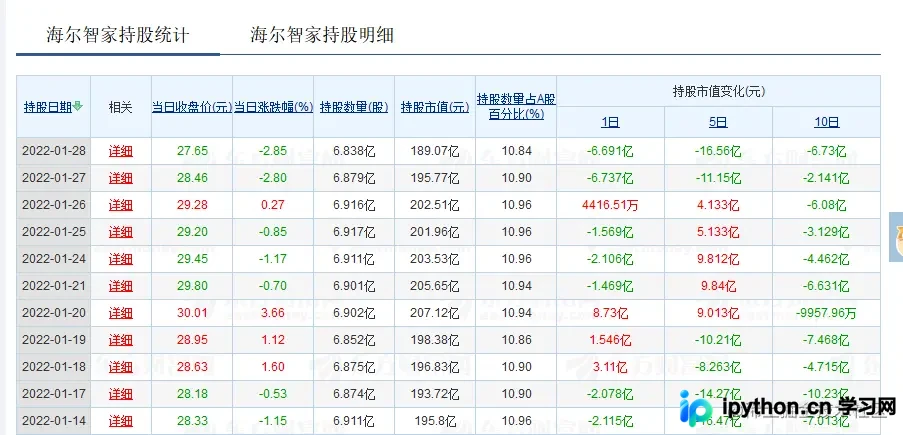
本文详细介绍如何使用Python爬虫技术抓取东方财富网北上资金逐日持仓数据。通过逆向分析API接口参数,利用requests库获取JSON数据,并结合prettyTable进行格式化展示。此外,文章还构建了一个简单的线性筛选模型,用于识别近期连续加仓且幅度超过流通股份1%的股票,为量化分析提供基础参考。
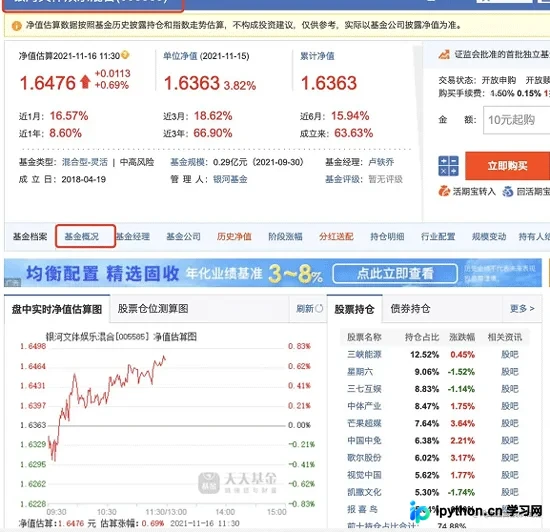
本文详细讲解如何使用Python爬虫获取基金基本信息。针对XPath定位失效的情况,文章演示了如何利用BeautifulSoup库解析HTML页面,通过定位table和td标签提取基金公司、经理、成立时间等关键数据,并展示最终代码实现与结果输出。
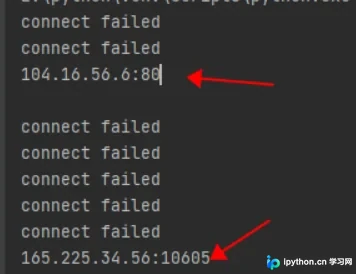
本文介绍如何使用Python构建一个简单的IP代理池。通过requests库从指定网站抓取IP数据,利用正则表达式提取IP和端口,并结合telnetlib库进行连通性测试,筛选出可用的代理IP并保存至文件。
本文详细介绍Python内置urllib库的四大核心模块:urllib.request用于发起HTTP请求,urllib.error处理网络异常,urllib.parse解析与拼接URL,以及urllib.robotparser解析robots.txt。通过对比Python 2与3的差异,演示urlopen、Request对象、代理设置、Cookie处理及参数编码等关键用法,帮助开发者掌握底层网络请求原理。
本文详细介绍Python第三方库requests的基本用法,涵盖安装配置、GET与POST请求、参数传递、JSON解析、文件保存、代理设置、Cookie维持及异常处理等核心功能,帮助开发者快速掌握HTTP客户端操作。
本文介绍如何利用Python爬虫从高德地图获取地铁站点经纬度数据,并通过Arcpy生成Shapefile文件,最终制作出高清无水印的个性化地铁线路图。