

Python异步爬虫中多线程与线程池的对比与实现

发布时间:2026-10-14| 4人浏览过
本文详细解析Python异步爬虫中处理多个URL请求时的性能优化方案。通过对比单线程阻塞、多线程及线程池三种方式,展示了如何利用并发机制减少等待时间。重点介绍了线程池在降低系统开销方面的优势,并提供了具体的代码示例与运行结果分析,帮助开发者选择合适的并发策略。
背景
当需要向多个URL发送请求时,若使用同步方式,必须等待第一个请求完全结束后才能发起第二个请求。由于网络请求通常涉及I/O等待,这种串行执行方式会导致大量时间耗费在等待响应上,整体效率极低。因此,考虑在发送请求并等待响应的同时,单独开启进程或线程来继续处理下一个URL的请求,从而实现并行执行,是提升效率的关键思路。
异步爬虫方式
多线程,多进程(不建议)
主要优势在于:可以为那些涉及I/O阻塞的操作单独创建线程或进程,使得这些阻塞操作能够以异步方式执行,从而避免主线程被长时间占用。
主要劣势在于:无法无限制地创建线程或进程。频繁地创建和销毁进程或线程会消耗大量的系统资源,导致性能下降。
线程池,进程池(适当使用)
主要优势在于:通过复用已创建的线程或进程,可以显著降低系统对线程或进程进行创建和销毁操作的频率,从而有效减少系统开销。
主要劣势在于:线程池或进程池中允许同时存在的线程或进程数量存在上限,这限制了并发能力的无限扩展。
单线程+异步协程(推荐)
多线程
运行以下示例代码需要花费8秒钟的时间。这是因为sleep函数是一个阻塞操作,在等待期间不会执行其他任何操作,这种串行阻塞极大地降低了程序的整体效率。
from time import sleep
import time
start = time.time()
def xx(str):
    print('正在下载:', str)
    sleep(2)
str = ['xiaozi', 'aa', 'bb', 'cc']
for i in str:
    xx(i)
end = time.time()
print('程序运行时间:',end-start)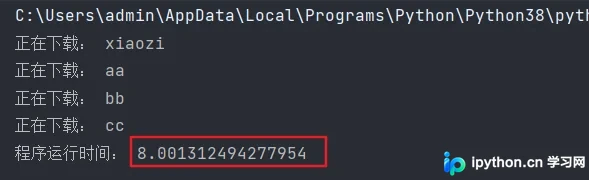
使用多线程后
from threading import Thread
from time import sleep
import time
start = time.time()
def xx(str):
        print('正在下载:',str)
        sleep(2)
str =  ['xiaozi','aa','bb','cc']
def main():
    for s in str:
        #开启线程,target=函数名,args=(xx,) ,xx为向函数传递的参数,必须为元组类型,所以后面需要加,
        t = Thread(target=xx,args=(s,))
        t.start()
if __name__ == '__main__':
    main()
    end = time.time()
    print('程序运行时间:',end-start)
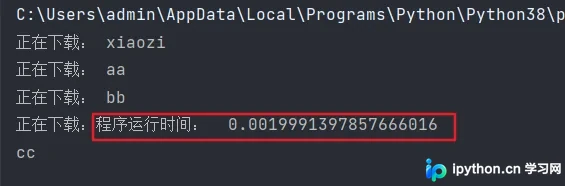
然而,观察运行结果可以发现,输出的顺序似乎有些混乱,这反映了多线程执行的非确定性特征。
线程池
将上述代码改为使用线程池后再次运行。
#倒入线程池模块对应的类
from multiprocessing.dummy import Pool
from time import sleep
import time
start = time.time()
def xx(str):
        print('正在下载:',str)
        sleep(2)
str =  ['xiaozi','aa','bb','cc']
#实例化一个线程池对象,线程池中开辟四个线程对象,并行4个线程处理四个阻塞操作
pool = Pool(4)
#将列表中的每一个列表元素(可迭代对象)传递给xx函数(发生阻塞的操作)进行处理
#map方法会有一个返回值为函数的返回值(一个列表),但是这里没有返回值所以不考虑
#调用map方法
pool.map(xx,str)
end = time.time()
print('程序运行时间:',end-start)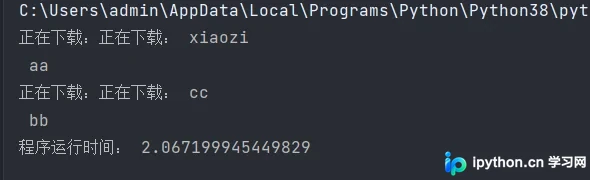
以上就是Python异步爬虫多线程与线程池示例详解的详细内容,更多关于Python异步多线程与线程池的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









